Sớm muộn gì agent của bạn cũng sẽ đưa ra một câu trả lời khiến bạn phải nhíu mày thắc mắc. Dùng sai tài liệu. Bỏ qua công cụ. Hay tự tin đưa ra thông tin sai lệch. Sự khác biệt giữa người mới bắt đầu biết cách khắc phục sự cố trong 5 phút và người phải làm lại từ đầu nằm ở việc hiểu rằng Copilot Studio sẽ hiển thị chính xác những gì đã xảy ra, miễn là bạn biết cần xem ở đâu.
Trong bài học trước, bạn đã thấy việc mô tả công cụ một cách mơ hồ khiến orchestrator bỏ qua công cụ đó. Đó là trải nghiệm đầu tiên của bạn về quy trình gỡ lỗi theo từng lớp. Giờ hãy cùng thực hiện việc này một cách bài bản hơn.
Test Pane là công cụ gỡ lỗi, không phải cửa sổ trò chuyện
Bạn đã sử dụng tính năng Test từ Bài 2. Dưới đây là những tính năng bạn chưa từng dùng đến:
Nhấp vào bất kỳ phản hồi nào của agent, Copilot Studio sẽ chuyển ngay đến chủ đề và node tạo ra phản hồi đó, đồng thời đánh dấu các node đã được kích hoạt bằng dấu tích.
Menu … chứa các công cụ mạnh mẽ: Track between topics (theo dõi cuộc trò chuyện khi nó chuyển đổi qua lại giữa các chủ đề), Show activity map when testing, Save snapshot (file zip chứa dữ liệu chẩn đoán) và Manage connections.
Tab Test trong ngăn Variables hiển thị giá trị thực tế của các biến trong quá trình cuộc trò chuyện diễn ra.
Biểu tượng Reset giúp khởi động lại cuộc trò chuyện - hãy thực hiện thao tác này sau mỗi lần sửa lỗi, vì ngữ cảnh cuộc trò chuyện cũ có thể gây nhiễu kết quả quan sát của bạn.
Điểm nổi bật nhất chính là bản đồ hoạt động (có sẵn trong tính năng điều phối tạo sinh - generative orchestration): Một sơ đồ hiển thị kế hoạch của orchestrator theo từng lượt tương tác. Đối với bước sử dụng kiến thức, nó hiển thị truy vấn tìm kiếm thực tế đã chạy, các nguồn được sử dụng và - thông tin cực kỳ giá trị để gỡ lỗi - những nguồn đã được tìm kiếm nhưng không được sử dụng. Đối với bước sử dụng công cụ, nó hiển thị dữ liệu đầu vào và đầu ra. Tính năng Show rationale (Hiển thị lý do) sẽ cung cấp lời giải thích do AI tạo ra về lý do công cụ đó được chọn. Một lưu ý nhỏ: Bản đồ hoạt động và tính năng theo dõi chủ đề thường "tranh giành" không gian hiển thị; hãy đóng bản đồ lại khi bạn muốn theo dõi luồng chuyển đổi giữa các chủ đề.
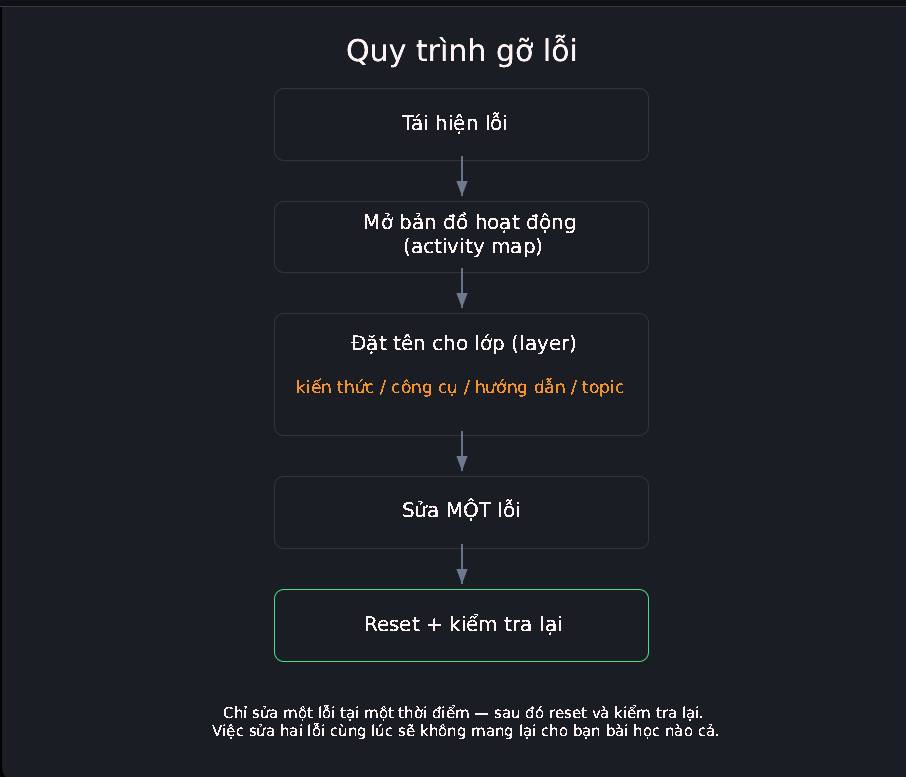
Chẩn đoán theo từng lớp
Mỗi câu trả lời sai đều bắt nguồn từ một trong 4 lớp, và mỗi lớp đều có bài học riêng trong khóa học này:
Thiếu trích dẫn hoặc sai nguồn? Lớp kiến thức (Knowledge layer) - hãy thực hiện danh sách kiểm tra lỗi ngầm của Bài 4 (trạng thái, khả năng tìm thấy, kích thước, nhãn, quyền truy cập).
Công cụ không chạy hoặc chạy với dữ liệu đầu vào lạ? Lớp công cụ (Tool layer) - phần mô tả sẽ định hướng việc lựa chọn công cụ (Bài 6), và bản đồ hoạt động (activity map) sẽ hiển thị những gì AI đã điền vào từng trường dữ liệu đầu vào.
Thông tin đúng nhưng giọng điệu hoặc phạm vi chưa chuẩn? Lớp hướng dẫn (Instructions layer) - hãy siết chặt từng ràng buộc cụ thể (được đánh số) một cách tuần tự (Bài 3).
Cần văn bản nguyên văn nhưng lại nhận được câu diễn giải lại? Nội dung đó nên được đưa vào một chủ đề (Topic) cụ thể (Bài 5).
Kiểm tra nhanh: Bản đồ hoạt động cho thấy nguồn kiến thức của bạn đã được tìm kiếm với từ khóa "annual leave carryover rules" (quy định chuyển tiếp ngày phép năm) nhưng không trả về kết quả nào - trong khi bạn biết file PDF chính sách có đề cập đến vấn đề này. Vấn đề nằm ở lớp nào và bước đầu tiên bạn cần làm là gì?
Đáp án: Lớp kiến thức - kiểm tra xem file PDF đó có thực sự truy xuất được không: Tìm kiếm bằng từ khóa của file, kiểm tra kích thước và nhãn. Orchestrator đã làm đúng nhiệm vụ; chỉ là kết quả truy xuất trả về trống.
Biến lỗi thành thông tin hữu ích
Khi xảy ra sự cố giữa chừng trong cuộc hội thoại, chủ đề hệ thống mặc định "On Error" (Khi có lỗi) thường thông báo cho người dùng: "Xin lỗi, có sự cố bất ngờ xảy ra… Mã lỗi: SystemError" - rồi kết thúc cuộc trò chuyện. Các chuyên gia thường áp dụng cách làm này: Mở mục Topics → System → On Error, thay thế thông báo đó bằng một lời nhắn thân thiện như "Có chút trục trặc - vui lòng thử lại sau một lát hoặc gửi email cho chúng tôi tại [địa chỉ email]"; đồng thời, trong quá trình xây dựng, hãy lưu ý rằng các chi tiết lỗi (như mã lỗi) vẫn hiển thị với bạn khi kiểm thử. Chỉ mất 5 phút thực hiện, và agent của bạn sẽ không còn gặp sự cố nghiêm trọng trước mặt người dùng nữa.
Kiểm thử trên quy mô lớn: Trang Evaluation
Kiểm thử thủ công có những hạn chế nhất định: bạn chỉ đặt những câu hỏi mà mình nghĩ ra, theo cách diễn đạt của riêng mình. Trang Evaluation giúp vượt qua giới hạn đó. Hãy chọn New evaluation và tạo một bộ câu hỏi kiểm thử gồm tối đa 100 câu - Copilot Studio có thể tự động tạo nhanh bộ 10 câu hỏi dựa trên nguồn kiến thức của bạn, hoặc bạn có thể nhập file hay tái sử dụng các cuộc hội thoại kiểm thử trước đó. Mỗi lần chạy đánh giá sẽ chấm điểm câu trả lời dựa trên các tiêu chí như: General quality, Compare meaning (so với câu trả lời mẫu do bạn cung cấp) và Tool use. Kết quả sẽ được lưu trữ trong 89 ngày; xuất những gì bạn muốn giữ lại.
Soạn thảo bộ dữ liệu kiểm thử thực tế đầu tiên của bạn.
Nơi dán nội dung: Tạo file trong bất kỳ trình soạn thảo văn bản nào ngay bây giờ; nhập file đó vào trang Evaluation → New evaluation khi bạn đã sẵn sàng.
Sao chép cấu trúc câu lệnh (prompt) này:
Câu hỏi, Phản hồi mong đợi
"Làm thế nào để thêm một trang web công khai làm nguồn kiến thức?","Thêm kiến thức tại
trang Overview, chọn Public websites, nhập URL với độ sâu tối đa hai cấp"
"[Một câu hỏi thực tế từ đồng nghiệp, giữ nguyên cách diễn đạt của họ]","[Câu trả lời bạn
chấp nhận, dài một hoặc hai câu]"
"[Một câu hỏi mà agent của bạn phải từ chối]","[Câu từ chối hoặc điều hướng mà bạn mong đợi]"
Điền thông tin chi tiết của bạn: Thay thế các dòng trong ngoặc vuông bằng ít nhất 8 câu hỏi thực tế - hãy lấy chúng từ các email và tin nhắn trò chuyện thực tế, giữ nguyên cách diễn đạt của đồng nghiệp. Cách diễn đạt thực tế chính là yếu tố quan trọng nhất.
Kết quả hiển thị: Sau khi chạy đánh giá, bạn sẽ thấy một danh sách có chấm điểm - đạt/không đạt hoặc tỷ lệ phần trăm cho mỗi câu hỏi - cho biết chính xác những cách diễn đạt thực tế nào khiến agent của bạn gặp khó khăn.
Nếu kết quả không như ý: Các câu hỏi bị chấm điểm thấp ở mục Compare meaning (So sánh ý nghĩa) đôi khi chỉ do câu trả lời mong đợi quá chi tiết hoặc cụ thể. Hãy nới lỏng nội dung mong đợi, chỉ tập trung vào các thông tin cốt lõi, và chạy lại trước khi đổ lỗi cho agent.
Kiểm tra nhanh: Tại sao nên xây dựng bộ dữ liệu kiểm thử từ email thực tế của đồng nghiệp thay vì tự viết câu hỏi?
Trả lời: Bạn thường vô thức đặt câu hỏi theo cách diễn đạt của tài liệu - trong khi đồng nghiệp thì không. Khả năng truy xuất thông tin chính xác bất chấp cách diễn đạt thực tế mới là điều đáng để kiểm thử.
Một lưu ý quan trọng trước bước hoàn thiện cuối cùng
Bảng kiểm thử đưa ra kết quả trung thực nhưng chưa đầy đủ: nó không hiển thị các câu lệnh gợi ý, không kích hoạt những hành vi dựa trên thời gian, và luôn chạy dưới danh nghĩa của bạn - với các quyền hạn của bạn. Tình trạng "chạy tốt với tôi nhưng lại lỗi với người khác" mà bạn gặp phải sau khi xuất bản thường là do vấn đề quyền hạn, chứ không phải do code. Và đây chính là vấn đề mà bước hoàn thiện cuối cùng sẽ giải quyết.
Những điểm chính cần lưu ý
Nhấp vào bất kỳ phản hồi nào để chuyển đến nguồn của nó; Bản đồ hoạt động hiển thị kế hoạch của orchestrator, các truy vấn tìm kiếm, nguồn dữ liệu được sử dụng hoặc bỏ qua, cũng như dữ liệu đầu vào/đầu ra của công cụ.
Thực hiện gỡ lỗi theo từng lớp - kiến thức, công cụ, hướng dẫn, chủ đề - và chỉ sửa một vấn đề sau mỗi lần reset.
Tùy chỉnh chủ đề xử lý lỗi (On Error) để hệ thống tự động thử lại một cách mượt mà thay vì ngắt kết nối đột ngột với người dùng.
Quy trình đánh giá sẽ chạy hàng loạt tới 100 câu hỏi với cách diễn đạt tự nhiên và chấm điểm các câu trả lời; kết quả được lưu trữ trong 89 ngày.
Khung kiểm thử hoạt động dưới quyền của bạn - các lỗi liên quan đến quyền truy cập sẽ chỉ xuất hiện đối với người dùng khác sau khi đã xuất bản.
Câu 1:
Một agent trả lời hoàn hảo câu hỏi của Priya trong khung kiểm thử, nhưng cùng câu hỏi đó lại thất bại khi đồng nghiệp sử dụng agent đã xuất bản trên Teams. Priya nên kiểm tra điều gì đầu tiên?
GIẢI THÍCH:
Tình trạng "tôi dùng thì được nhưng họ dùng lại lỗi" là dấu hiệu điển hình của cơ chế giới hạn quyền truy cập: Các câu trả lời dựa trên dữ liệu SharePoint được giới hạn trong phạm vi mà người đặt câu hỏi có quyền truy cập, nghĩa là quyền truy cập của Priya khác với đồng nghiệp của cô ấy. Cùng một mô hình phục vụ cho cả hai nền tảng, ứng dụng Teams không tự động loại bỏ phản hồi, và các agent đã xuất bản cũng không bị hết hạn theo ngày.
Câu 2:
Agent của Maya luôn vượt qua 10 câu hỏi kiểm thử của cô ấy, nhưng các đồng nghiệp lại báo cáo về những câu trả lời sai gần như hàng ngày. Bước tiếp theo tốt nhất là gì?
GIẢI THÍCH:
10 câu hỏi của cô ấy rõ ràng không đại diện cho những gì đồng nghiệp thực sự hỏi. Tính năng đánh giá sinh ra chính là để giải quyết vấn đề này: Upload lên tới 100 câu hỏi thực tế làm bộ dữ liệu kiểm thử, chạy hàng loạt và chấm điểm các câu trả lời. Các hướng dẫn kiểu "hãy chính xác" không mang lại hiệu quả thực tế, việc lặp lại các bài kiểm thử đã đạt kết quả tốt không chứng minh được điều gì mới, và lỗi do phiên bản publish đã cũ thường sẽ gây lỗi nhất quán chứ không phải thay đổi theo từng ngày.
Câu 3:
Bạn muốn xem chính xác những nguồn kiến thức nào orchestrator đã tìm kiếm để đưa ra một câu trả lời cụ thể - bao gồm cả những nguồn đã được tìm kiếm nhưng cuối cùng không được sử dụng. Bạn nên xem ở đâu?
GIẢI THÍCH:
Bản đồ hoạt động đóng vai trò như công cụ "chụp X-quang" cho từng lượt tương tác: Đối với các bước xử lý kiến thức, nó hiển thị truy vấn tìm kiếm đã được viết lại, những nguồn được trích dẫn và các nguồn đã tìm kiếm nhưng không sử dụng. Monitor tổng hợp dữ liệu sử dụng trên các kênh đã xuất bản (chứ không phải chi tiết truy xuất cho từng câu trả lời), Variables theo dõi những biến của cuộc hội thoại, còn snapshot ghi lại thông tin chủ đề và chẩn đoán - chứ không phải thông tin này.
Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

 Copilot Studio
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học