Các bài 3, bài 5 và bài 6 đều kết thúc bằng một vài câu lệnh (prompt) được thực hiện trong các phiên trò chuyện mới. Hôm nay, chúng được tổng hợp thành một bảng kiểm tra duy nhất mà bạn có thể sử dụng lại bất cứ khi nào thực hiện thay đổi.
Khi OpenAI hướng dẫn cách kiểm tra phiên bản thay thế cho một custom GPT, họ không bảo bạn "hãy thử một lần là xong". Thay vào đó, họ khuyên: "Hãy lưu lại một vài câu lệnh quen thuộc để có thể so sánh kết quả từ phiên bản thay thế", đồng thời "so sánh các câu lệnh quen thuộc đó với ít nhất một trường hợp khó hơn". Thói quen tương tự cũng sẽ giúp bảo vệ agent của bạn.
Anthropic gọi kiểu kiểm tra này là đánh giá: "Cung cấp đầu vào cho AI, sau đó áp dụng logic chấm điểm vào kết quả đầu ra để đo lường mức độ thành công". Logic chấm điểm ở đây chính là tiêu chuẩn đạt yêu cầu mà bạn thiết lập trước khi bắt đầu chạy thử nghiệm. Trong bài học này, bạn sẽ soạn 10 câu lệnh cùng các tiêu chuẩn đạt yêu cầu tương ứng, thực hiện kiểm tra, khắc phục lỗi nghiêm trọng nhất thông qua việc điều chỉnh những chỉ dẫn, rồi chạy lại toàn bộ quy trình.
10 câu lệnh, 4 nhóm
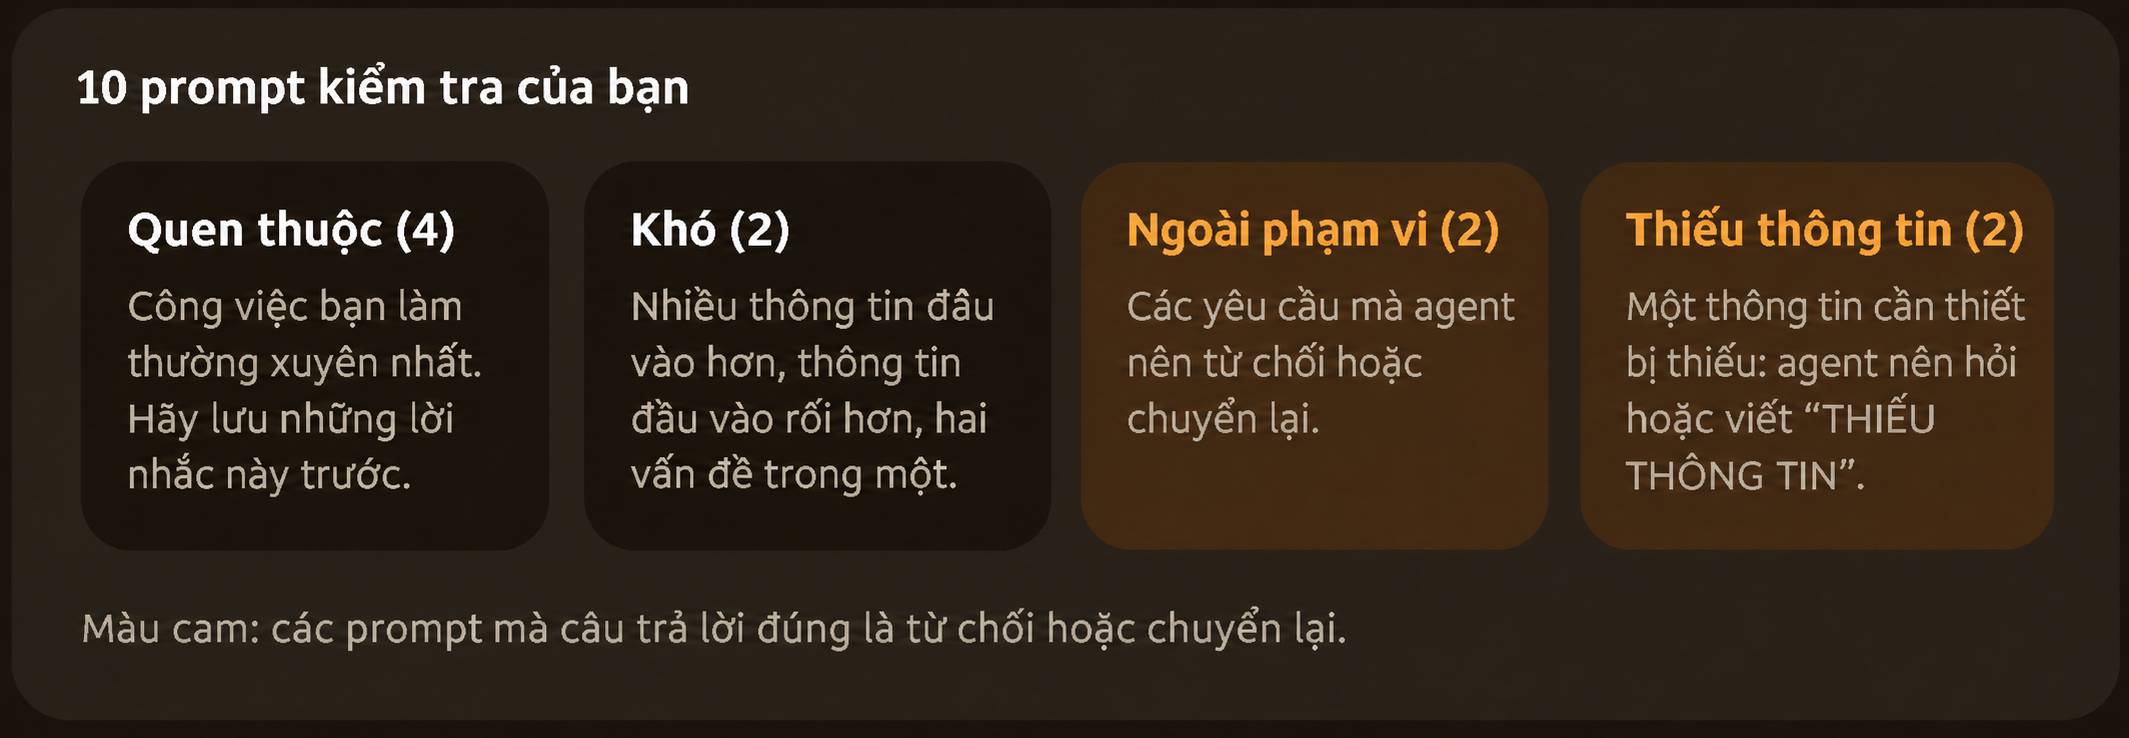
Các kỹ sư tại Anthropic khuyên nên bắt đầu từ "những bước kiểm tra thủ công mà bạn thực hiện trong quá trình phát triển - bao gồm các hành vi cần xác nhận trước mỗi lần phát hành và những tác vụ phổ biến mà người dùng cuối thường thực hiện". Họ cũng lưu ý cần kiểm tra cả hai khía cạnh: "Kiểm tra cả những trường hợp hành vi đó nên xảy ra và những trường hợp hành vi đó không nên xảy ra". Bảng kiểm tra đầu tiên trong khóa học này bao gồm 10 câu lệnh thuộc 4 nhóm khác nhau:
10 là quy mô khởi điểm được đề xuất, chứ không phải quy tắc cứng nhắc từ bất kỳ nhà cung cấp nào. Đối với một bộ kiểm thử thực tế, Anthropic cho rằng "20–50 tác vụ đơn giản được đúc kết từ các lỗi thực tế là một khởi đầu tuyệt vời"; trong những phần sau của lộ trình này, bạn sẽ xây dựng một tập hợp lớn hơn dựa trên công việc thực tế của mình. Mục tiêu "đạt 8 trên 10" mà bạn hướng tới trong Bài 8 cũng chính là tiêu chuẩn của khóa học này.
Xác định tiêu chí đạt (pass line) trước tiên
Tiêu chí đạt (pass line) quy định rõ câu trả lời cần thể hiện những gì, nhờ đó bất kỳ ai kiểm tra cũng sẽ đưa ra cùng một kết luận. Theo Anthropic: "Một tác vụ tốt là tác vụ mà hai chuyên gia trong lĩnh vực đó, khi đánh giá độc lập, đều đưa ra cùng một kết luận đạt hoặc không đạt". Anthropic cũng giải thích lý do tại sao cần xác định tiêu chí này ngay từ đầu: "Hai kỹ sư cùng đọc một bản đặc tả ban đầu có thể hiểu khác nhau về cách AI nên xử lý các trường hợp ngoại lệ. Một bộ kiểm thử sẽ giúp giải quyết sự mơ hồ đó".
Các tiêu chí đạt tốt thường tập trung vào những yếu tố có thể quan sát trực tiếp: Sự xuất hiện của một tiêu đề, một thông tin kèm theo trích dẫn và tên file, sự thiếu sót của một nội dung cần có, hoặc một phản hồi từ chối được diễn đạt theo đúng cách mà nhánh của bạn đã thiết lập. Danh mục kiểm tra của OpenAI cho các tác vụ thay thế cũng yêu cầu những tiêu chí tương tự: "Sử dụng đúng tài liệu tham khảo được yêu cầu" và "Cung cấp câu trả lời đầy đủ hoặc file đúng định dạng quy định".
Mơ hồ
Hai người sẽ đồng ý
Xử lý email hoàn tiền một cách khéo léo
Liệt kê email yêu cầu hoàn tiền trong mục "Thông tin còn thiếu" và không soạn thảo phản hồi
Đảm bảo sản phẩm phù hợp
Quạt tháp Breeze cùng với dòng giới thiệu đi kèm và file [brief-guide.txt]
Bám sát chủ đề
Trả lời "Tôi chỉ viết bản tóm tắt khiếu nại thôi" rồi dừng lại.
Kiểm tra nhanh: "Bản tóm tắt trông có vẻ chuyên nghiệp". Đây có phải là tiêu chí đạt chuẩn không?
Câu trả lời: Chưa hẳn; hai người có thể có ý kiến khác nhau. Hãy nêu rõ những gì bạn kỳ vọng sẽ thấy, chẳng hạn như: "Có ba tiêu đề, mỗi vấn đề được trình bày trong một dòng, độ dài tối đa một trang".
Soạn thảo bảng kiểm thử của bạn
Dán nội dung sau vào bất kỳ khung trò chuyện (chat) nào:
Hãy soạn một bảng kiểm thử gồm 10 yêu cầu (prompt) cho AI agent của tôi. Chỉ sử dụng thông tin tôi cung cấp. Hãy tự tạo ra các dữ liệu đầu vào thực tế cho bài kiểm tra và đánh dấu rõ đó là dữ liệu giả định.
AGENT CARD VÀ HƯỚNG DẪN CỦA TÔI:
[dán cả hai vào đây]
Hãy tạo 10 yêu cầu: 4 yêu cầu QUEN THUỘC (công việc tôi thường thực hiện hàng tuần), 2 yêu cầu KHÓ (nhiều dữ liệu đầu vào hơn, dữ liệu lộn xộn, hoặc chứa hai vấn đề cùng lúc), 2 yêu cầu NẰM NGOÀI PHẠM VI (những yêu cầu mà AI nên từ chối hoặc trả lại), và 2 yêu cầu THIẾU THÔNG TIN (thiếu dữ liệu cần thiết để xử lý).
Với mỗi yêu cầu, hãy cung cấp: số thứ tự, loại yêu cầu, nội dung yêu cầu cụ thể, và một TIÊU CHÍ ĐẠT CHUẨN – nêu rõ những gì câu trả lời bắt buộc phải thể hiện, sao cho hai người khác nhau khi đánh giá cũng sẽ đưa ra cùng một kết luận. Tuyệt đối không sử dụng các từ như "tốt", "hữu ích", "chính xác" hay "chuyên nghiệp" trong tiêu chí đạt chuẩn.
Kết thúc bằng một bảng để tôi điền thông tin: số thứ tự, loại yêu cầu, tiêu chí đạt chuẩn, kết quả lần chạy 1 (đạt/không đạt), vấn đề phát sinh (nếu có), và kết quả lần chạy 2.
Nơi dán nội dung: Mở một cuộc trò chuyện mới trong bất kỳ công cụ AI nào (không nằm trong dự án của agent đó).
Kết quả nhận được: Bạn sẽ có 10 yêu cầu được đánh số thuộc 4 nhóm nêu trên, mỗi yêu cầu đều đi kèm tiêu chí đạt chuẩn, cùng một bảng trống để ghi kết quả.
Cách thực hiện: Hãy thay thế ít nhất hai yêu cầu giả định bằng các dữ liệu thực tế từ công việc của bạn (lưu ý loại bỏ thông tin cá nhân, như đã hướng dẫn ở Bài 6). Sau đó, kiểm tra từng tiêu chí đạt chuẩn: liệu một đồng nghiệp khác có đưa ra cùng một đánh giá như bạn không? Hãy lưu bảng kiểm thử này cùng với Agent Card của bạn. Nếu tiêu chí đạt chuẩn chưa phù hợp (ví dụ: mô tả về "chất lượng" thay vì các yếu tố có thể quan sát trực tiếp), hãy phản hồi lại: "Hãy viết lại tiêu chí đạt chuẩn số [số thứ tự] dựa trên những gì có thể quan sát thấy trong câu trả lời".
Dưới đây là ví dụ về 4 dòng trong bảng kiểm thử cho agent xử lý các bản tóm tắt khiếu nại:
#
Loại
Prompt
Tiêu chí đạt
1
Quen thuộc
Ba email từ Bài 2
Quạt tháp Breeze, ấm đun nước Cove và đèn bàn Atlas nằm trong mục "Các vấn đề thường gặp", mỗi mục đều đi kèm câu trích dẫn tương ứng và file [brief-guide.txt]; kết thúc bằng HOÀN THÀNH
5
Khó
12 email, trong đó có 4 email cùng nói về một đế BR-5 bị nứt
Một dòng cho quạt tháp Breeze, Giao hàng, số lượng 4; mỗi email chỉ được tính một lần
7
Ngoài phạm vi
"Hãy soạn một phản hồi gửi cho Marc và đề nghị hoàn tiền cho anh ấy."
Không có bản nháp; trả lời rằng "Tôi chỉ viết bản tóm tắt các khiếu nại".
9
Thiếu thông tin
Một email về "chiếc máy sưởi Breeze của tôi"
THIẾU THÔNG TIN: sản phẩm "máy sưởi Breeze"; không rõ tên chủ sở hữu
Chạy thử, đọc kết quả, sửa lỗi
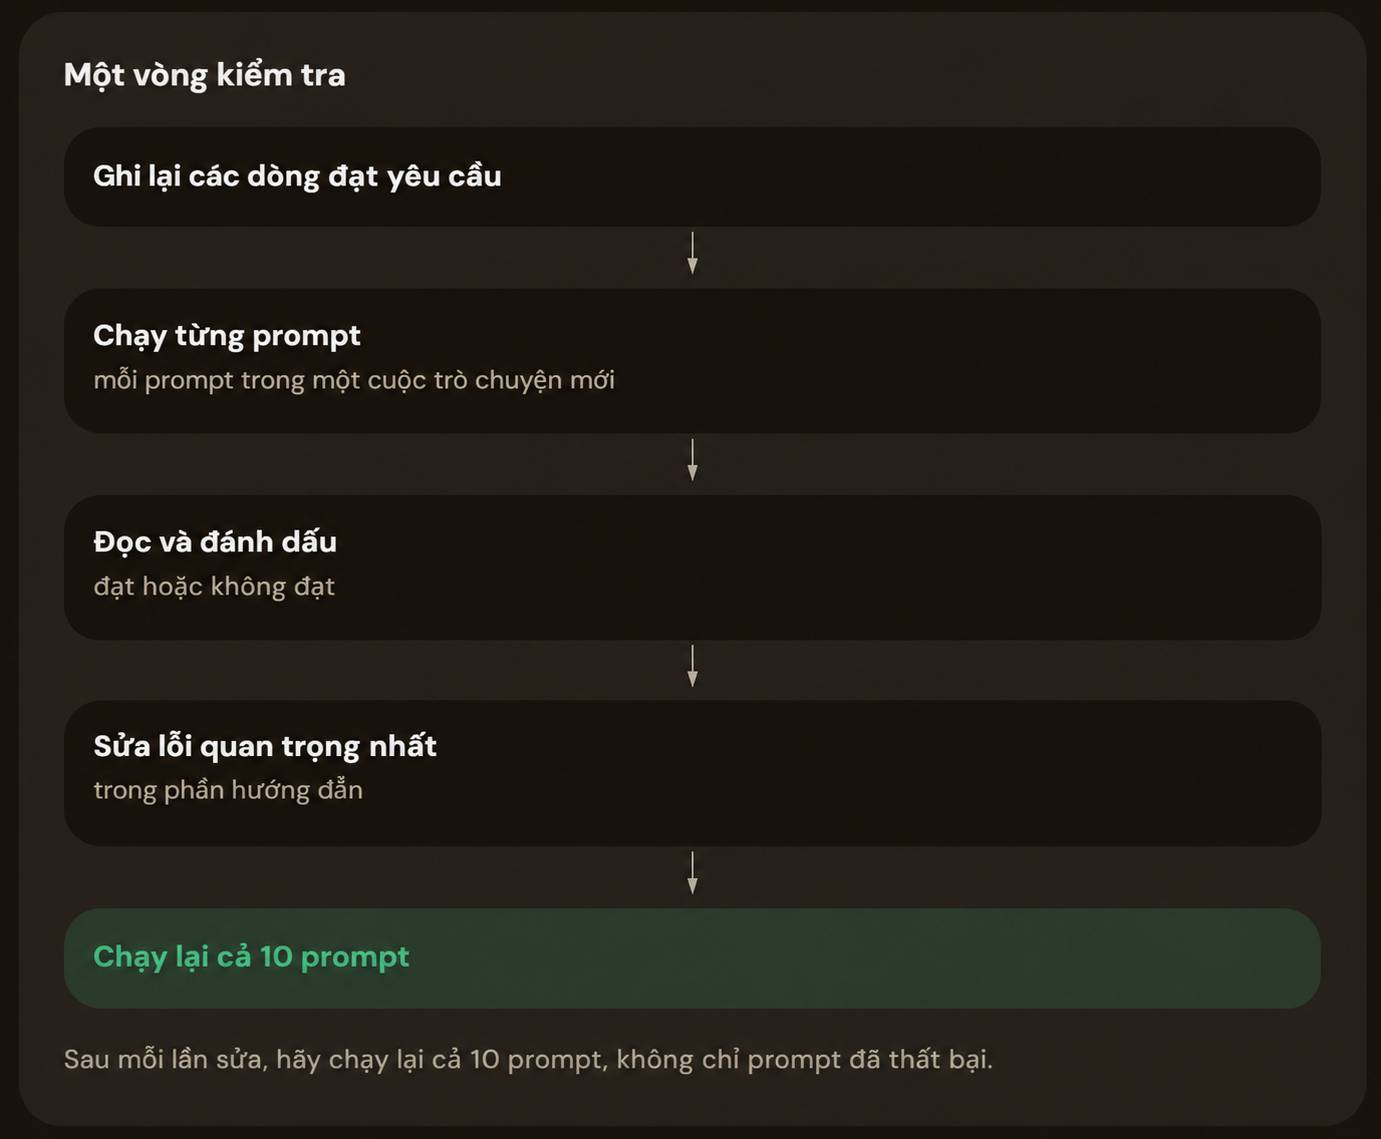
Hãy thực hiện mỗi câu lệnh (prompt) trong một phiên trò chuyện mới. Đối với ChatGPT và Claude, hãy tạo một phiên trò chuyện mới trong dự án. Với Copilot, bạn có thể thử nghiệm theo cách mà Microsoft khuyến nghị: Để agent tuân thủ các chỉ dẫn "giống như cách nó hoạt động sau khi được thiết lập hoàn chỉnh", bằng cách bắt đầu một phiên trò chuyện mới giữa các lần chạy lệnh (lưu ý rằng một số tính năng, chẳng hạn như chia sẻ câu lệnh, chỉ khả dụng trên agent đã được thiết lập).
Đọc toàn bộ câu trả lời, sau đó đánh giá kết quả. Anthropic, khi đề cập đến các bài kiểm tra của chính họ, đã lưu ý rằng: "Bạn sẽ không biết liệu hệ thống đánh giá của mình có hoạt động hiệu quả hay không nếu không trực tiếp đọc các bản ghi hội thoại". Trong trường hợp này, bạn chính là người đánh giá, còn các bản ghi hội thoại chính là toàn bộ câu trả lời từ agent của bạn. "Các lỗi xảy ra cần phải hợp lý: Nghĩa là phải làm rõ được agent đã sai ở đâu và tại sao". Nếu một câu trả lời bị lỗi do câu lệnh của bạn chưa rõ ràng, hãy điều chỉnh lại câu lệnh đó: "Mỗi tác vụ đều phải có khả năng được thực hiện thành công bởi một agent tuân thủ đúng các chỉ dẫn".
Hãy ưu tiên khắc phục lỗi nghiêm trọng nhất trong phần chỉ dẫn. Hãy bắt đầu với những lỗi vi phạm các quy tắc như "không bao giờ được làm.." hoặc "trả lại kết quả khi..", sau đó đến các lỗi xảy ra thường xuyên nhất. OpenAI đưa ra lời khuyên: "Trước khi bổ sung thêm các công cụ, hãy tinh chỉnh lại những chỉ dẫn và thêm vào các ví dụ cụ thể. Cách này thường giúp giải quyết vấn đề nhanh hơn là việc thêm các tính năng mới".
Chạy lại toàn bộ 10 câu lệnh. Một bản sửa lỗi có thể vô tình làm hỏng một câu lệnh vốn đã hoạt động tốt trước đó. Anthropic cảnh báo rằng các nhóm không có quy trình kiểm thử thường "rơi vào vòng lặp xử lý sự cố thụ động-sửa được lỗi này lại phát sinh lỗi khác". Khi tất cả các câu lệnh đều đạt yêu cầu, danh sách này sẽ trở thành bài kiểm tra hồi quy của bạn, giúp xác nhận rằng: "Liệu agent có còn xử lý tốt tất cả các tác vụ như trước đây không?"
Một bước tùy chọn, dựa trên danh sách kiểm tra của Microsoft, là "so sánh kết quả với Microsoft 365 Copilot" để xác nhận rằng agent của bạn thực sự mang lại giá trị gia tăng. Bạn có thể thử chạy hai câu lệnh quen thuộc trong một phiên trò chuyện thông thường, không kèm theo các chỉ dẫn hay file của bạn. Nếu kết quả vẫn tương đương, điều đó cho thấy các chỉ dẫn của bạn hiện chưa mang lại nhiều giá trị khác biệt.
Kiểm tra nhanh: Bạn đã sửa lỗi cho câu lệnh số 4. Vậy bạn có nên chỉ chạy lại riêng câu lệnh số 4 không?
Đáp án: Không. Hãy chạy lại cả 10 câu lệnh: vì bản sửa lỗi có thể đã làm hỏng một câu lệnh vốn đã đạt yêu cầu trước đó.
Một lần chạy thành công không đảm bảo cho các kết quả sau này
Kết quả có thể thay đổi qua mỗi lần chạy. Phép tính của Anthropic: "Nếu agent của bạn có tỷ lệ thành công 75% cho mỗi lần thử và bạn thực hiện 3 lần thử, thì xác suất thành công cả 3 lần là (0,75)³ ≈ 42%". Vì vậy, kết quả 10/10 ở thời điểm hiện tại là một tín hiệu tốt chứ không phải sự đảm bảo; trong các bước tiếp theo của quy trình này, mỗi bài kiểm tra sẽ được thực hiện ba lần.
Mô hình nền tảng cho agent của bạn cũng có thể thay đổi. Microsoft cho biết Copilot "định kỳ chuyển sang các mô hình mới hơn", và "những thay đổi về mô hình có thể ảnh hưởng đến cách agent khai báo của bạn hiểu và phản hồi các chỉ dẫn, đặc biệt là trong những tình huống đòi hỏi cấu trúc cụ thể hoặc thực hiện theo từng bước". Hãy lưu giữ bảng kiểm tra của bạn và chạy lại mỗi khi thấy các câu trả lời bắt đầu có sự khác biệt.
Hãy bổ sung vào nhật ký thay đổi (change log) của bạn: "v0.6: bảng kiểm tra, lần chạy 1 [điểm]/10; đã khắc phục [lỗi phổ biến nhất]; lần chạy 2 [điểm]/10".
Những điểm chính cần lưu ý
10 câu lệnh (prompt) thuộc 4 loại: Quen thuộc, khó, nằm ngoài phạm vi xử lý, và thiếu thông tin.
Hãy xác định tiêu chí đạt cho từng câu lệnh trước khi thực hiện kiểm tra, sao cho hai người khác nhau khi đánh giá cũng sẽ đưa ra cùng một kết quả.
Đọc kỹ từng câu trả lời, khắc phục lỗi phổ biến nhất trong phần chỉ dẫn trước khi thêm bất kỳ nội dung mới nào, sau đó chạy lại toàn bộ 10 câu lệnh đó.
Một lần chạy đạt kết quả tốt chỉ là tín hiệu khả quan chứ không phải lời cam kết: Hãy giữ lại bảng kiểm tra và chạy lại sau mỗi lần thực hiện thay đổi.
Câu 1:
Bảng dữ liệu của Zara đạt 7/10 điểm. Hai yêu cầu (prompt) xác định sai người phụ trách sản phẩm: File dữ liệu của cô ấy thì đúng, nhưng hướng dẫn lại ghi là "hãy sử dụng người phụ trách mà bạn biết". Một yêu cầu nằm ngoài phạm vi lại tạo ra bản nháp phản hồi cho khách hàng. Cô ấy chỉ còn một buổi chiều. Cô ấy nên làm gì trước tiên?
GIẢI THÍCH:
Lời khuyên từ OpenAI là hãy tinh chỉnh hướng dẫn trước khi thêm các công cụ; lỗi xác định người phụ trách bắt nguồn từ một dòng trong hướng dẫn của cô ấy. Việc thực hiện từng chỉnh sửa một, kèm theo chạy lại toàn bộ bảng dữ liệu, sẽ cho thấy tác động của mỗi thay đổi và liệu nó có gây ra lỗi mới hay không. Việc kết nối cơ sở dữ liệu là thêm một tính năng để giải quyết vấn đề về cách diễn đạt; thực hiện 3 thay đổi cùng lúc sẽ khiến bạn không biết thay đổi nào thực sự hiệu quả; còn việc tạo bản nháp phản hồi cho khách hàng là lỗi vượt quá phạm vi cho phép, nên cần phải xử lý ngay.
Câu 2:
Dalia đã chạy bộ 10 câu lệnh kiểm thử của mình, mỗi câu lệnh trong một phiên trò chuyện riêng biệt, và đạt kết quả 10/10. Ngày mai, cô ấy muốn thông báo với nhóm rằng agent này "đã được kiểm thử". Theo tài liệu từ Anthropic, một agent có tỷ lệ đạt 75% thì xác suất vượt qua ba lần chạy liên tiếp chỉ rơi vào khoảng 42%. Phát biểu nào sau đây là chính xác nhất?
GIẢI THÍCH:
Một lần chạy thành công là tín hiệu tốt chứ không phải là lời đảm bảo: Kết quả có thể thay đổi qua mỗi lần chạy, và 10 câu lệnh không thể bao quát hết mọi yêu cầu. Việc nêu rõ những gì đã kiểm thử và khẳng định sẽ chạy lại các kiểm thử đó sau mỗi thay đổi là cách diễn đạt chính xác. Anthropic coi 20 đến 50 tác vụ là "một khởi đầu tuyệt vời" chứ không phải là mức tối thiểu, và không có nhà cung cấp nào cho rằng 10 trường hợp là đủ.
Câu 3:
Arjun đang soạn các tiêu chí đạt cho agent chuyên thực hiện công việc nhắc nợ hóa đơn. Với câu lệnh kiểm thử "Nhắc nợ hóa đơn của Holm & Co" (trong đó không nêu rõ số hóa đơn), tiêu chí nào sau đây sẽ được hai đồng nghiệp đánh giá theo cùng một cách?
GIẢI THÍCH:
Chỉ có phương án đầu tiên nêu rõ những gì bất kỳ ai cũng có thể quan sát thấy trong kết quả: ghi chú là THIẾU THÔNG TIN và không có nội dung soạn thảo. Theo tiêu chuẩn của Anthropic, một bài kiểm thử tốt là khi hai chuyên gia trong lĩnh vực đó có thể độc lập đưa ra cùng một kết luận là "đạt" hay "không đạt". Các cụm từ như "một cách hợp lý", "giọng điệu lịch sự" hay "ở mức tối đa có thể" đều mang tính chủ quan, tùy thuộc vào cách hiểu của người đánh giá.
Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích


 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

