AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

OpenAI vừa bổ sung ba chế độ xử lý cho mô hình GPT-6 Astra: Standard, Fast và Ultrafast. Ba chế độ này không thay đổi mô hình, chỉ thay đổi tốc độ xử lý và mức tiêu thụ hạn mức hoặc chi phí. Ultrafast hiện chỉ khả dụng cho một số gói và tài khoản nhất định, còn API có quy tắc truy cập và thanh toán riêng.
Đa số gợi ý khởi điểm khá đơn giản như:
- Dùng Standard cho công việc có thể chờ, như báo cáo hoặc tác vụ chạy nền.
- Thử Fast khi bạn đang chỉnh sửa và cần phản hồi nhanh hơn để làm việc liền mạch.
- Cân nhắc Ultrafast cho công việc gấp, dùng Astra và cần nhiều lượt trao đổi liên tiếp, nhưng chỉ khi thời gian tiết kiệm được xứng với chi phí.
Bài này sẽ giúp bạn kiểm tra điều kiện truy cập, xác định nhu cầu về thời gian chờ, so sánh chi phí và thiết lập một quy tắc dùng rõ ràng.
1. Ba chế độ Standard, Fast và Ultrafast khác nhau như thế nào?
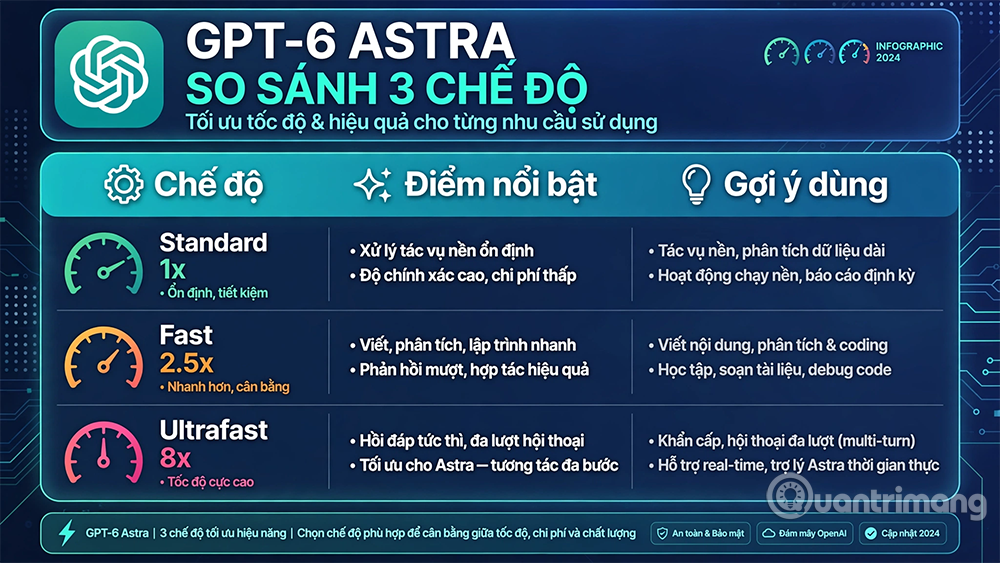
Các tùy chọn này quyết định tốc độ OpenAI xử lý yêu cầu với một mô hình được hỗ trợ. Việc chọn mô hình và mức suy luận (reasoning) là hai quyết định tách biệt.
Ví dụ, nếu bạn chọn GPT-6 Astra với Ultrafast thì mô hình vẫn là Astra. Bạn vẫn cần kiểm tra câu trả lời và mọi hành động mà mô hình thực hiện.
|
Chế độ |
Điểm nổi bật |
Gợi ý dùng |
|
Standard |
Tốc độ xử lý nền và mức tiêu thụ cơ bản của mô hình |
Báo cáo, công việc thường ngày, tác vụ bạn có thể để chạy rồi quay lại sau |
|
Fast |
OpenAI quảng bá tốc độ nhanh hơn tối đa 2,5 lần trên API |
Viết lách, phân tích, lập trình khi bạn đang trực tiếp rà soát từng phản hồi |
|
Ultrafast |
OpenAI quảng bá tốc độ nhanh hơn tối đa 8 lần trên API |
Công việc gấp dùng Astra, có nhiều lượt hỏi đáp liên tiếp |
Đây là mức tối đa mà OpenAI công bố. Tổng thời gian hoàn thành một tác vụ còn bao gồm công cụ bên ngoài, độ trễ mạng và thời gian bạn rà soát. Con số này cũng gắn với sản phẩm và mô hình cụ thể, nên đừng xem nó là mức cải thiện chung cho mọi trường hợp.
Token là đơn vị nhỏ mà mô hình dùng để xử lý thông tin. Tạo token nhanh hơn có thể rút ngắn thời gian chờ phản hồi, nhưng nếu tác vụ còn phụ thuộc vào công cụ hoặc dữ liệu bên ngoài thì tổng thời gian có thể vẫn lâu.
2. Các bước giúp bạn so sánh chi tiết giữa Standard, Fast và Ultrafast
Bước 1: Kiểm tra bạn được dùng chế độ nào
Trước khi cân nhắc tốc độ, hãy xác định gói dịch vụ và cách bạn truy cập.
|
Tình huống của bạn |
Quyết định |
|
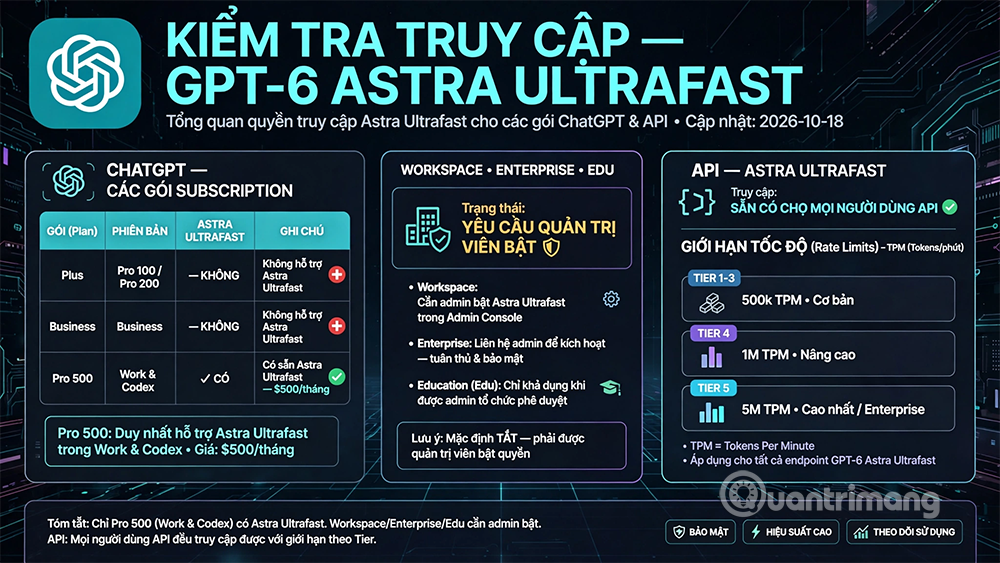
ChatGPT Plus, Pro 100, Pro 200 hoặc Business |
Có thể so sánh Standard và Fast nếu có. Các gói này chưa có Ultrafast tại thời điểm ra mắt, kể cả khi mua thêm credit. |
|
ChatGPT Pro 500 |
Chọn được Astra Ultrafast trong Work và Codex. Gói có giá 500 USD mỗi tháng. |
|
Workspace Enterprise hoặc Edu đủ điều kiện |
Kiểm tra quyền quản trị và thỏa thuận thanh toán của workspace. Chủ sở hữu Enterprise phải bật quyền Ultrafast. Gói Enterprise tính phí theo hạn mức tốc độ cũ không được hỗ trợ. |
|
Ứng dụng dùng OpenAI API |
Astra Ultrafast khả dụng cho mọi người dùng API, theo giới hạn tốc độ và vùng xử lý. Không cần đăng ký ChatGPT Pro 500. |
Với tài khoản ChatGPT đủ điều kiện: Mở Work hoặc Codex, chọn GPT-6 Astra, rồi chọn Ultrafast trong menu mô hình. Nếu không thấy tùy chọn này, hãy kiểm tra lại workspace đang dùng.
Giới hạn tốc độ API: OpenAI liệt kê mức token mỗi phút mặc định cho Astra Ultrafast như sau:
|
Hạng sử dụng API |
Token mỗi phút |
|
Hạng 1–3 |
500.000 |
|
Hạng 4 |
1.000.000 |
|
Hạng 5 |
5.000.000 |
Đây là giới hạn dung lượng của API. Hạn mức trong ChatGPT tuân theo quy tắc riêng. Nếu bạn lên kế hoạch triển khai API, hãy đối chiếu con số này với lượng truy cập dự kiến trước khi chọn tốc độ.
Về vùng xử lý: API hỗ trợ xử lý toàn cầu và lưu trữ dữ liệu tại Mỹ. Các điểm xử lý khu vực châu Âu hoặc khu vực không thuộc Mỹ chưa được hỗ trợ. Các workspace yêu cầu xử lý dữ liệu ngoài Mỹ cũng chưa có quyền này. Vị trí thực tế của người dùng không tự quyết định họ có đủ điều kiện hay không.
Bước 2: Xác định thời gian chờ quan trọng đến đâu
Hãy nghĩ đến công việc bạn cần hoàn thành. Bảng sau là điểm xuất phát:
|
Tình huống của bạn |
Nên bắt đầu với |
Vì sao |
|
Bạn có thể để báo cáo chạy và xem lại sau |
Standard |
Rút ngắn thời gian chờ có thể không mang lại nhiều giá trị |
|
Bạn đang chỉnh sửa đề xuất và kiểm tra từng bản sửa |
Fast |
Giảm khoảng ngừng giữa các lượt giúp phiên làm việc hiệu quả hơn |
|
Bạn cần Astra cho bài toán khó, có nhiều câu hỏi tiếp theo và deadline gấp |
Ultrafast, nếu có quyền |
Tiết kiệm thời gian qua nhiều lượt trao đổi liên tiếp |
|
Bạn có nhiều việc thường ngày và ngân sách cố định |
Standard |
Giữ phần ngân sách lớn hơn cho các công việc đã hoàn thành |
|
Câu trả lời liên tục thiếu dữ kiện hoặc bỏ sót chỉ dẫn |
Kiểm tra prompt, nguồn tài liệu và mô hình trước |
Độ chính xác cần được xử lý trước khi bạn trả thêm tiền cho tốc độ |
Một tác vụ khó vẫn có thể chạy ở tốc độ Standard. Hãy chọn mô hình và mức suy luận cho ra kết quả chấp nhận được, rồi mới quyết định bạn coi trọng tốc độ đến mức nào.
Bước 3: Tìm xem điều gì đang làm chậm công việc
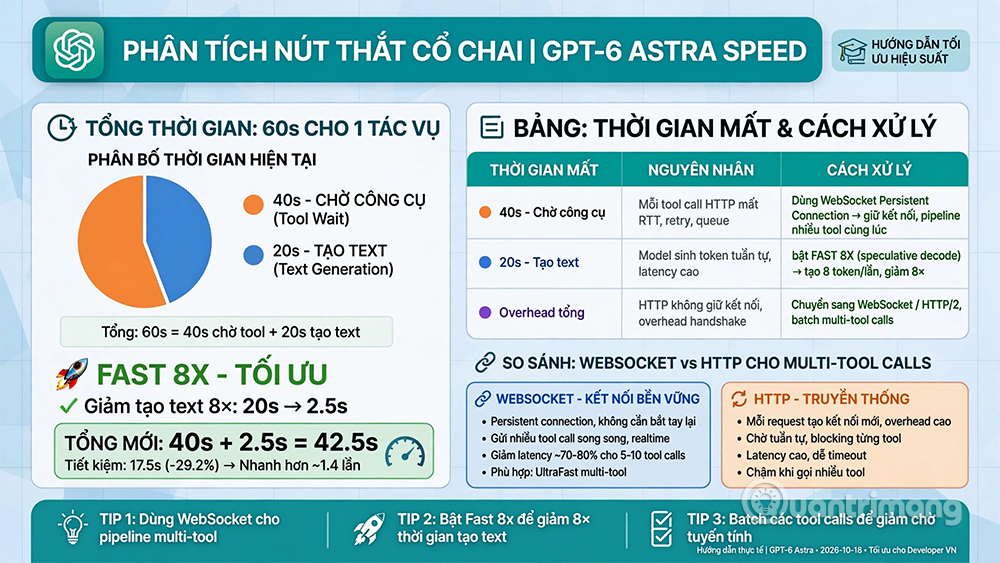
Không phải lúc nào mô hình cũng là nguyên nhân chậm. Có tác vụ chủ yếu tốn thời gian để sinh câu trả lời, nhưng cũng có tác vụ phải chờ website, thao tác tệp hoặc dịch vụ bên ngoài. Hướng dẫn của OpenAI tách riêng độ dài đầu ra, số lần gọi mô hình và thiết kế công cụ như những cách khác nhau để giảm độ trễ.
|
Phần lớn thời gian đang bị mất ở đâu? |
Cách xử lý |
|
Sinh một câu trả lời dài hoặc gọi mô hình nhiều lần |
So sánh Fast và Ultrafast nếu thời gian tiết kiệm được có ý nghĩa |
|
Trao đổi mạng lặp lại giữa ứng dụng API và OpenAI |
Xem xét tái sử dụng kết nối, không chỉ chỉnh tốc độ |
|
Website, cơ sở dữ liệu hoặc ứng dụng liên kết chậm |
Kiểm tra dịch vụ đó trước khi trả thêm cho tốc độ mô hình |
|
Kết quả quá nhiều chi tiết so với nhu cầu |
Yêu cầu câu trả lời ngắn hơn trước khi tăng tốc |
|
Phải rà soát và sửa nhiều phần yếu |
Cải thiện tài liệu nguồn và quy tắc rà soát trước |
|
Tác vụ bạn sẽ đọc vào ngày mai |
Giữ Standard làm mặc định |
Ví dụ minh họa: Một tác vụ mất 60 giây, trong đó 40 giây chờ công cụ và 20 giây sinh văn bản. Nếu phần sinh văn bản nhanh gấp 8 lần, nó chỉ còn khoảng 2,5 giây. Tổng thời gian khi đó là 42,5 giây, với giả định các phần khác không đổi. Đây là lý do việc tăng tốc mô hình không phải lúc nào cũng làm công việc nhanh hơn nhiều.
Dành cho ứng dụng API: OpenAI khuyến nghị dùng kết nối WebSocket liên tục cho các tác vụ Ultrafast có nhiều lần gọi công cụ. Kết nối HTTP vẫn hoạt động bình thường. WebSocket giúp giữ kết nối mở qua nhiều bước, và bạn có thể tiếp tục bằng dữ liệu mới cùng mã phản hồi trước đó. Cách này giảm chi phí thiết lập lại cho mỗi lượt, nhưng một công cụ bên ngoài chậm vẫn cần được kiểm tra riêng.
Trong Work hoặc Codex, bạn chọn tốc độ qua các nút điều khiển của sản phẩm. Phần hướng dẫn kỹ thuật trên chỉ dành cho tích hợp API của riêng bạn.
Khi đánh giá việc nâng cấp, hãy đo thời gian đến một kết quả đúng và dùng được, chứ không chỉ đo thời gian nhận phản hồi đầu tiên.
Bước 4: So sánh đúng loại chi phí
Trong ChatGPT, OpenAI tách ba nguồn bao gồm hạn mức đi kèm gói, credit mua thêm và chi phí API. Gói của bạn sẽ dùng hạn mức đi kèm trước, sau đó dùng credit có sẵn cho các lượt đủ điều kiện.
Với cùng một mô hình được hỗ trợ, so với Standard:
|
Loại sử dụng |
Standard |
Fast |
Astra Ultrafast |
|
Hạn mức đi kèm gói bị trừ |
1× |
2,5× |
8× |
|
Phí credit mua thêm |
1× |
2× |
6× |
Các hệ số này mô tả mức sử dụng và phí, không dự đoán tác vụ sẽ hoàn thành nhanh hơn bao nhiêu. Với gói Enterprise tính phí theo mức dùng, hãy đối chiếu thỏa thuận của workspace.
Ví dụ tỷ lệ: Nếu giả định rằng khối lượng công việc như nhau, một hạn mức đủ cho 80 lượt Standard sẽ đủ cho khoảng 32 lượt Fast hoặc 10 lượt Ultrafast. Quy mô tác vụ thực tế thường khác nhau, nên hãy xem đây là ví dụ tỷ lệ, không phải cam kết cho gói của bạn.
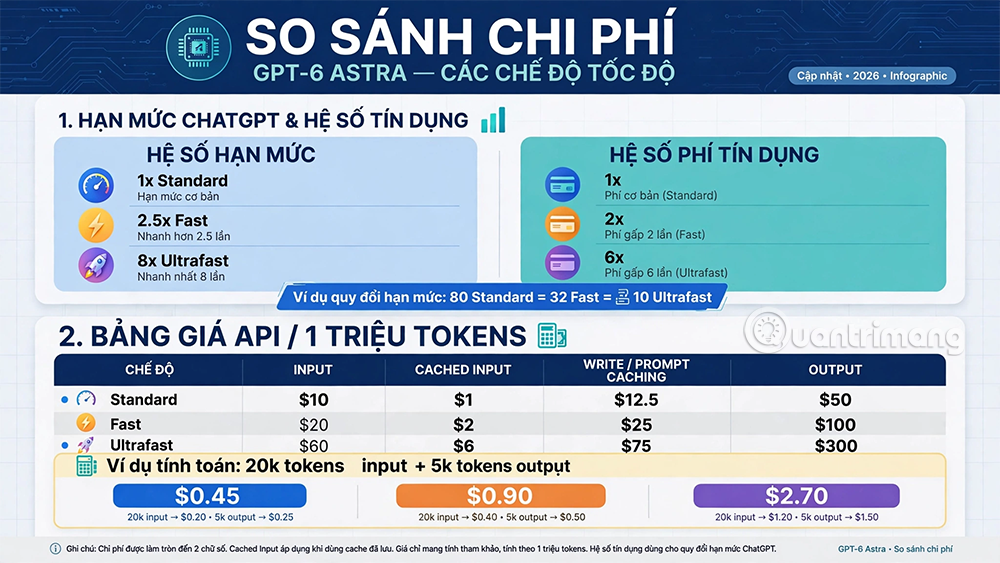
Trong API, giá GPT-6 Astra theo USD cho mỗi triệu token, áp dụng cho prompt có tối đa 272.000 token đầu vào, như sau:
|
Chế độ |
Đầu vào |
Đầu vào đã cache |
Ghi cache |
Đầu ra |
|
Standard |
10 USD |
1 USD |
12,50 USD |
50 USD |
|
Fast |
20 USD |
2 USD |
25 USD |
100 USD |
|
Ultrafast |
60 USD |
6 USD |
75 USD |
300 USD |
Khi so sánh, hãy giữ nguyên mô hình. Đầu vào đã cache là nội dung prompt đã được lưu lại để tái sử dụng, còn ghi cache là bước tạo nội dung lưu đó. Prompt dài hơn, công cụ, và xử lý theo vùng đều có thể làm thay đổi hóa đơn.
Ví dụ minh họa: với 20.000 token đầu vào thông thường (không cache) và tổng cộng 5.000 token đầu ra được tính phí, phí token sẽ là 0,45 USD ở Standard, 0,90 USD ở Fast và 2,70 USD ở Ultrafast. Con số này chưa tính phí ghi cache, công cụ và các khoản khác.
Lưu ý quan trọng: Chi phí API tách biệt với gói ChatGPT. Nếu bạn dùng Codex với khóa API riêng, bạn đang chịu giá API, nên các hệ số hạn mức và credit ở trên không áp dụng.
Bước 5: Chọn một mặc định và một ngoại lệ
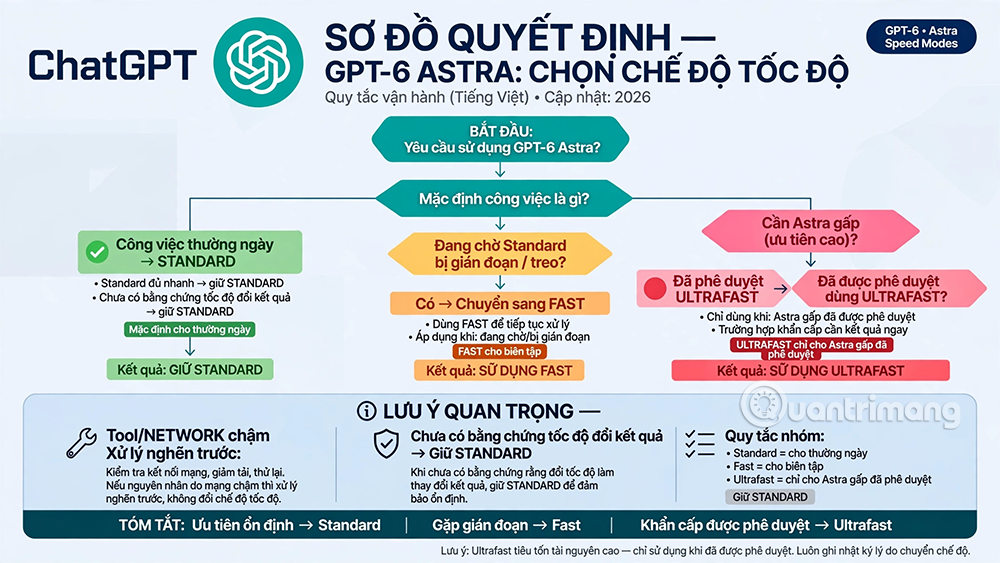
Bạn không nhất thiết phải dùng cùng một tốc độ cho mọi việc. Tuy nhiên, nên có một mặc định rõ ràng để tính năng mới không âm thầm làm tăng mức sử dụng của bạn.
|
Điều bạn đã nhận ra |
Lựa chọn của bạn |
|
Standard đủ nhanh và đạt tiêu chuẩn kiểm tra chất lượng |
Giữ Standard |
|
Thời gian chờ Standard làm gián đoạn công việc, còn Fast giúp lấy lại thời gian hữu ích |
Dùng Fast cho các tác vụ tương tác |
|
Bạn cần Astra, có quyền Ultrafast và thời gian tiết kiệm được xứng đáng với chi phí |
Dành Ultrafast cho công việc đó |
|
Công cụ, độ trễ mạng hoặc khâu rà soát chiếm phần lớn thời gian |
Xử lý các điểm nghẽn đó trước khi trả thêm cho tốc độ mô hình |
|
Chưa có bằng chứng rằng tốc độ nhanh hơn thay đổi kết quả |
Giữ Standard cho đến khi bạn có dữ liệu so sánh |
Với nhóm làm việc, hãy viết quy tắc bằng ngôn ngữ đơn giản, ví dụ: “Standard cho công việc thường ngày. Fast cho biên tập và phân tích đang diễn ra. Ultrafast chỉ cho các tác vụ Astra gấp đã được phê duyệt.”
Giữ tiêu chuẩn rà soát như nhau ở mọi tốc độ. Để so sánh công bằng, hãy cố định mô hình, mức suy luận, tác vụ, tài liệu nguồn, công cụ và điều kiện cache. Ghi lại tổng thời gian, số lỗi và chi phí của từng lượt thử.
3. Các lựa chọn AI thay thế phổ biến tại Việt Nam
Không phải ai cũng cần hoặc có quyền dùng Ultrafast. Nếu công việc của bạn chủ yếu là viết tiếng Việt, soạn nội dung hoặc phân tích tài liệu thông thường, bạn có thể thử đối chiếu với các công cụ quen thuộc sau trước khi nâng cấp:
- Gemini (Google): Tiện khi làm việc với Gmail, Google Docs và Drive. Google có nhiều mức mô hình khác nhau, nên hãy kiểm tra gói và mô hình đang chọn.
- Claude (Anthropic): Văn phong tự nhiên, xử lý tốt văn bản dài và hỗ trợ lập trình.
- Copilot: Tích hợp trong Word, Excel, Outlook và Microsoft 365.
- Perplexity: hữu ích khi cần tra cứu thông tin kèm nguồn.
Dù dùng công cụ nào, hãy làm cùng một bài thử: cùng đề bài, cùng tiêu chí, so sánh chất lượng tiếng Việt, thời gian chỉnh sửa và chi phí. Đừng chọn chỉ vì tốc độ hiển thị trên màn hình nhanh hơn.
4. Câu hỏi thường gặp
Ultrafast có phải là một mô hình mới không?
- Ultrafast là một chế độ xử lý nhanh hơn cho các mô hình được hỗ trợ, ví dụ GPT-6 Astra. Mô hình vẫn là Astra.
Gói ChatGPT Plus có dùng được Ultrafast không?
- Tại thời điểm ra mắt, Plus chưa có Ultrafast. Các gói Pro 100, Pro 200 và Business cũng chưa có, kể cả khi mua thêm credit. Gói Pro 500 có Ultrafast trong Work và Codex.
Dùng API có cần mua ChatGPT Pro 500 không?
- Theo tài liệu, Astra Ultrafast khả dụng cho mọi người dùng API, theo giới hạn tốc độ và vùng xử lý.
Fast luôn nhanh gấp 2,5 lần Standard sao?
- Đó là mức tối đa OpenAI công bố trên API, và kết quả thực tế phụ thuộc vào mô hình, sản phẩm và từng tác vụ. Tổng thời gian còn bao gồm công cụ, mạng và thời gian rà soát.
Bạn có nên luôn dùng chế độ nhanh nhất không?
- Chế độ nhanh nhất thường tốn nhiều hạn mức hoặc chi phí hơn. Hãy dùng khi thời gian tiết kiệm được thực sự có giá trị với công việc của bạn.
Tốc độ có ảnh hưởng đến chất lượng câu trả lời không?
- OpenAI mô tả đây là cách tăng tốc độ mà vẫn giữ trí tuệ của mô hình. Tuy vậy, bạn vẫn nên kiểm tra chất lượng bằng cùng một tiêu chuẩn ở mọi chế độ.
5. Kết luận
Việc bạn chọn giữa Standard, Fast và Ultrafast là bài toán cân bằng giữa thời gian, hạn mức và chi phí. Với đa số công việc hằng ngày, Standard vẫn là lựa chọn tiết kiệm và đủ dùng. Fast hợp với các phiên làm việc cần phản hồi ngay và luôn. Ultrafast chỉ nên dành cho những tác vụ Astra gấp, có nhiều lượt trao đổi và đã có quyền sử dụng hợp lệ.
Trước khi nâng cấp, hãy kiểm tra xem điều gì thực sự làm chậm công việc. Đôi khi nguyên nhân nằm ở công cụ bên ngoài, ở prompt quá dài, hoặc ở khâu rà soát thủ công, không phải ở tốc độ mô hình. Hãy bắt đầu với một mặc định rõ ràng, thử nghiệm có kiểm soát và chỉ tăng tốc khi kết quả chứng minh được giá trị.
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học