AI
 Hướng dẫn AI
 Claude
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích
GPT-5.4 hay Claude Opus 4.6 là mô hình tốt nhất cho các tác vụ tự động hóa?

Mua gói Thành viên QuanTriMang Pro để trải nghiệm website không quảng cáo và sử dụng các tiện ích AI trên QuanTriMang.
Vài năm trước, bạn khó lòng có thể dùng một mô hình ngôn ngữ lớn để viết một email tử tế. Khi OpenAI phát hành mô hình mã nguồn mở đầu tiên, thật đáng kinh ngạc khi thấy nó tạo ra văn bản mạch lạc. Chỉ vài năm sau, chúng ta đã có các mô hình AI có thể xây dựng toàn bộ dự án kỹ thuật phần mềm, đặt lịch họp, mua sản phẩm trên Amazon, v.v... Năm 2026, bối cảnh đã thực sự thay đổi, và câu hỏi mà các nhà phát triển đang đặt ra là mô hình nào sẽ phù hợp với trường hợp sử dụng của họ.
GPT-5.4 và Claude Opus 4.6 hiện đang là tâm điểm của câu hỏi đó. Cả hai đều có khả năng khác nhau và được ra mắt chỉ cách nhau vài tuần. Tuy nhiên, cả hai mô hình đều có giá khác nhau và hoạt động tốt nhất trong những kịch bản khác nhau.
Bài viết này sẽ giúp bạn quyết định mô hình nào phù hợp nhất với quy trình làm việc của mình.
Mục lục bài viết
Claude Opus 4.6 là gì?
Claude Opus 4.6 là mô hình mạnh mẽ nhất của Anthropic cho đến nay. Opus 4.6 là phiên bản cải tiến của mô hình trước đó, với những cải tiến quan trọng trong lập trình và các tác vụ agent kéo dài. Anthropic cho biết nó hoạt động tốt hơn trong việc lập kế hoạch, xem xét code và gỡ lỗi, thậm chí còn tự phát hiện ra lỗi của chính mình.
Các tính năng và khả năng chính của Claude Opus 4.6
Anthropic đã phát hành Opus 4.6 với cửa sổ ngữ cảnh 1 triệu token ở phiên bản beta, với đầu ra tối đa là 128 nghìn token. Điều này giúp mô hình có khả năng hoạt động trong một codebase lớn và xử lý các tài liệu lớn, chẳng hạn như tài liệu hướng dẫn.
Phiên bản này cũng có tính năng Adaptive Thinking, có nghĩa là Claude giờ đây có thể tự quyết định khi nào cần tham gia vào quá trình tư duy mở rộng thay vì phải chờ bạn bật thủ công.
Claude Opus 4.6 có thể quyết định xem một vấn đề cần sửa chữa nhanh chóng hay cần thêm thời gian để suy luận và lập kế hoạch khắc phục. Tôi nghĩ điều này sẽ rất hữu ích cho việc giải quyết các vấn đề kỹ thuật phức tạp. Không có gì ngạc nhiên khi mô hình này đứng đầu bảng xếp hạng về xử lý văn bản và lập trình.

Trong các bài kiểm tra lập trình, Claude Opus 4.6 đạt 81,42% trên SWE-Bench Verified, bài kiểm tra đánh giá khả năng giải quyết các vấn đề thực tế trên GitHub của mô hình. Mô hình này cũng đạt điểm cao nhất trong Humanity’s Last Exam.
Khi không sử dụng công cụ, Claude Opus 4.6 được chạy với tính năng tư duy thích ứng được bật. Khi chạy với các công cụ, các mô hình Claude sử dụng gọi công cụ lập trình, nén ngữ cảnh ở mức 50.000 token lên đến tổng cộng 3 triệu token, nỗ lực suy luận tối đa, và tính năng tư duy thích ứng được bật.

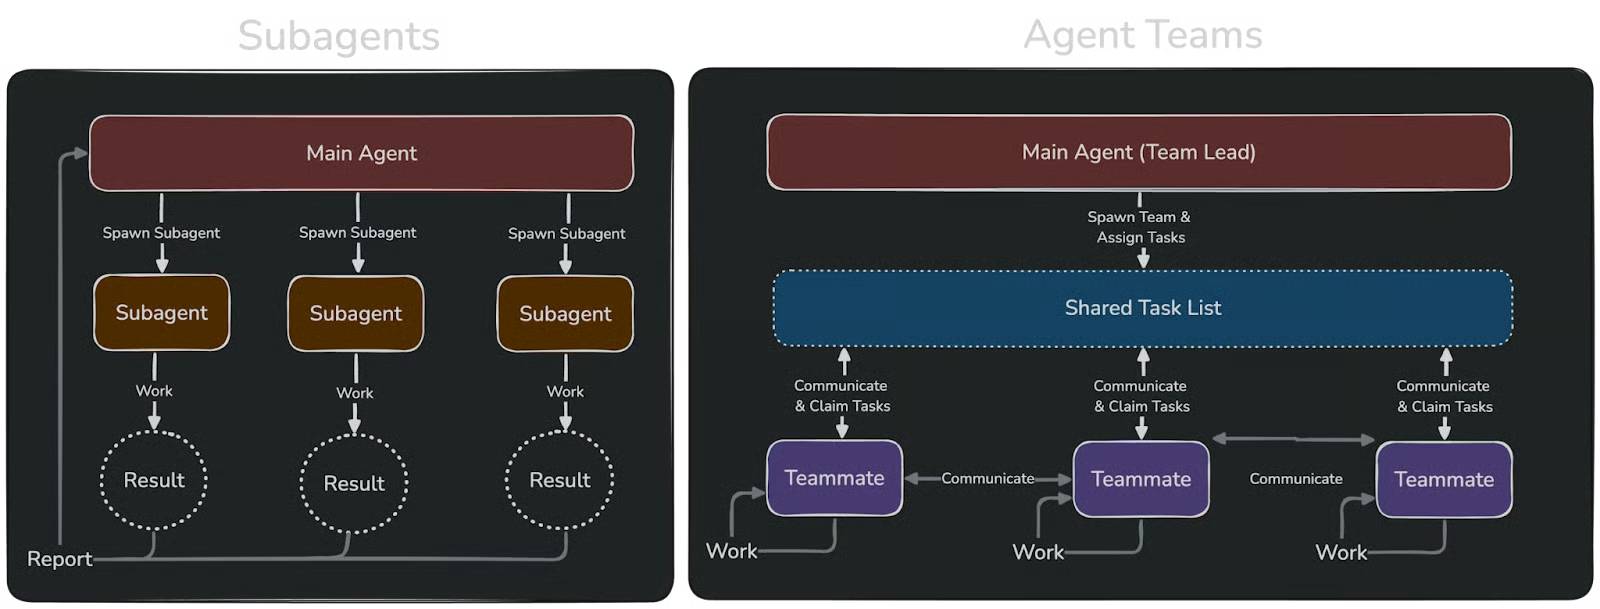
Với Opus 4.6, Claude cũng giới thiệu Agent Teams như một tính năng thử nghiệm trong Claude Code. Khi bật tính năng này, bạn có thể khởi tạo nhiều agent để thực hiện các nhiệm vụ. Các agent làm việc cùng nhau như một nhóm, với các nhiệm vụ được chia sẻ và nhắn tin giữa các agent.
Ưu và nhược điểm của Claude Opus 4.6
Claude Opus 4.6 là một mô hình agentic rất mạnh mẽ. Trên thực tế, nhà phát triển OpenClaw khuyến nghị sử dụng nó trong OpenClaw vì mô hình này khó bị tấn công Prompt injection. Điều này giúp mô hình có khả năng chống chịu tốt hơn trước các đoạn mã độc.
Tính năng "Agents Teams", dù vẫn đang trong giai đoạn thử nghiệm, lại là một bước nâng cấp vượt bậc so với các sub-agents. Với tính năng này, bạn có thể chia nhỏ công việc cho nhiều agent Claude cùng thực hiện. Ví dụ, một agent có thể xử lý phần backend, một agent lo phần frontend, và một agent khác thực hiện các bài kiểm thử. Mỗi agent đều có cửa sổ ngữ cảnh riêng, nhờ đó giảm thiểu nguy cơ thất bại do giới hạn về dung lượng ngữ cảnh.
Claude Opus 4.6 là một mô hình mạnh mẽ, nhưng "không có gì là miễn phí cả". Chi phí vận hành mô hình này không hề rẻ, đặc biệt nếu bạn là người dùng với tần suất cao.
Trong khi đó, Anthropic cũng đã ra mắt phiên bản kế nhiệm của nó. Đừng quên tham khảo bài viết hướng dẫn của Quantrimang.com về Claude Opus 4.7 nhé!
GPT-5.4 là gì?
GPT-5.4 là mô hình mới nhất và mạnh mẽ nhất của OpenAI. Nó được xây dựng bằng cách kết hợp khả năng lập trình của GPT-5.3-Codex với khả năng suy luận để tạo ra một mô hình duy nhất nhưng đầy uy lực. Điều này có nghĩa là bạn không còn cần phải chuyển đổi giữa những mô hình Codex để lập trình và các mô hình OpenAI khác cho những tác vụ khác nữa.
Các tính năng và khả năng chính của GPT-5.4
Tính năng của GPT-5.4 thú vị nhất là khả năng sử dụng máy tính. Trên OSWorld – một bộ tiêu chuẩn đánh giá khả năng sử dụng máy tính của mô hình – GPT-5.4 đạt điểm số 75,0%, trong khi hiệu suất của con người là 72,4%. Để so sánh, GPT-5.2 chỉ đạt 47,3% trong cùng bài kiểm tra này.
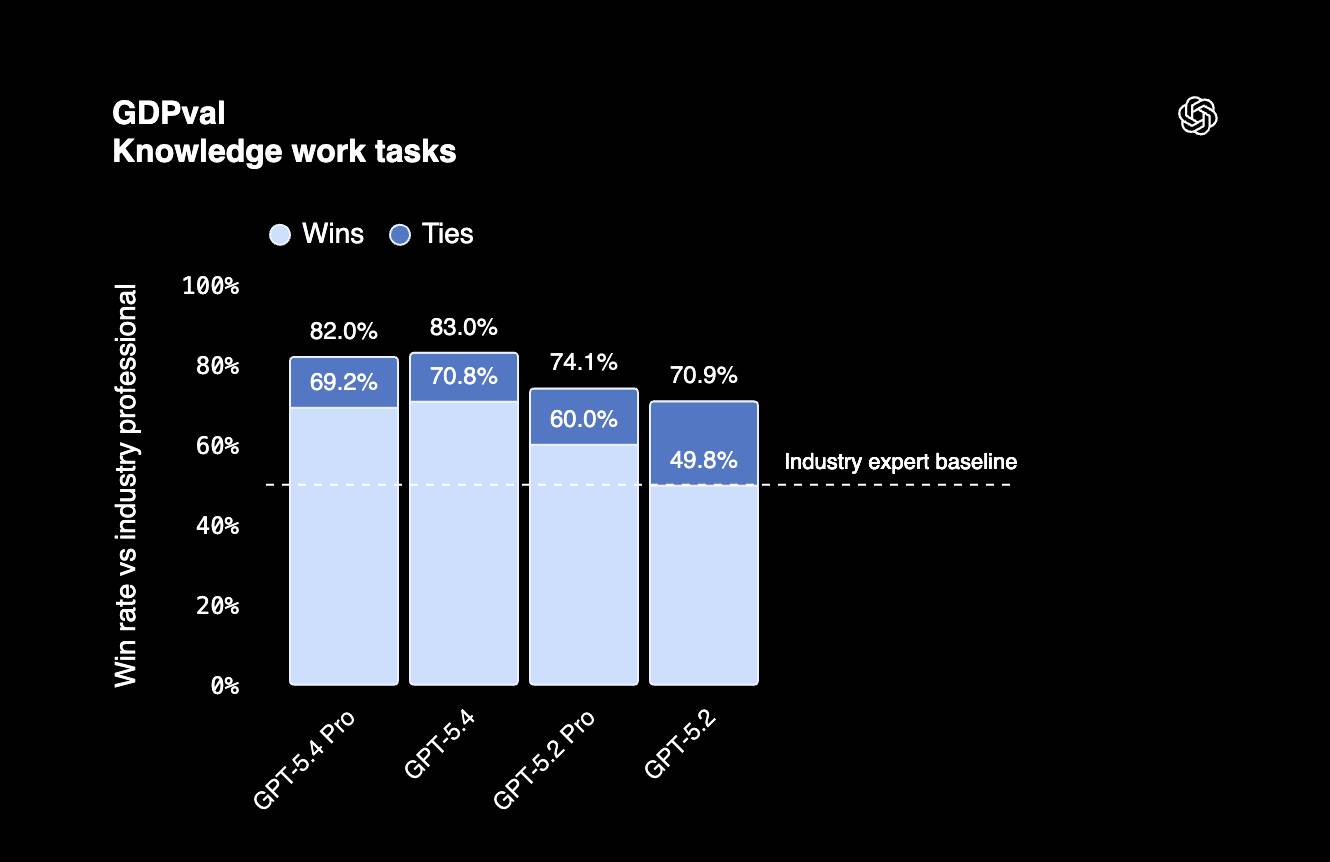
Trên GDPval – bộ tiêu chuẩn đánh giá công việc chuyên môn thuộc 44 ngành nghề khác nhau – GPT-5.4 đạt 83%. Điều này có nghĩa là mô hình có thể thực hiện các tác vụ agentic trong các công việc hàng đầu ở trình độ của một chuyên gia.
GPT-5.4 cũng sở hữu hiệu suất sử dụng token tối ưu, nghĩa là nó tiêu tốn ít token hơn so với các mô hình trước đó cho nhiều tác vụ. Đây là điểm cần lưu ý nếu bạn thực hiện nhiều yêu cầu mỗi ngày.
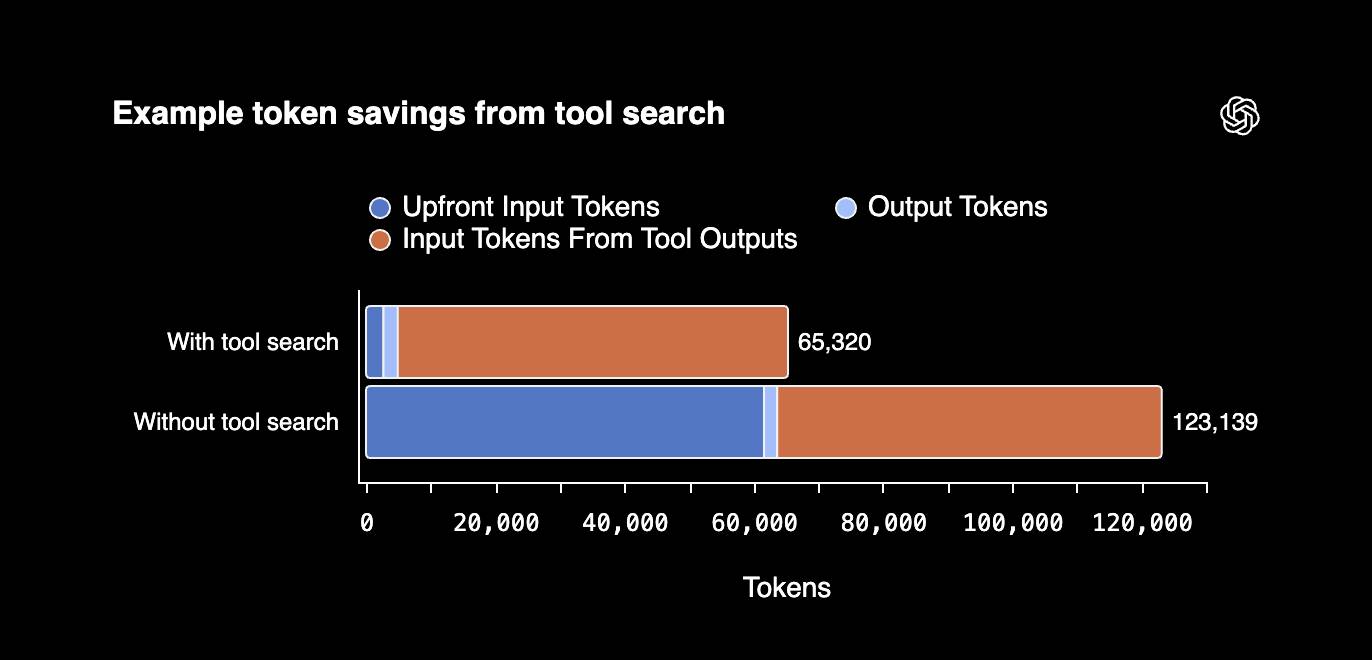
GPT-5.4 cũng giới thiệu hệ thống Tìm kiếm Công cụ (Tool Search), giúp mô hình hoạt động hiệu quả khi được cung cấp nhiều công cụ. Thay vì phải đưa định nghĩa công cụ vào câu lệnh (prompt) – việc vốn làm tăng số lượng token – giờ đây mô hình được cung cấp danh sách các công cụ cùng khả năng tìm kiếm chúng. Khi cần dùng công cụ nào, mô hình sẽ tự tra cứu và thêm công cụ đó vào cuộc hội thoại cụ thể đang diễn ra. Điều này giúp tối ưu hóa việc sử dụng token.
Ưu và nhược điểm của GPT-5.4
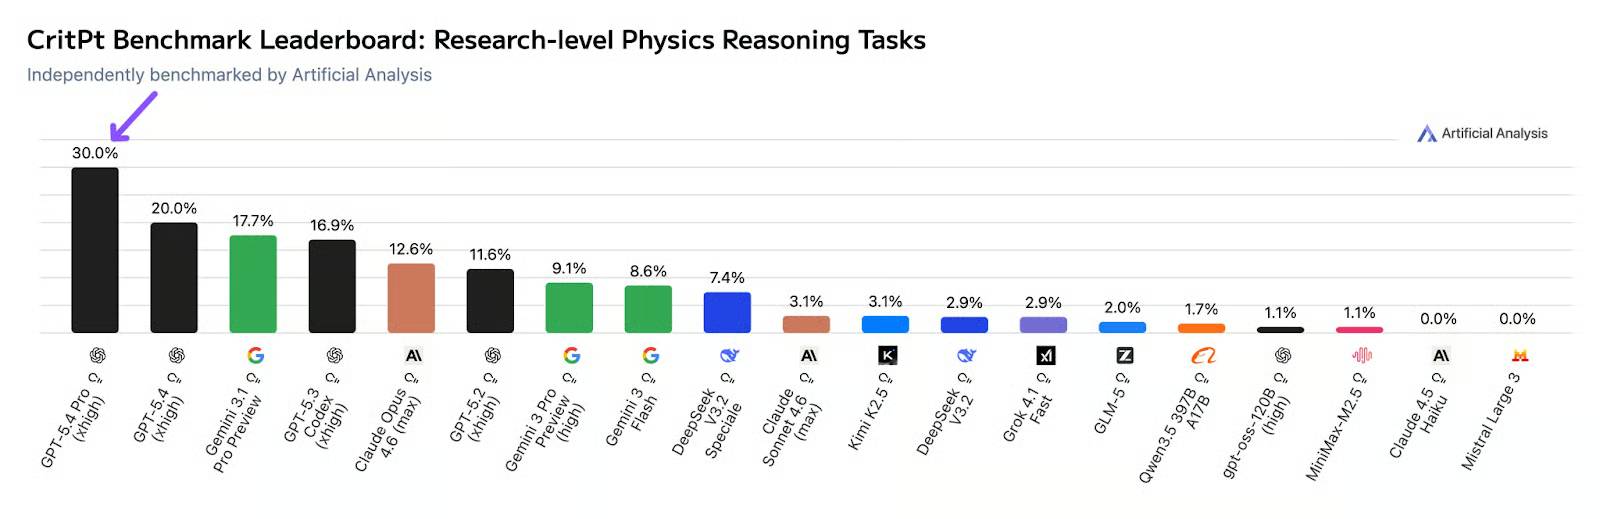
Tính năng khiến nhiều người ấn tượng nhất là khả năng vượt qua con người của GPT-5.4 trong việc tự động sử dụng máy tính. Nó vượt trội hơn Claude Opus 4.6 ở khía cạnh này, đạt 75% điểm số trên các bài kiểm tra OSWorld, so với mức 72,7% của Opus 4.6. Nghiên cứu độc lập từ Artificial Analysis cho thấy GPT-5.4 (xhigh) đạt điểm số 30% trên bộ chuẩn CritPt – hệ thống đánh giá các mô hình ngôn ngữ lớn (LLM) thông qua 71 thử thách nghiên cứu tổng hợp đòi hỏi khả năng suy luận vật lý ở cấp độ nghiên cứu.
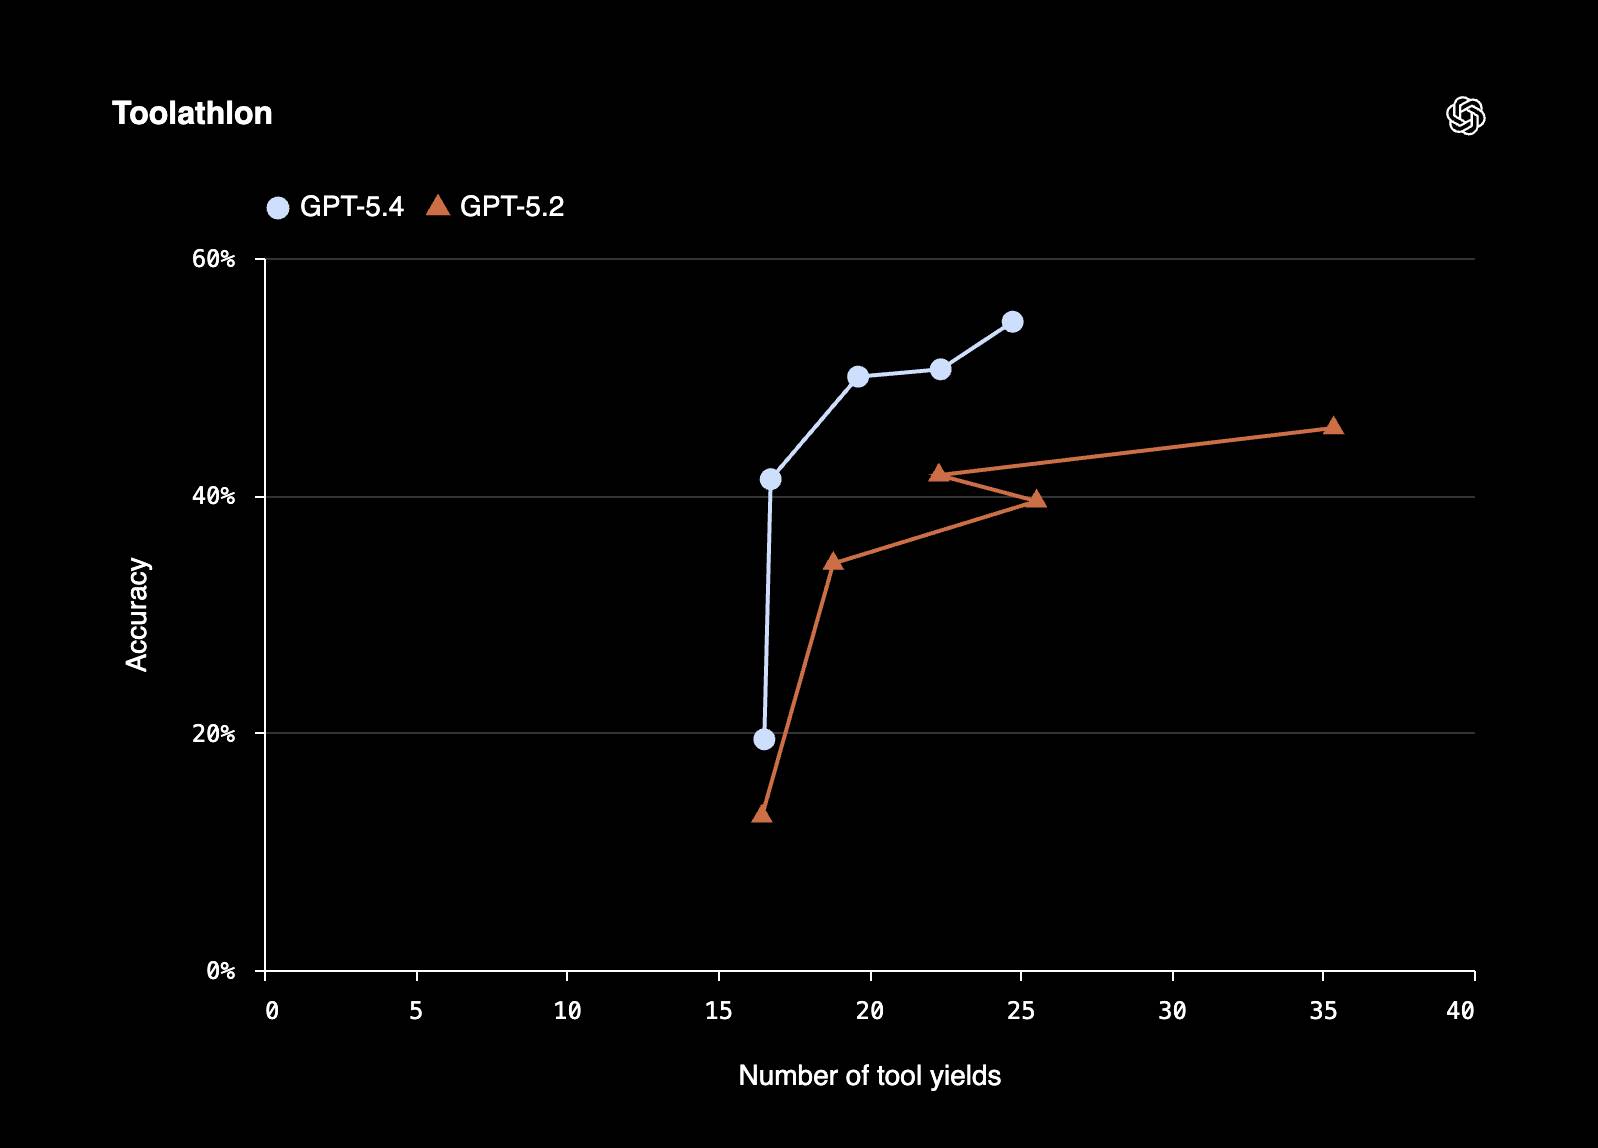
GPT-5.4 thể hiện khả năng gọi công cụ tốt và chính xác hơn. Trong báo cáo phát hành, OpenAI ghi nhận mô hình này đạt kết quả tốt hơn với ít bước thực hiện hơn trên Toolathlon – bộ chuẩn đánh giá cách những agent sử dụng các công cụ và API thực tế để hoàn thành những tác vụ gồm nhiều bước.
Tương tự như Claude Opus 4.6, GPT-5.4 cũng không phải là một mô hình có chi phí thấp. Tuy nhiên, rất may là OpenAI cung cấp mức giá ưu đãi hơn cho API suy luận hàng loạt.
So sánh trực tiếp GPT-5.4 và Claude Opus 4.6
Bây giờ, hãy cùng so sánh GPT-5.4 và Opus 4.6 để xác định mô hình nào phù hợp nhất với trường hợp sử dụng của bạn.
Nhìn chung, GPT-5.4 là mô hình tốt nhất theo Artificial Analysis Intelligence Index (AII), đo lường hiệu suất của các mô hình trên nhiều tiêu chuẩn khác nhau. Chỉ có Gemini 3.1 Pro là vượt trội hơn.

Hiệu suất sử dụng agent và máy tính
Claude Opus 4.6 thắng thế khi nói đến điều phối multi-agent. Với tính năng Agent Teams, bạn có thể chạy nhiều quy trình làm việc với các agent song song thực hiện những nhiệm vụ khác nhau.
GPT-5.4 thắng sát nút về hiệu suất sử dụng máy tính. Nếu agent của bạn cần vận hành desktop, duyệt trình duyệt hoặc tương tác với phần mềm dựa trên giao diện đồ họa người dùng (GUI), thì GPT-5.4 là lựa chọn tốt hơn hiện nay.
Benchmark lập trình
Claude Opus 4.6 là lập trình viên tốt hơn với điểm số 80,84% trên SWE-Bench Verified và 81,4% khi sử dụng prompt được sửa đổi.
GPT-5.4 kế thừa khả năng lập trình của GPT-5.3-Codex. Theo OpenAI, GPT-5.4 đạt điểm số 57,7% trên SWE-Bench Pro (Public) với độ trễ thấp hơn trong các tác vụ suy luận.

Chi phí và hiệu quả sử dụng token
Trong báo cáo của mình, OpenAI tuyên bố rằng GPT-5.4 đã chứng minh giảm 47% lượng token sử dụng trong một số tác vụ nhất định. Mặc dù đắt hơn Opus 4.6, GPT-5.4 có thể rẻ hơn khi vận hành ở quy mô lớn nhờ việc giảm token này.
Tuy nhiên, Opus 4.6 vẫn có thể là mô hình tốt hơn để thực hiện ít tác vụ phức tạp hơn.
Để dễ hình dung, mô hình GPT-5.4 mạnh nhất (độ dài ngữ cảnh > 272K) có giá 60 USD cho 1 triệu token đầu vào và 270 USD cho 1 triệu token đầu ra, trong khi Claude Opus 4.6 có giá 5 USD cho 1 triệu token đầu vào và 25 USD cho 1 triệu token đầu ra.
Cửa sổ ngữ cảnh và bộ nhớ
Cả GPT-5.4 và Claude Opus 4.6 đều hỗ trợ tối đa 1 triệu token ngữ cảnh, mặc dù phiên bản của Claude vẫn đang trong giai đoạn beta. Điều này khiến cả hai mô hình đều là đối thủ cạnh tranh mạnh mẽ khi làm việc với các cơ sở code lớn.
Bảng so sánh
|
Tiêu chí |
Claude Opus 4.6 |
GPT-5.4 |
|
Tác vụ tự động hóa |
Mạnh mẽ (Agent Teams, điều phối song song) |
Thành thạo (sử dụng máy tính, OSWorld 75%) |
|
Benchmark lập trình |
SWE-Bench đạt 80,2% với khả năng tư duy |
57,7% trên SWE-Bench Pro (Public) |
|
Sử dụng máy tính |
72.7% trên OSWorld |
OSWorld 75% (vượt trội hơn cả các chuyên gia là con người) |
|
Cửa sổ ngữ cảnh |
1M token (beta), 128K đầu ra tối đa |
1M token |
|
Công việc trí thức |
Humanity's Last Exam leader |
GDPval 83% |
|
Định giá (đầu vào/đầu ra) |
Giá token đầu vào cơ bản là $5 Giá token đầu ra là $25 cho mỗi triệu token |
gpt-5.4 (<272K độ dài ngữ cảnh) có giá 2,50 USD cho 1 triệu token đầu vào và 15 USD cho 1 triệu token đầu ra. Các mô hình có cửa sổ ngữ cảnh lớn sẽ đắt hơn. |
|
Hiệu quả token |
Tiêu chuẩn |
Giảm 47% số token cho một số tác vụ |
|
Phù hợp nhất cho |
Các agent hoạt động lâu dài, cơ sở mã phức tạp |
Sử dụng máy tính, quy trình làm việc tài liệu, doanh nghiệp |
Nên chọn GPT-5.4 hay Claude Opus 4.6?
Cuối cùng, hãy cùng trả lời câu hỏi quan trọng nhất: Bạn nên chọn cái nào trong hai cái này?
Bạn nên chọn Claude Opus 4.6 nếu…
- Bạn đang xây dựng hoặc vận hành các agent hoạt động trong những codebase lớn trong thời gian dài.
- Bạn muốn có quy trình làm việc multi-agent, nơi các agent khác nhau hoạt động song song và chuyển giao nhiệm vụ cho nhau.
- Quy trình làm việc của bạn liên quan đến các tài liệu rất dài, những file code dài hoặc các tác vụ yêu cầu nắm giữ một lượng lớn ngữ cảnh.
- Bạn đã ở trong hệ sinh thái Anthropic và nhóm của bạn đã quen thuộc với Claude.
Bạn nên chọn GPT-5.4 nếu…
- AI agent của bạn cần vận hành máy tính. Nhấp chuột, gõ, điều hướng ứng dụng và điền vào biểu mẫu một cách tự động.
- Bạn làm việc trong các lĩnh vực chuyên nghiệp như tài chính, pháp lý hoặc vận hành, và cần mô hình hoạt động ở cấp độ của một chuyên gia trong ngành.
- Bạn muốn giảm chi phí API ở quy mô lớn. Việc cải thiện hiệu quả sử dụng token lên đến 47% đối với một số tác vụ sẽ tích lũy dần qua hàng nghìn lần hoàn thành mỗi ngày.
- Bạn muốn một mô hình duy nhất cho mọi thứ mà không cần phải chuyển đổi giữa các mô hình chuyên biệt.

Triển vọng tương lai
Các mô hình của Anthropic từ lâu đã là lựa chọn hàng đầu cho lập trình, nhưng chúng cũng tỏa sáng trong những lĩnh vực không ngờ tới như viết sáng tạo. Trên thực tế, nhiều người cho rằng chúng là những mô hình tốt nhất trong ngành ở lĩnh vực này.
Nhưng Anthropic chưa bao giờ công khai tuyên bố rằng các mô hình của họ chuyên về bất kỳ tác vụ cụ thể nào, giống như cách OpenAI tuyên bố rằng mô hình Codex được thiết kế đặc biệt cho lập trình.
Thật thú vị khi OpenAI hiện đang đi theo hướng của Anthropic. Với các bản phát hành mới nhất, họ đang hướng tới một mô hình duy nhất, thống nhất xử lý rất nhiều tác vụ chuyên nghiệp. Đây là một thắng lợi lớn cho người dùng; không ai muốn liên tục chuyển đổi giữa các mô hình chuyên biệt để hoàn thành công việc của mình.
Mặt khác, thật tốt khi thấy Anthropic áp dụng cửa sổ ngữ cảnh 1 triệu token, điều mà các mô hình khác đã có từ lâu (như Gemini 3). Trong tương lai, các mô hình này sẽ có những tính năng rất giống nhau, đến mức những yếu tố gây cản trở cho người dùng sẽ rất ít. Tuy nhiên, hiệu suất của mô hình trên các tác vụ khác nhau sẽ là yếu tố khác biệt chính, vì người dùng sẽ ưu tiên các mô hình hoạt động tốt trong quy trình làm việc cụ thể của họ.
Kết luận
Năm 2026, cả Anthropic và OpenAI đều có các mô hình mạnh mẽ cho công việc tự động hóa. Điều có thể khiến bạn bối rối là chúng báo cáo các benchmark khác nhau. Có lẽ họ đang chọn lọc những lĩnh vực mà mô hình của mình sẽ tỏa sáng.
Bây giờ, bạn cần tham khảo các phân tích độc lập về những benchmark khác và thử nghiệm chúng trên các trường hợp sử dụng của riêng mình. Tuy nhiên, điều rõ ràng là các mô hình đang ngày càng tốt hơn. Và bạn cũng nên sử dụng chúng tốt hơn. Một cách để đảm bảo bạn không bị tụt hậu trong phong trào tự động hóa này là nắm vững cách sử dụng hiệu quả các mô hình này cho kỹ thuật phần mềm.
Bạn nên đọc
-
Cách chế độ Voice Mode của ChatGPT giúp bạn hoàn thiện một ý tưởng mới
-
Bí quyết cải thiện câu trả lời ChatGPT nhờ vòng lặp phản biện
-
Tìm hiểu về Claude Opus 4.6
-
Cách chọn đúng mô hình ChatGPT cho từng tác vụ
-
Claude Sonnet 5 có gì mới?
-
OpenAI ra mắt GPT-5.4 – mô hình mạnh nhất hiện nay, tối ưu cho công việc chuyên nghiệp
-
8 cách sử dụng ChatGPT cho SEO thật sự thiết thực
-
Các mô hình OpenAI hiện có và công dụng tốt nhất của chúng
-
Tính năng Dự Án trong ChatGPT là gì? Hướng dẫn sử dụng từ A đến Z

Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 ChatGPT
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học