 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

Việc chạy AI cục bộ thường bắt đầu bằng việc nâng cấp card đồ họa và kết thúc với một chiếc ví rỗng. Tuy nhiên, các mô hình hiện đại đã vượt xa những mô hình ngôn ngữ lớn (LLM) chạy cục bộ thời kỳ đầu; bạn không nhất thiết cần một máy trạm mạnh mẽ để đạt được kết quả hữu ích. Bí quyết nằm ở việc chọn mô hình phù hợp với phần cứng của bạn và biết rõ nên giao cho nó những tác vụ nào.
Bạn sẽ không thể chạy một mô hình thay thế ChatGPT trên một chiếc laptop giá rẻ với GPU 4GB và RAM 16GB, nhưng bạn hoàn toàn có thể tìm thấy một trợ lý nhỏ gọn hơn, đủ khả năng xử lý các yêu cầu hàng ngày mà không cần gửi dữ liệu lên đám mây. Những mô hình tinh gọn này khiến sự đánh đổi đó trở nên xứng đáng.
LFM3-1.7B: Mô hình phù hợp ngay cả khi không còn lựa chọn nào khác
Dung lượng khoảng 1GB trên ổ cứng, được thiết kế cho các agent thay vì cố gắng đóng vai một ChatGPT toàn năng
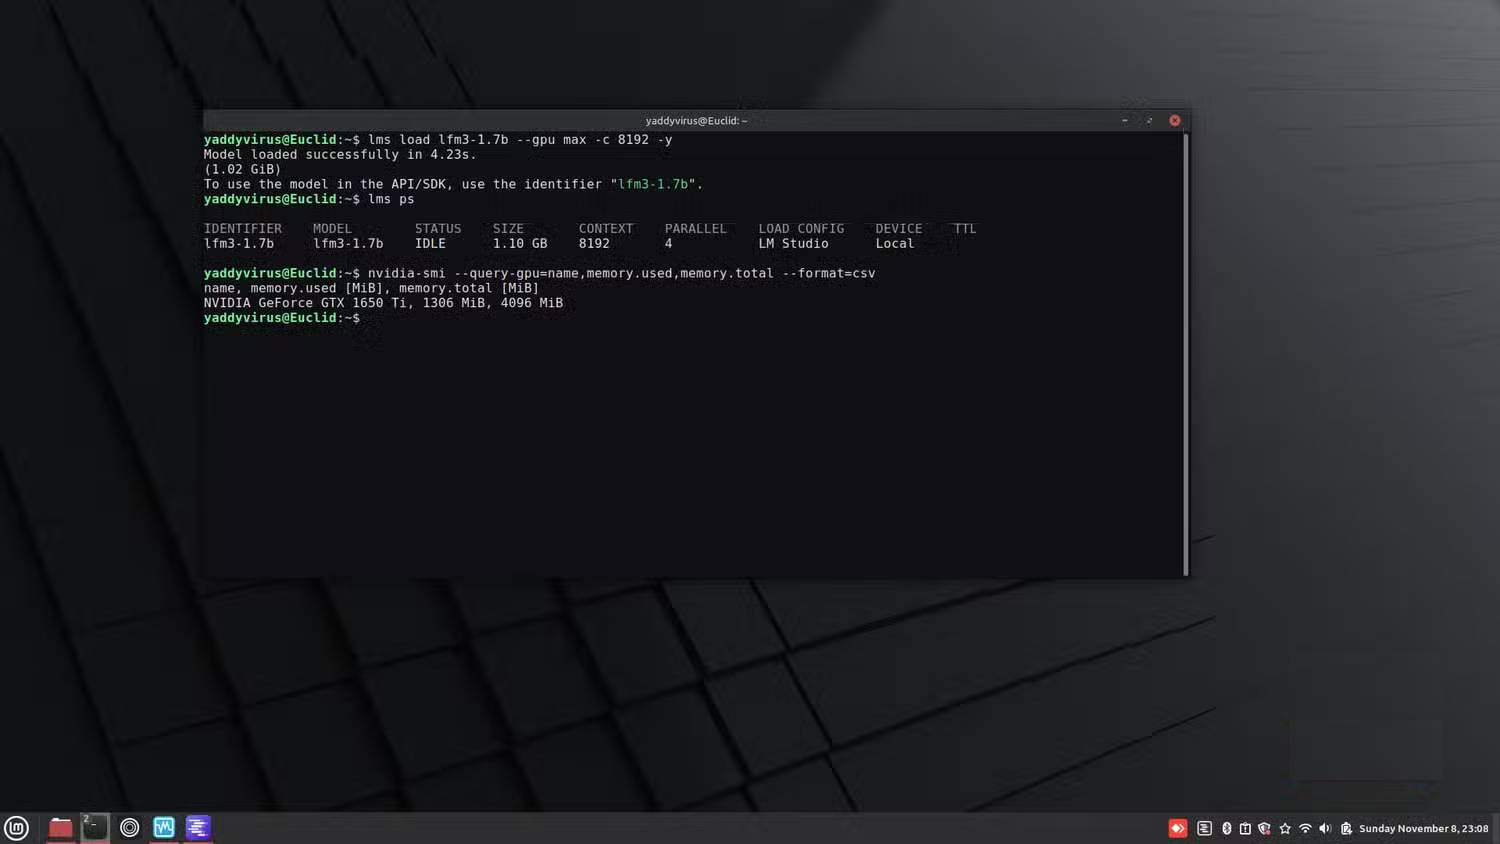
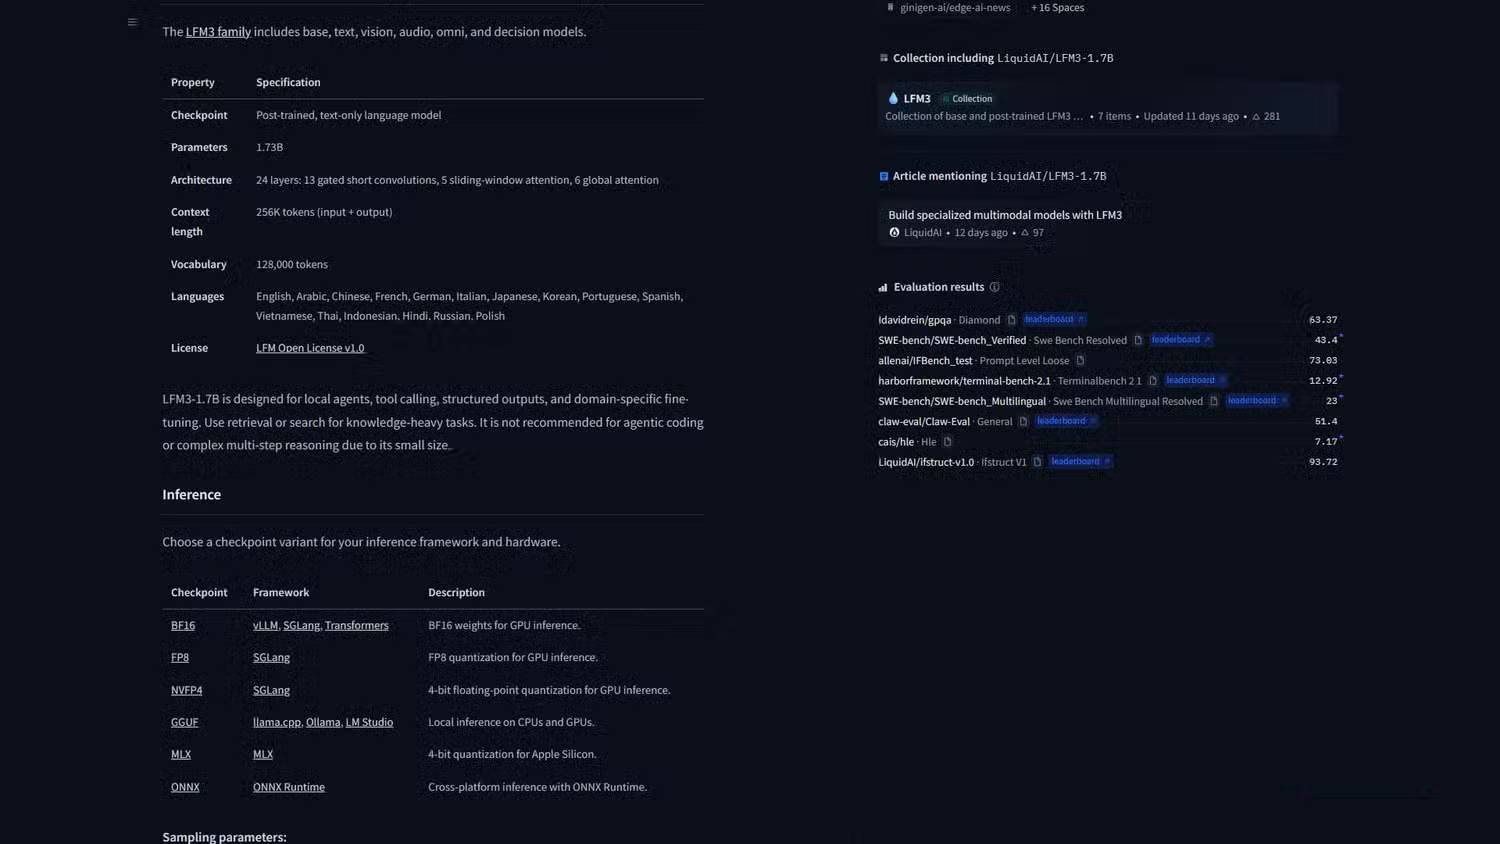
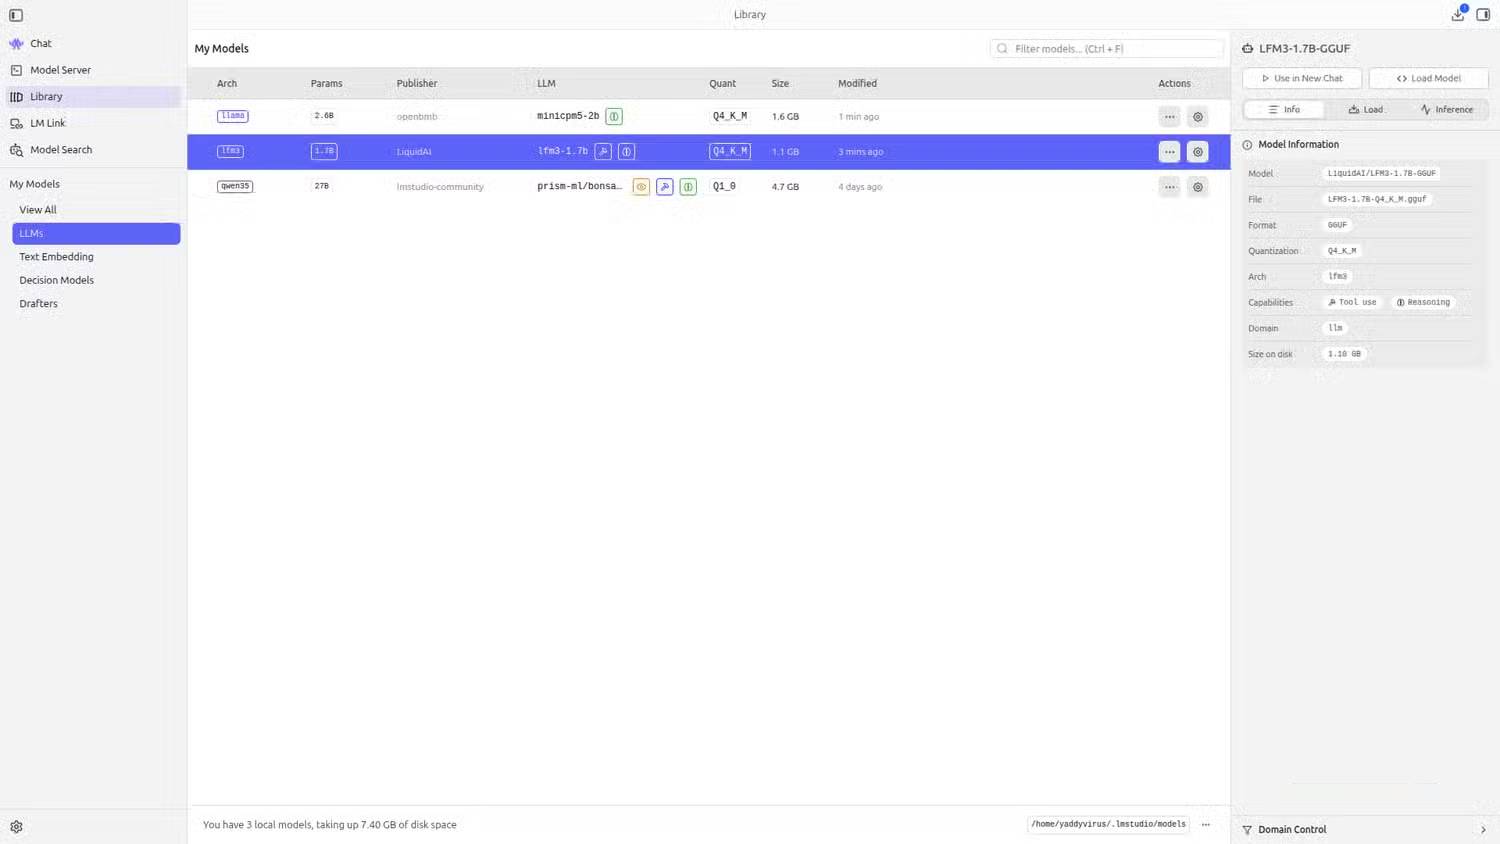
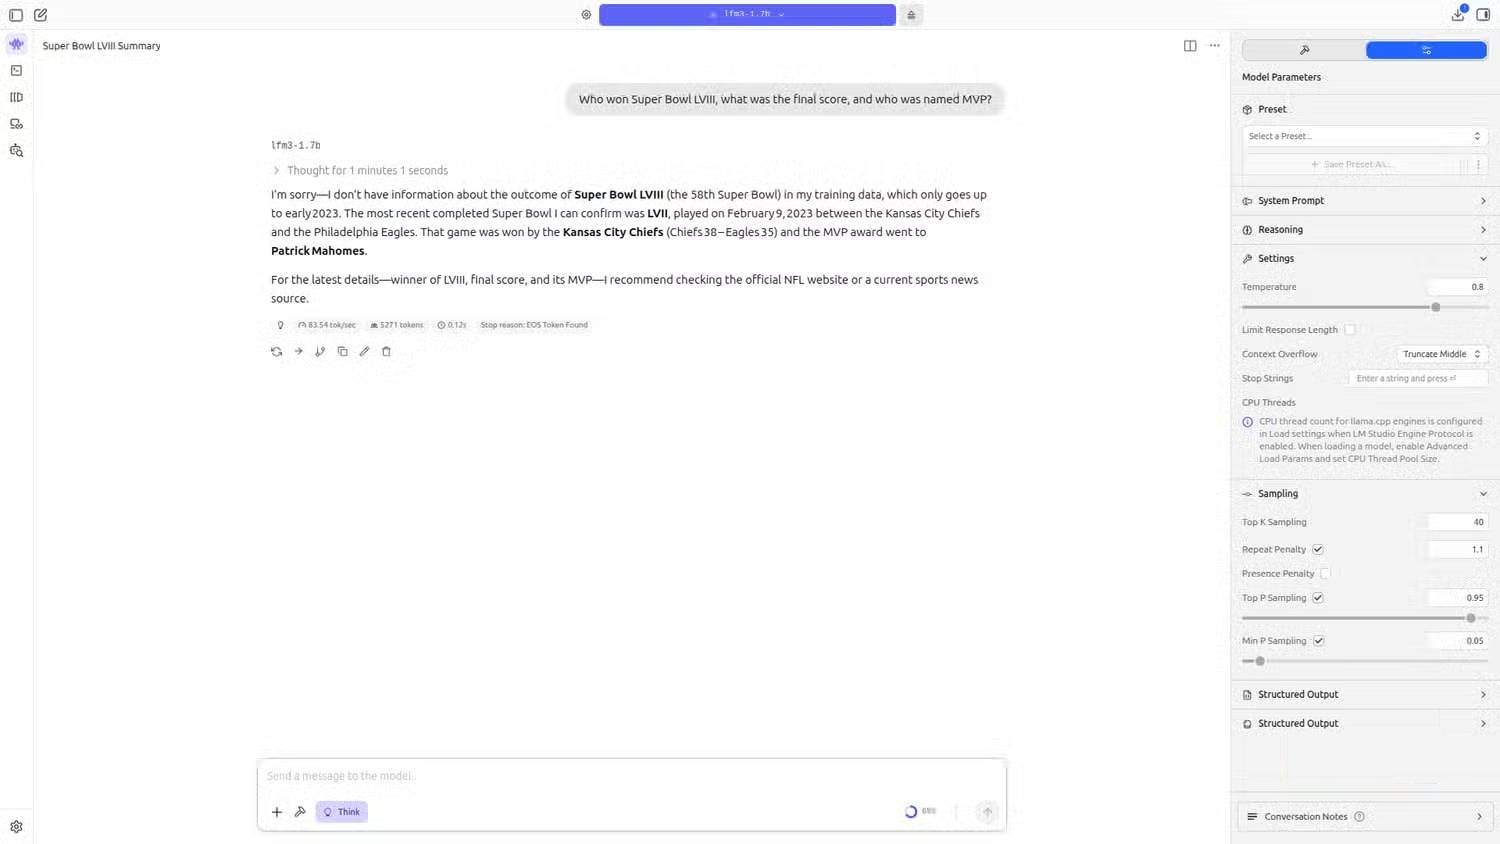
Mô hình LFM3-1.7B (ra mắt tháng 10/2026) của Liquid AI là một trong những lựa chọn khởi đầu tốt nhất cho một LLM nhỏ gọn, có thể chạy trên hầu hết mọi thiết bị. Với 1,73 tỷ tham số, phiên bản Q4_K_M của mô hình này có dung lượng tải xuống khoảng 1,1GB. Điều này để lại nhiều không gian hơn cho các tác vụ vận hành (runtime overhead) so với những mô hình mà riêng phần trọng số đã chiếm gần hết bộ nhớ GPU của bạn.
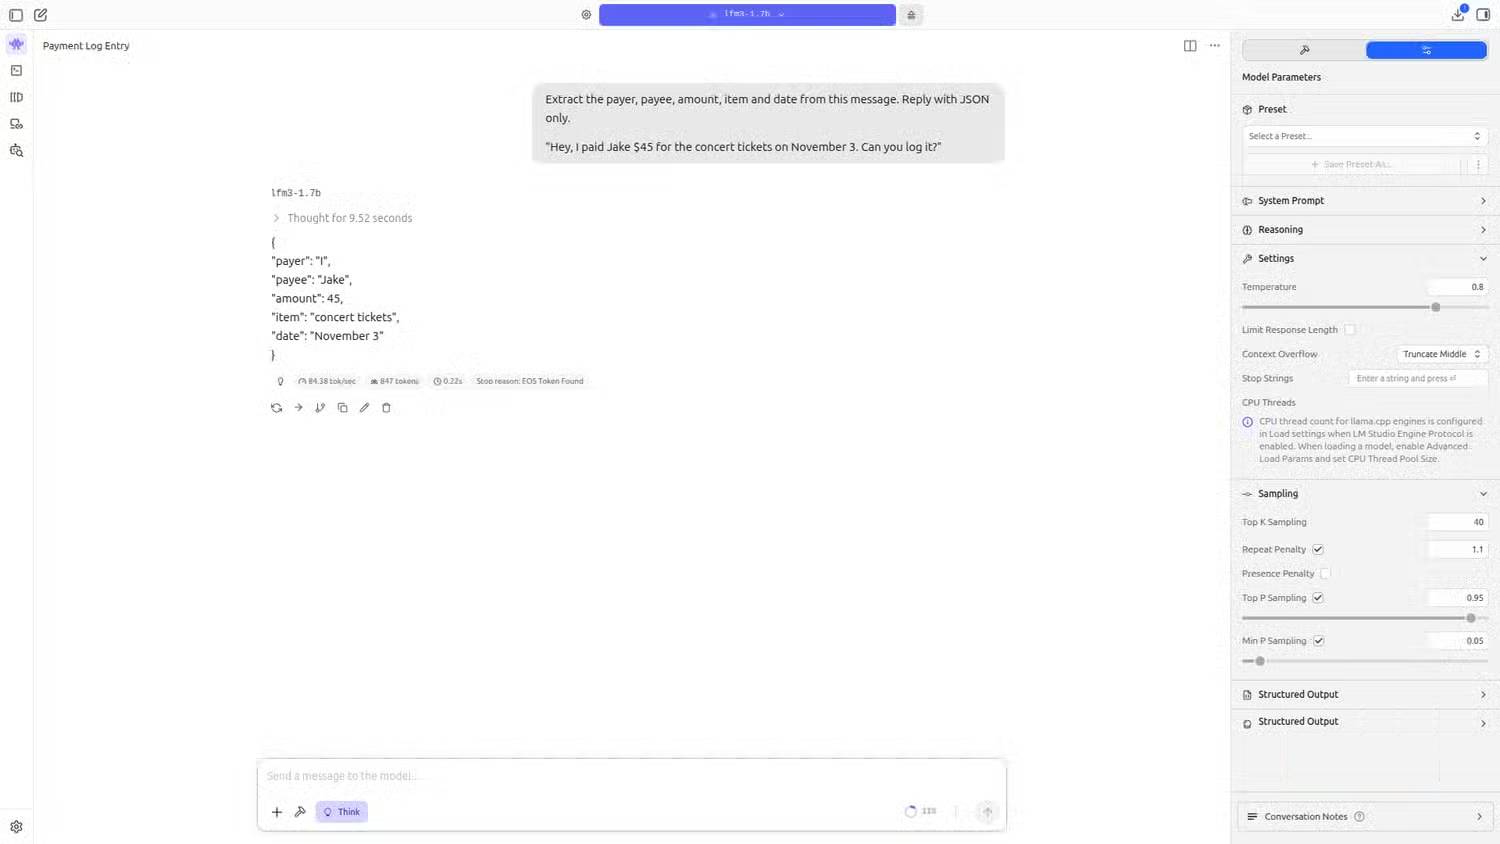
Mục đích thiết kế của nó là phục vụ các agent cục bộ, gọi công cụ, tạo đầu ra có cấu trúc và các ứng dụng chuyên biệt, chứ không phải để trở thành một chatbot "biết tuốt". Hãy coi nó như một công cụ để chuyển đổi các yêu cầu thành những hành động có cấu trúc hoặc trích xuất dữ liệu theo định dạng định sẵn, thay vì là lựa chọn hàng đầu cho những dự án phần mềm phức tạp.
Liquid AI khuyến cáo rõ ràng không nên sử dụng mô hình này cho các tác vụ lập trình agentic hay suy luận đa bước phức tạp; thay vào đó, họ đề xuất sử dụng phương pháp truy xuất hoặc tìm kiếm cho các tác vụ đòi hỏi nhiều kiến thức. Chính hạn chế này lại giúp việc lựa chọn trở nên rõ ràng hơn: Bạn chọn nó khi workflow quan trọng hơn là lượng kiến thức thuần túy.
MiniCPM5-2B: Mô hình thực sự biết "suy nghĩ"
Hiệu suất lập trình ấn tượng – nhưng hãy lưu ý kỹ các thông tin chi tiết trước khi sử dụng
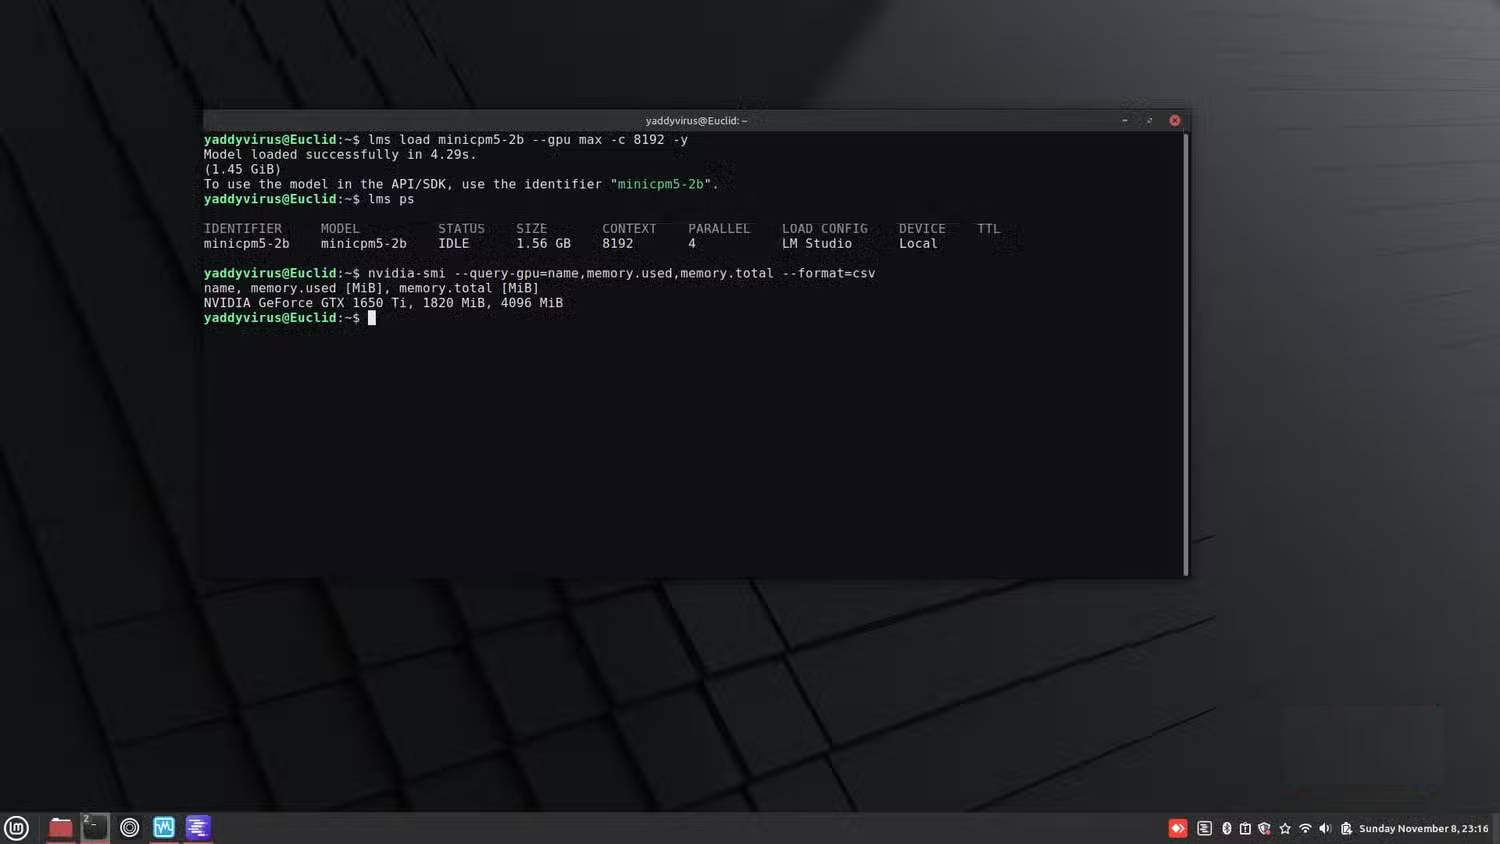
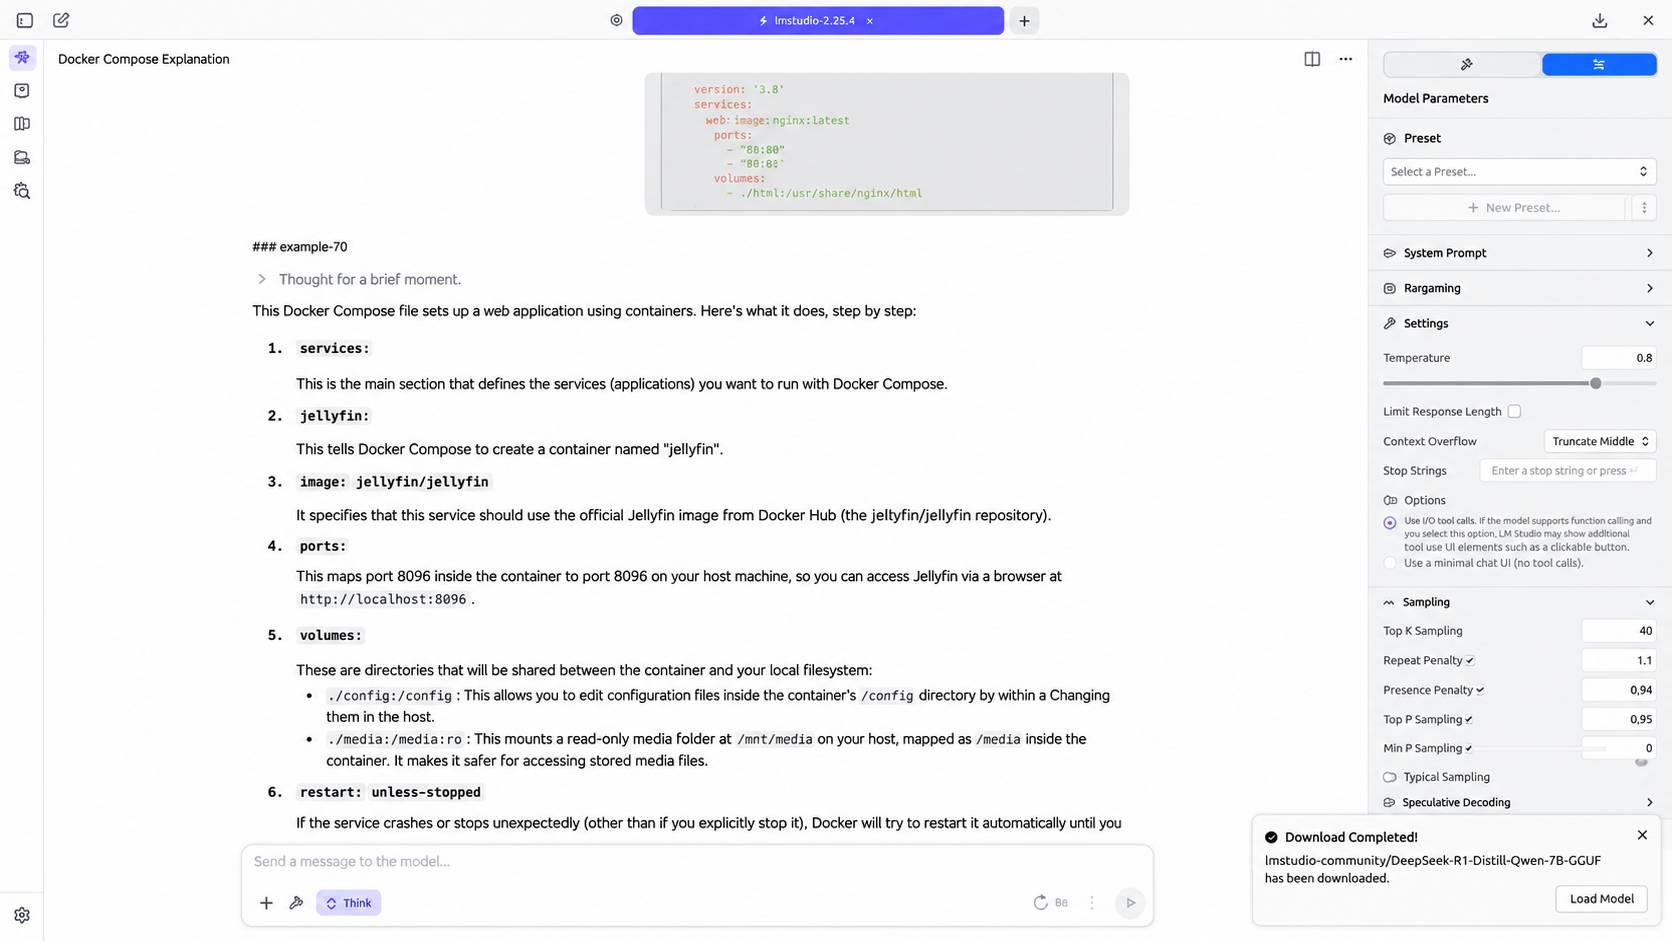
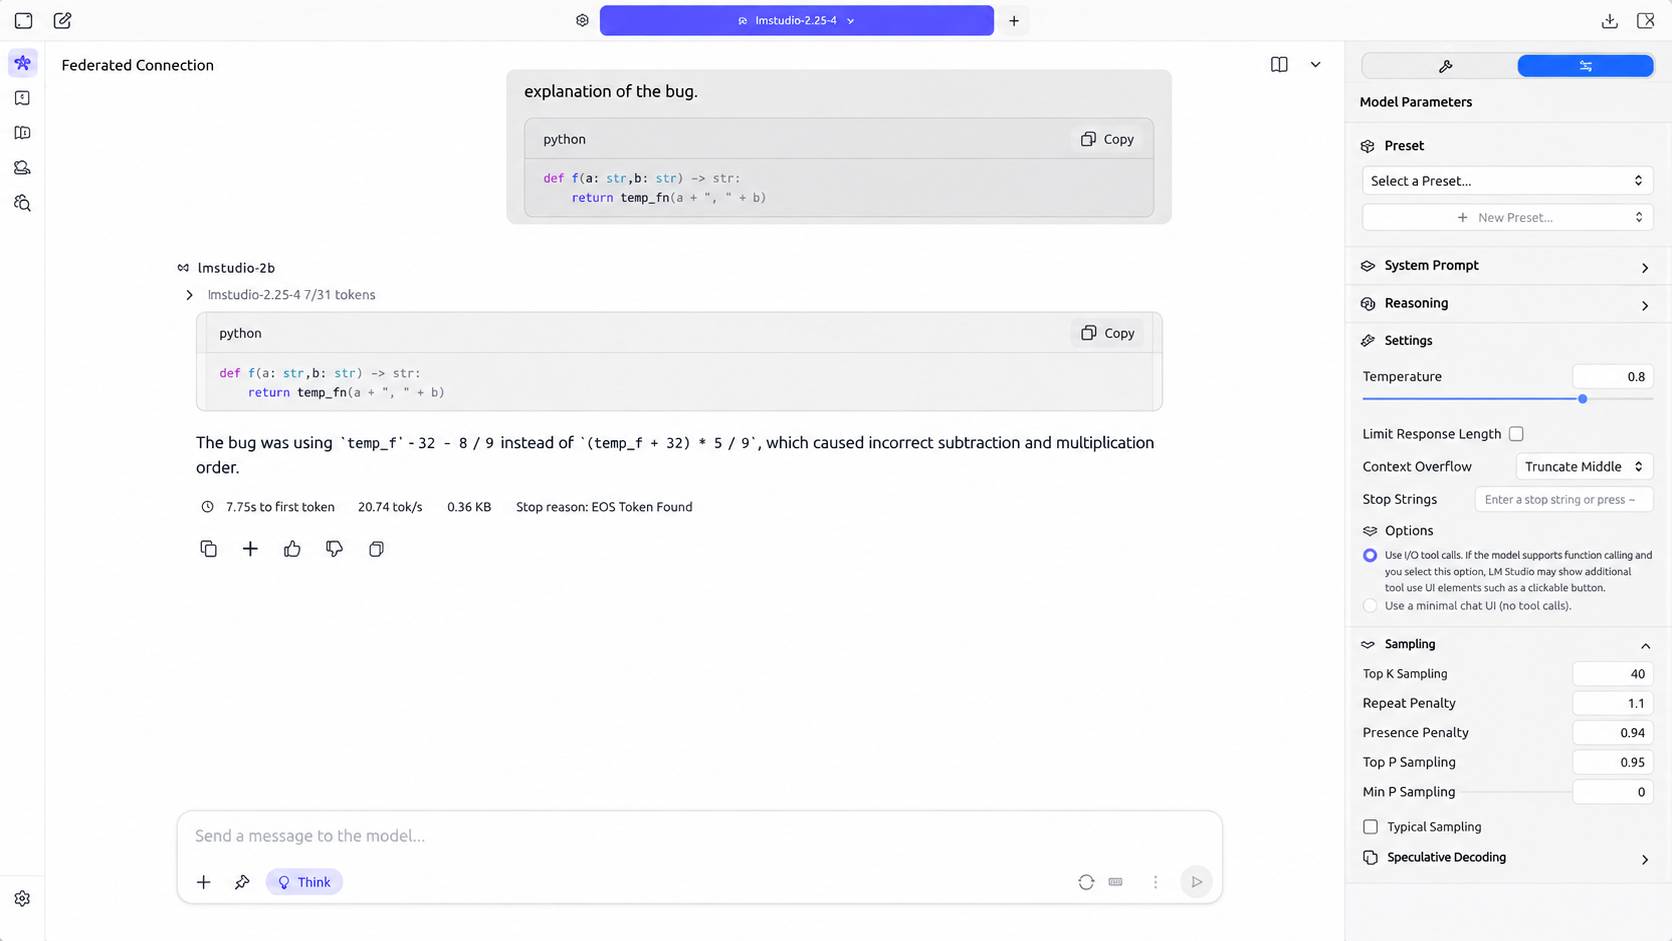
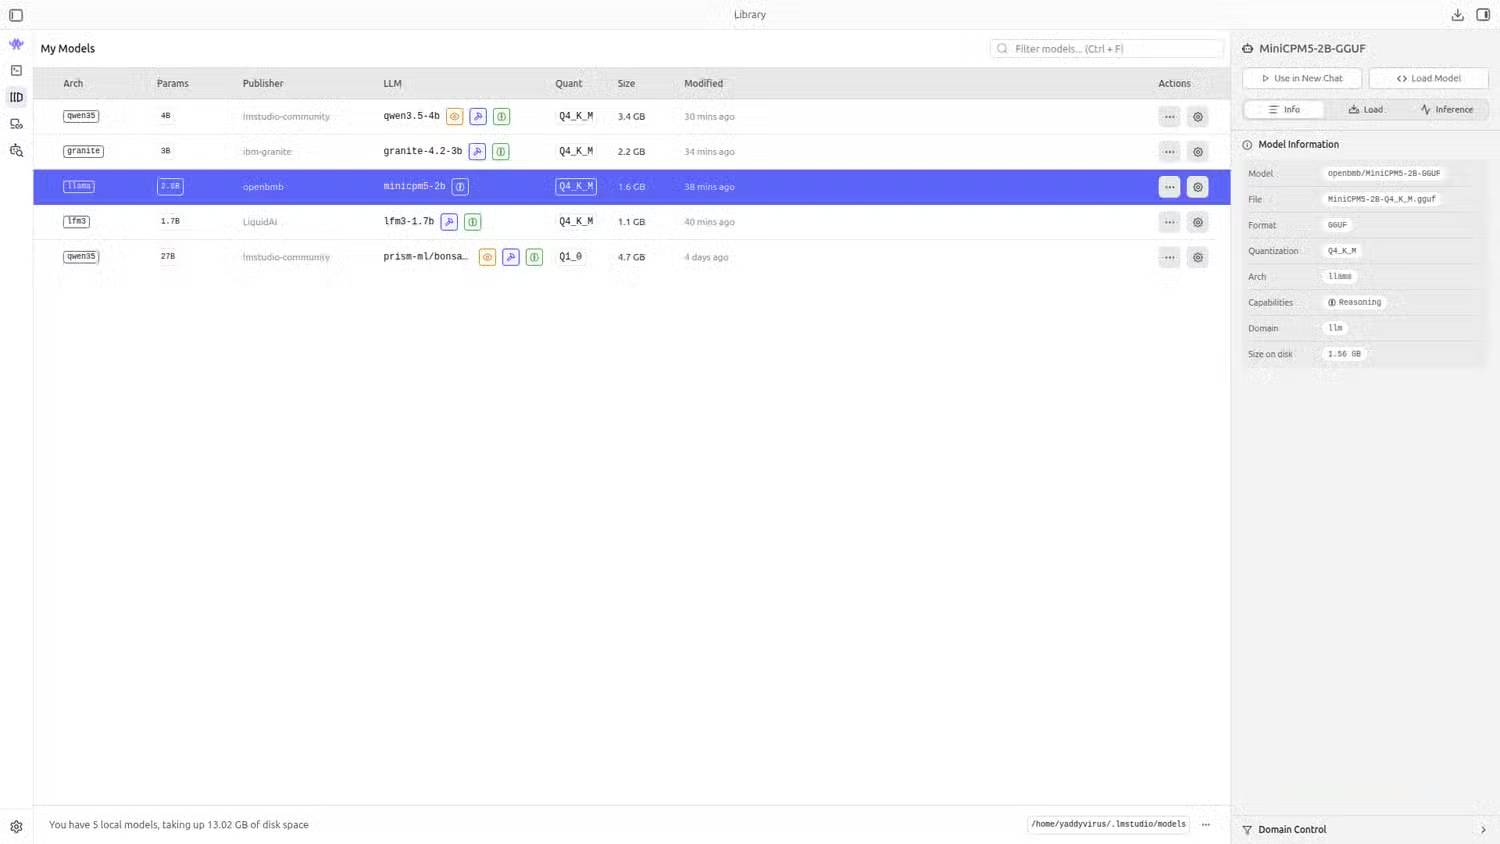
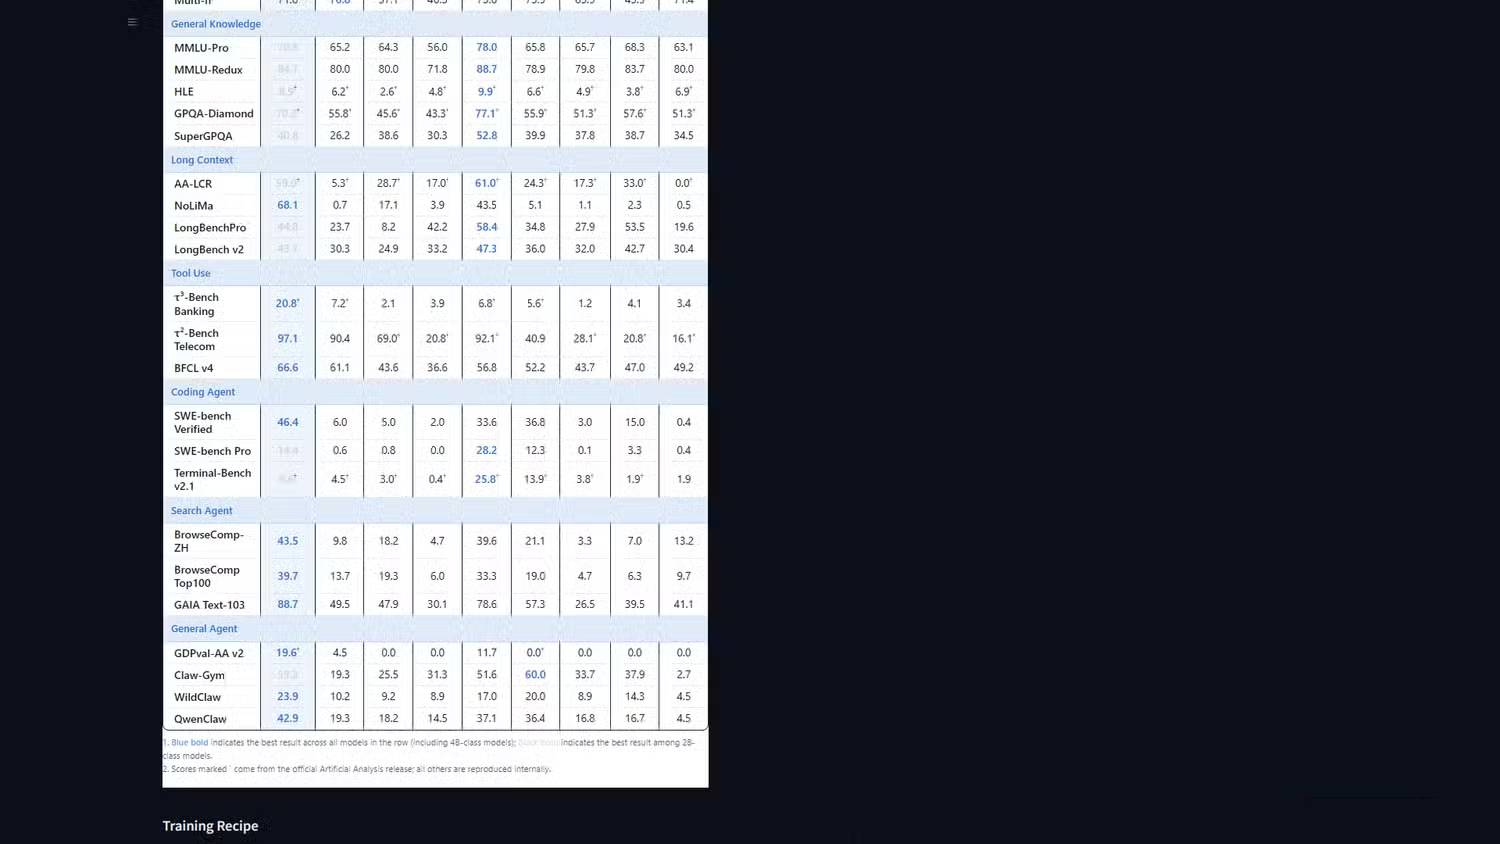
Được ra mắt vào tháng 9 năm 2026, MiniCPM5-2B của OpenBMB sở hữu khoảng 2,52 tỷ tham số, với phiên bản trọng số Q4_K_M chiếm dung lượng khoảng 1,56 GB. Mô hình này hướng tới các tác vụ như trợ lý cá nhân chạy cục bộ, agent lập trình, sử dụng công cụ và suy luận logic; đây là lựa chọn kế tiếp hợp lý nếu các mô hình nhỏ hơn tỏ ra quá hạn chế.
Theo OpenBMB, mô hình đạt 69,1 điểm trên LiveCodeBench v6 và 46,4 điểm trên SWE-bench Verified. Dù đây là những kết quả đầy hứa hẹn, chúng không đảm bảo rằng phiên bản đã được lượng tử hóa sẽ mang lại hiệu năng tương tự trên thiết bị của bạn.
Để đánh giá thực tế hơn, hãy thử giao cho mô hình các tác vụ cụ thể như sửa một hàm Python nhỏ, giải thích một file cấu hình, hoặc thực hiện một phép biến đổi dữ liệu được quy định rõ ràng. Hãy giới hạn phạm vi tác vụ và kiểm tra kỹ kết quả đầu ra. Mục tiêu ở đây là nhận được sự hỗ trợ hữu ích từ các mô hình có kích thước tương đối nhỏ, thay vì giao phó toàn bộ codebase cho mô hình xử lý mà không có sự giám sát.
Granite 4.2-3B: Tùy chỉnh mức độ "suy nghĩ" theo nhu cầu
Ba chế độ suy luận, giấy phép Apache 2.0 – không cần tốn quá nhiều tài nguyên cho những câu hỏi đơn giản
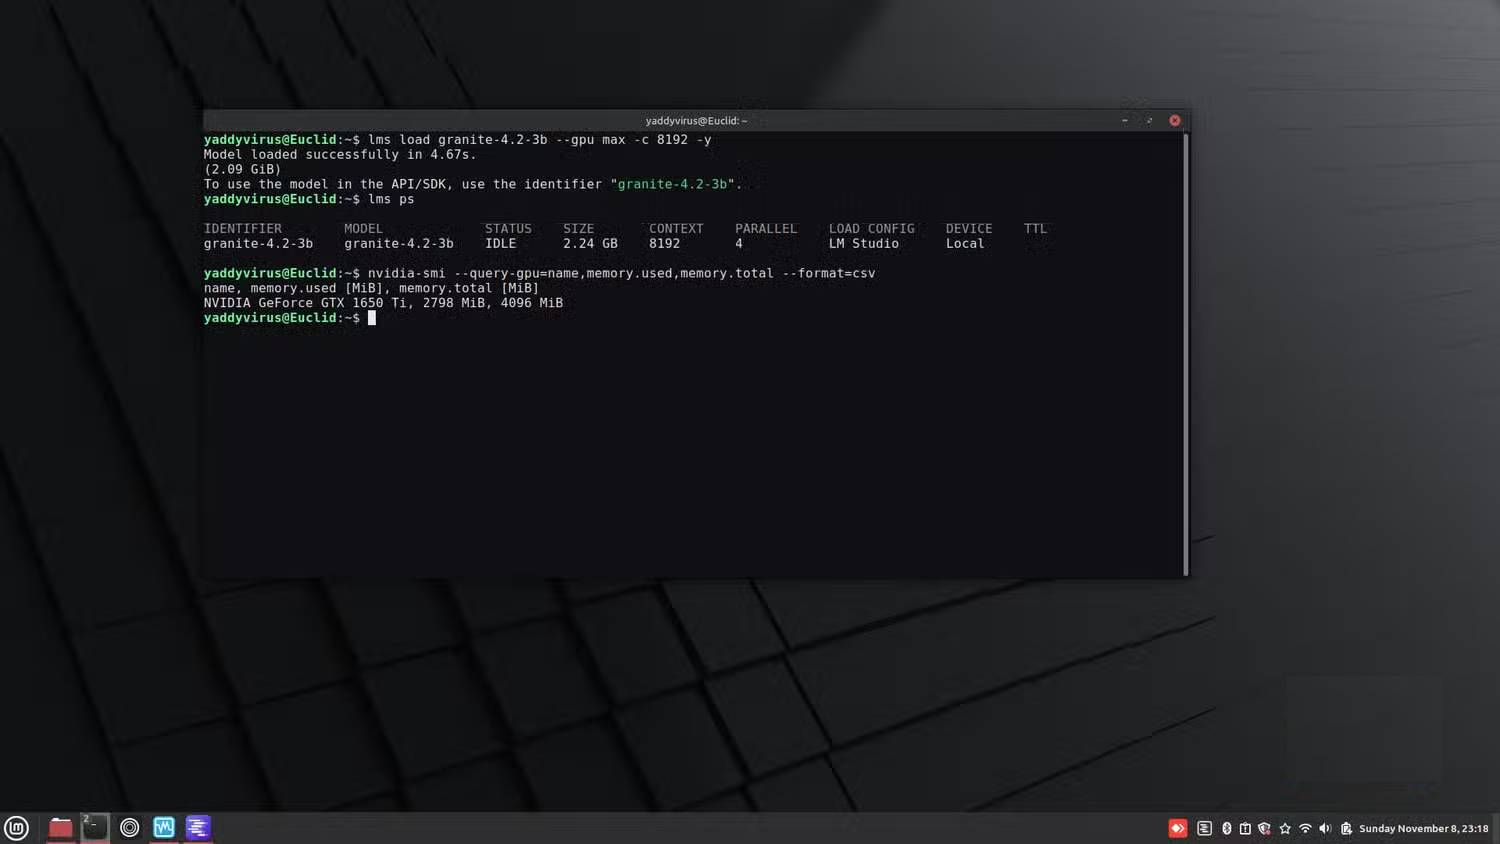
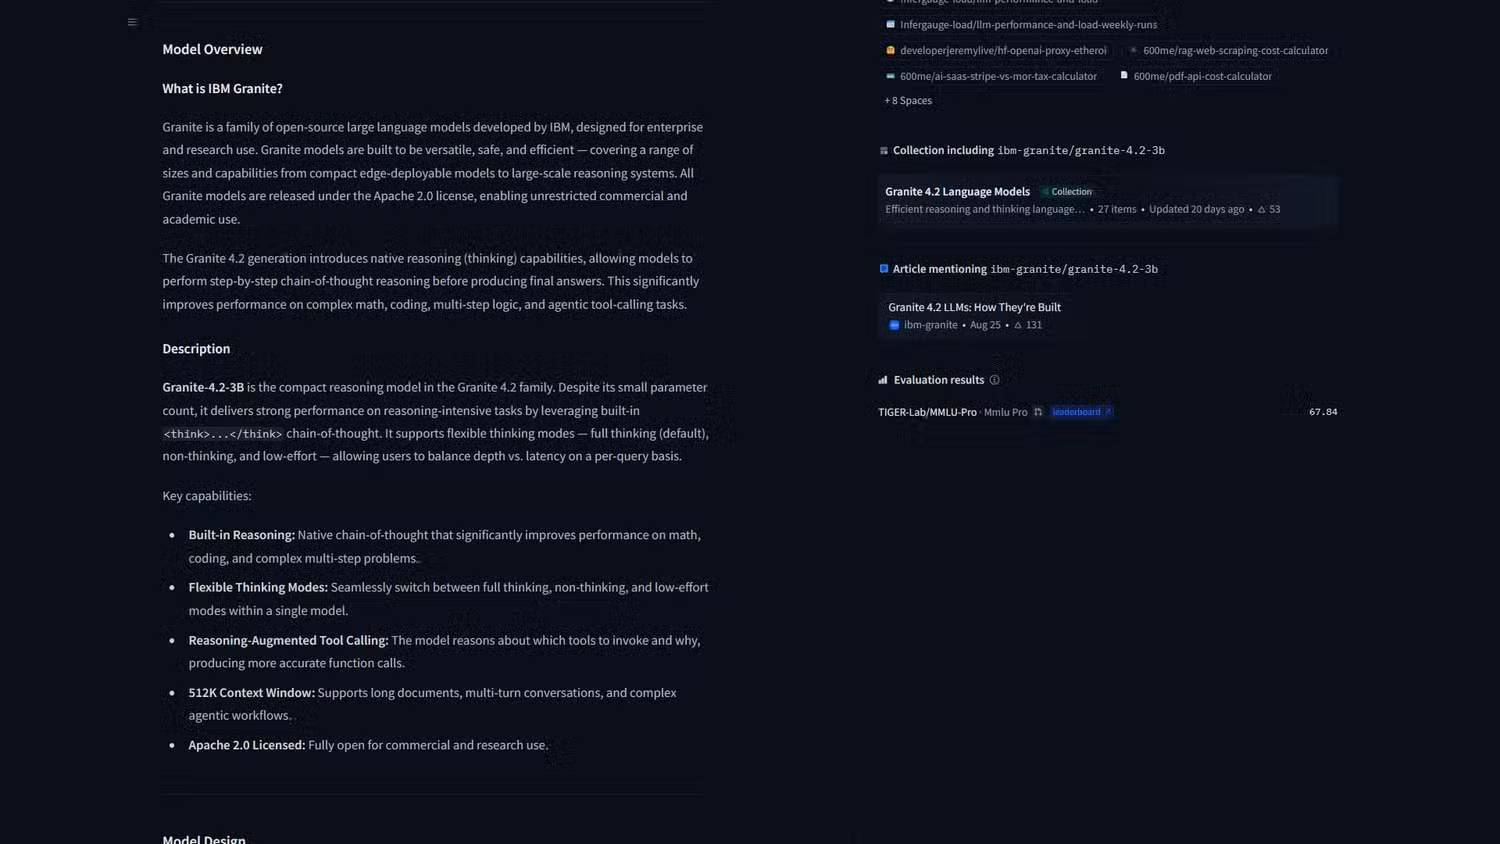
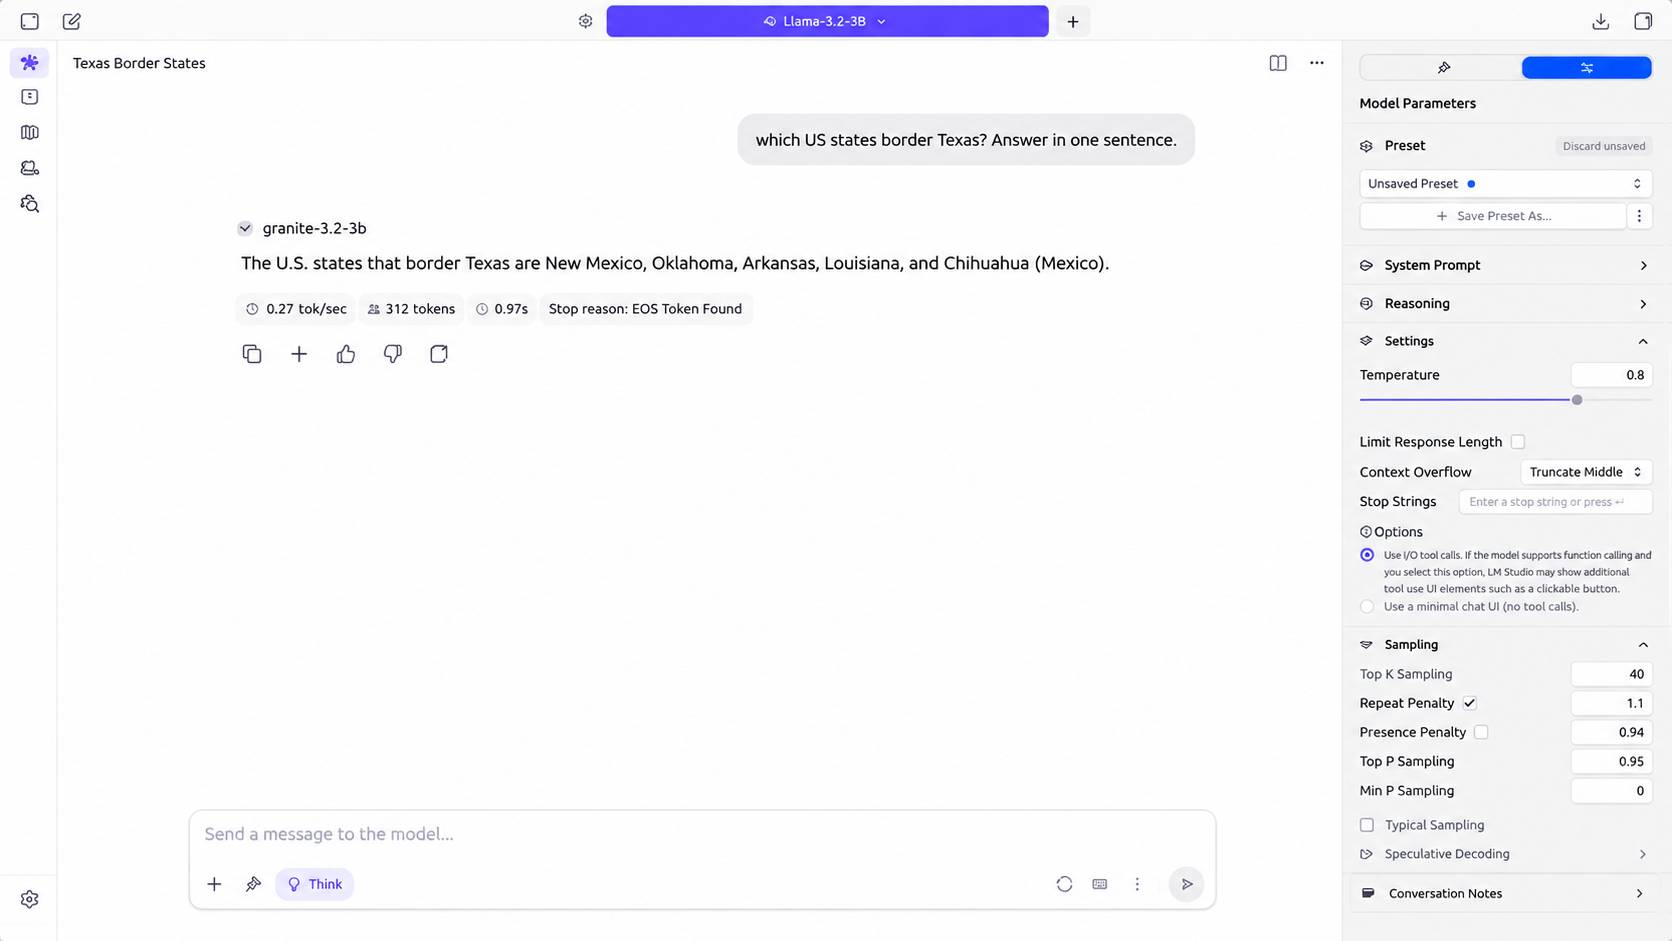
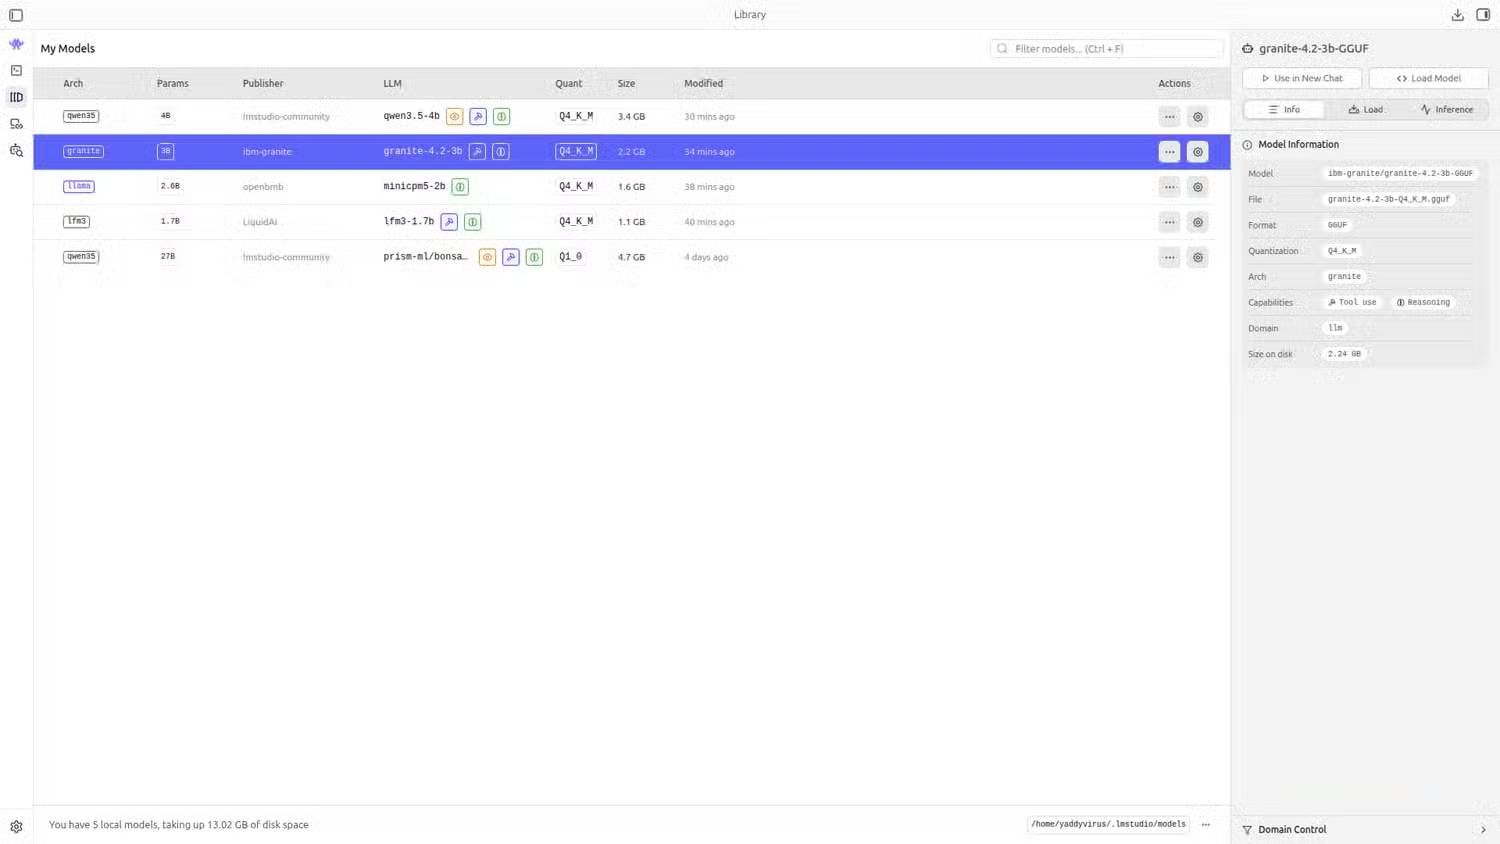
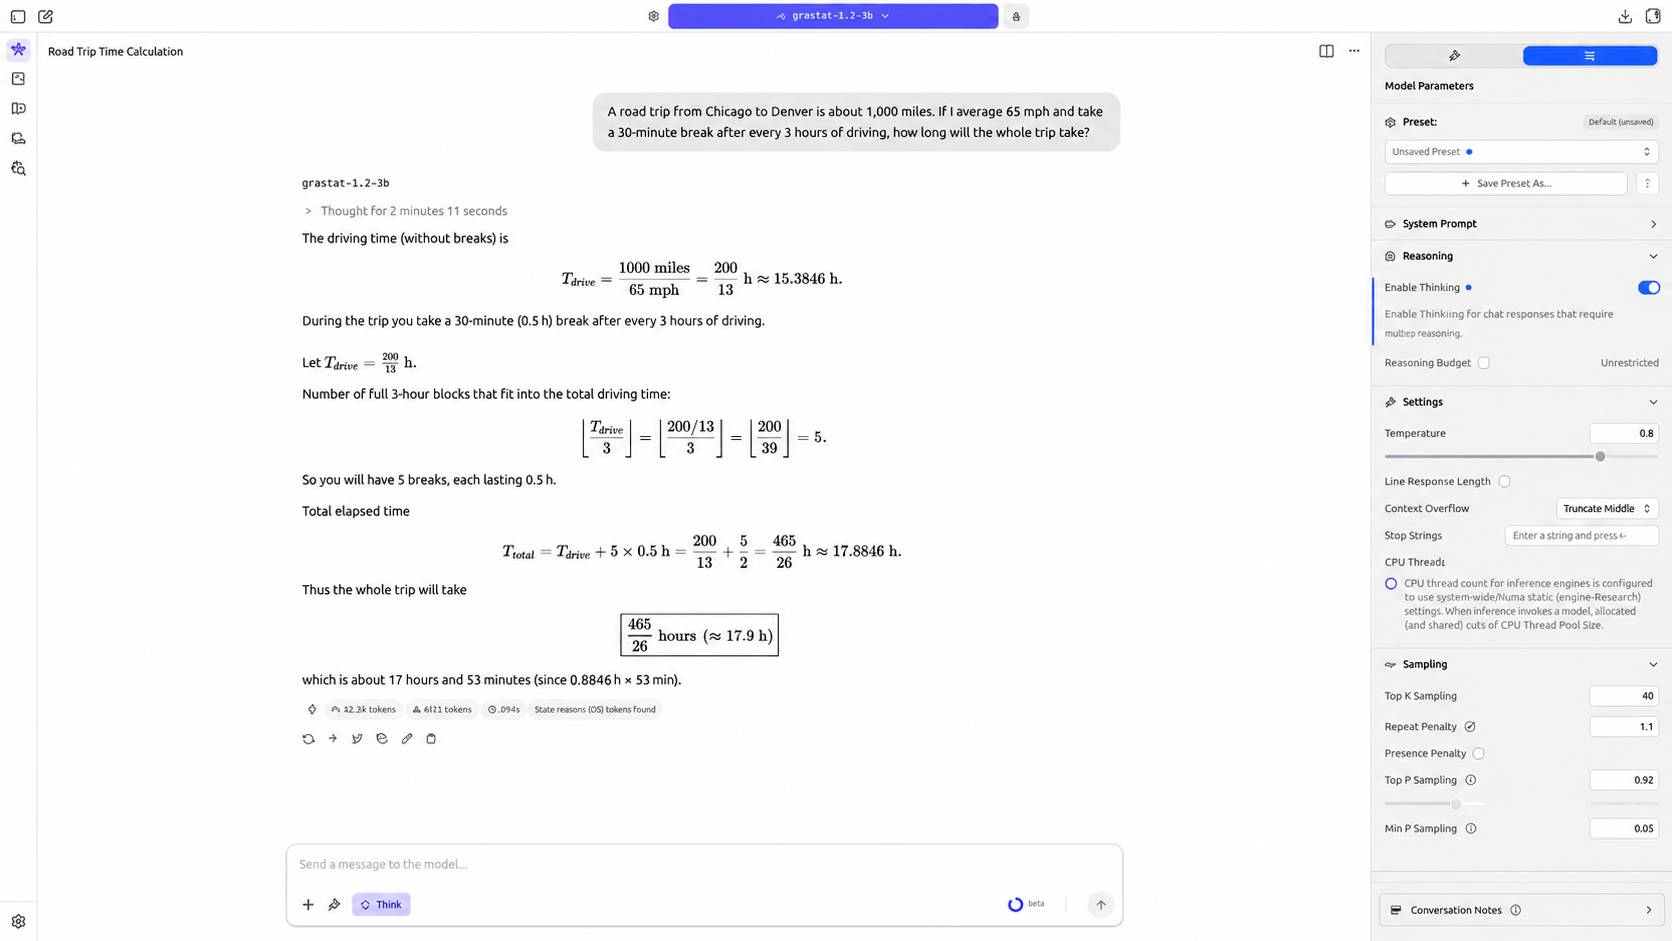
Bên cạnh các đặc điểm nêu trên, Granite 4.2-3B mang đến một tùy chọn hữu ích khác: Khả năng lựa chọn giữa các chế độ "suy nghĩ chuyên sâu" (full-thinking), "không suy nghĩ" (non-thinking) và "suy nghĩ mức độ thấp" (low-effort). Phiên bản Q4_K_M có dung lượng khoảng 2,24 GB, phù hợp với các hệ thống có giới hạn bộ nhớ mà không chiếm dụng toàn bộ tài nguyên GPU.
Sự linh hoạt này rất hữu ích vì không phải câu hỏi nào cũng đòi hỏi một quy trình suy luận phức tạp. Bạn có thể bắt đầu với các câu trả lời trực tiếp cho những yêu cầu đơn giản, sau đó kích hoạt chế độ suy luận sâu hơn khi tác vụ trở nên phức tạp hơn.
IBM phát triển mô hình này nhằm phục vụ các tác vụ suy luận, tạo code, gọi công cụ và đối thoại đa ngôn ngữ; mô hình được phát hành dưới giấy phép Apache 2.0. Đây là lựa chọn đáng cân nhắc nếu bạn muốn xây dựng một trợ lý chạy cục bộ, nơi bạn có toàn quyền kiểm soát cả quá trình triển khai lẫn cách thức phản hồi của mô hình.
Qwen3.5-4B: Mô hình bắt đầu khiến VRAM của bạn phải "kêu cứu"
Nó sở hữu khả năng xử lý hình ảnh và kiến thức sâu rộng, nhưng chế độ suy luận lại tiêu tốn lượng token cực kỳ lớn
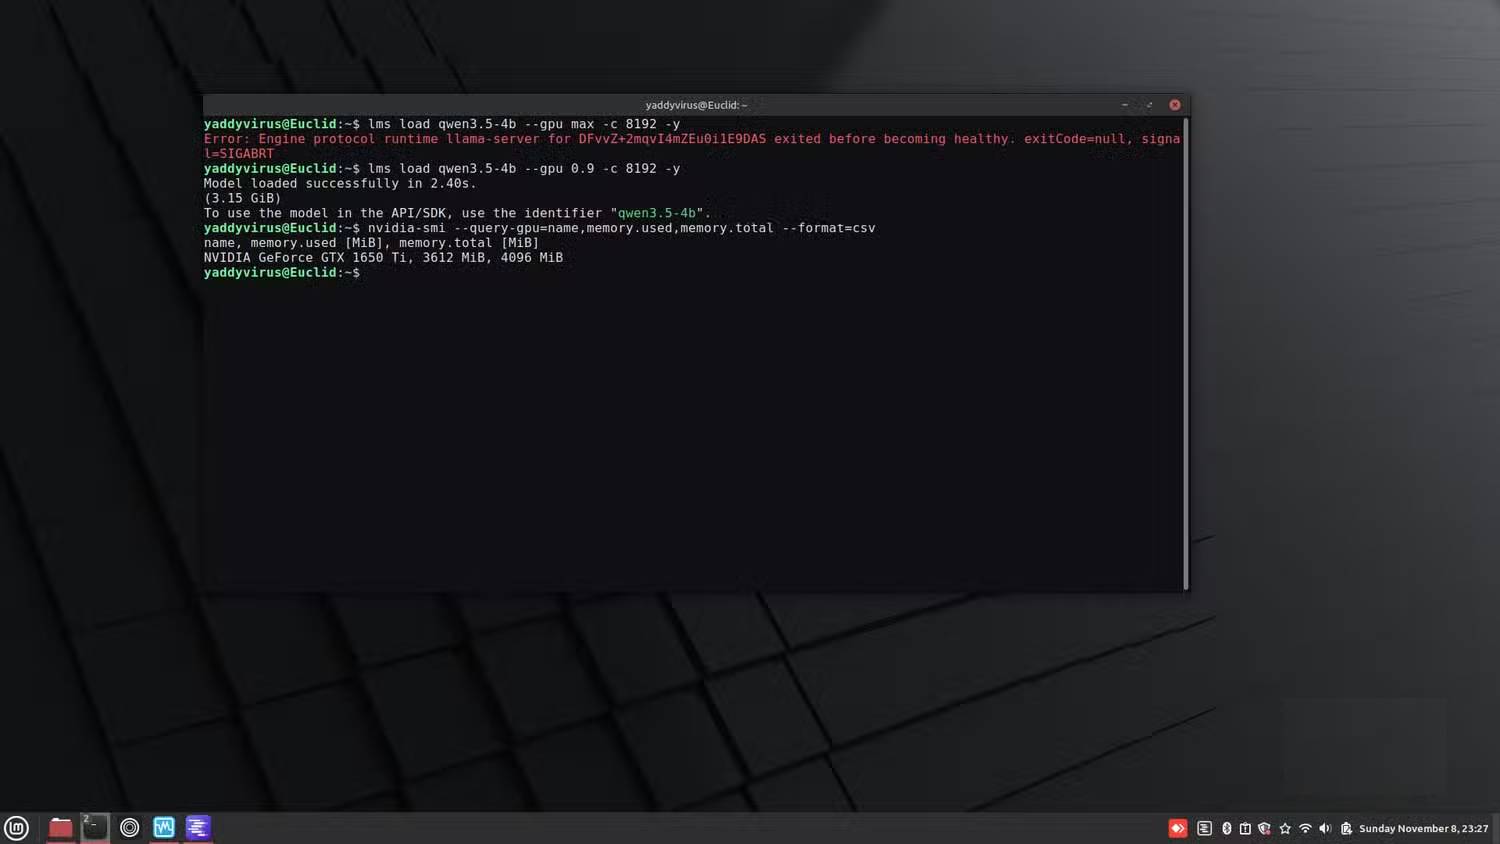
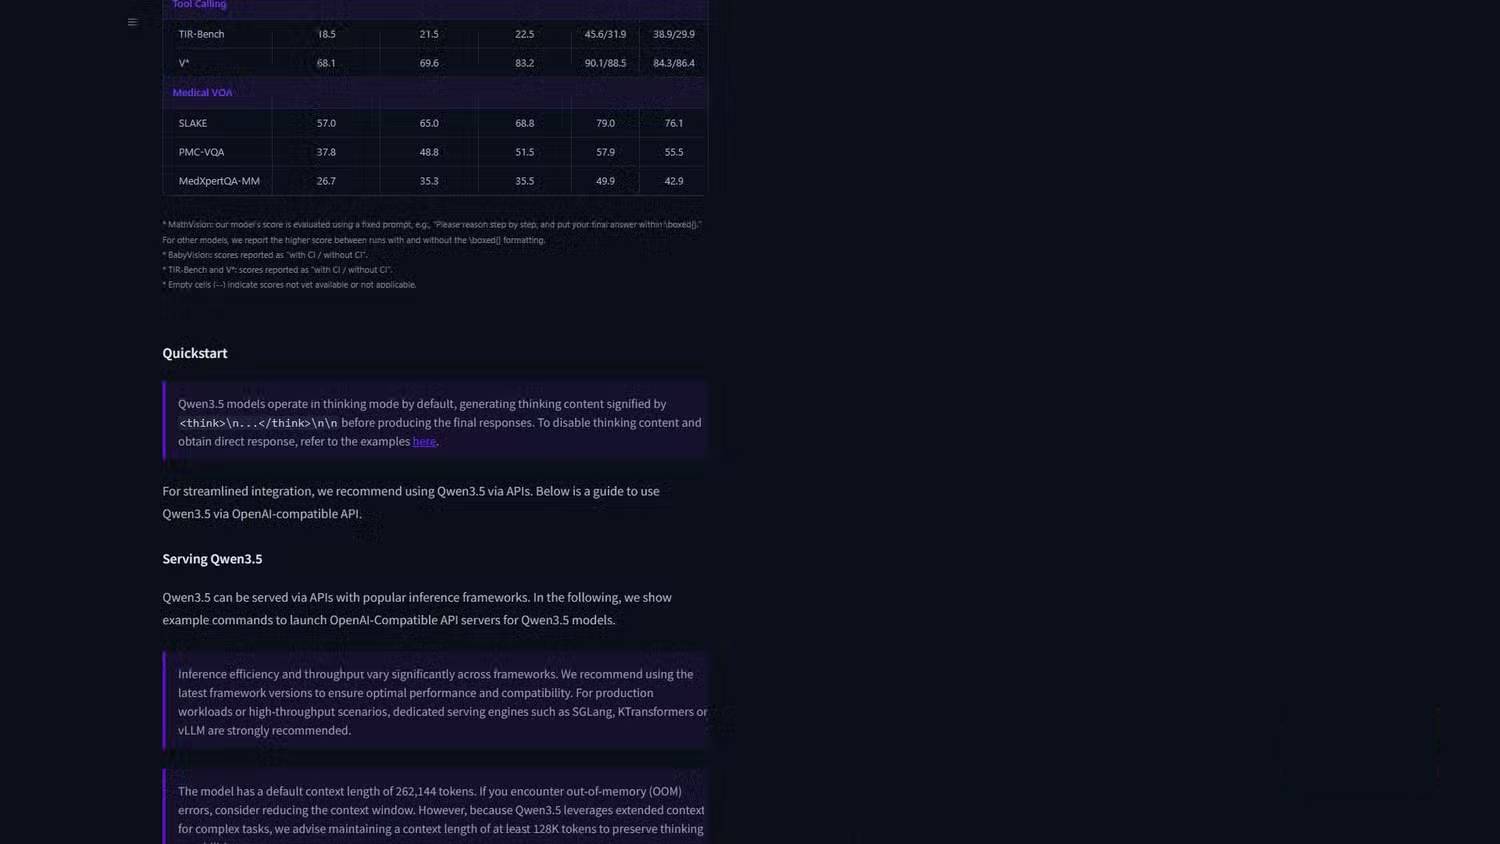
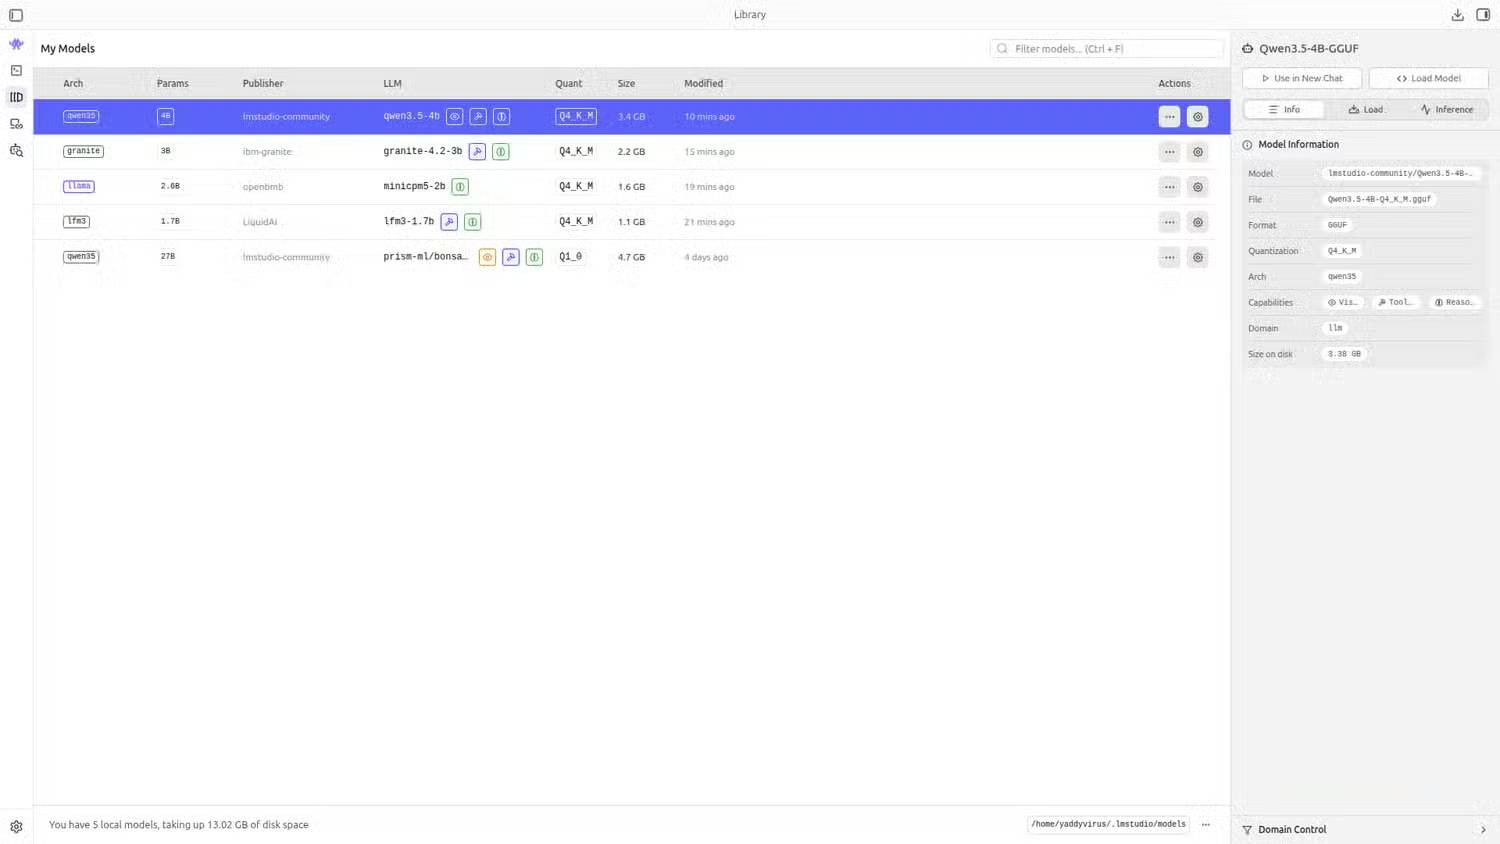
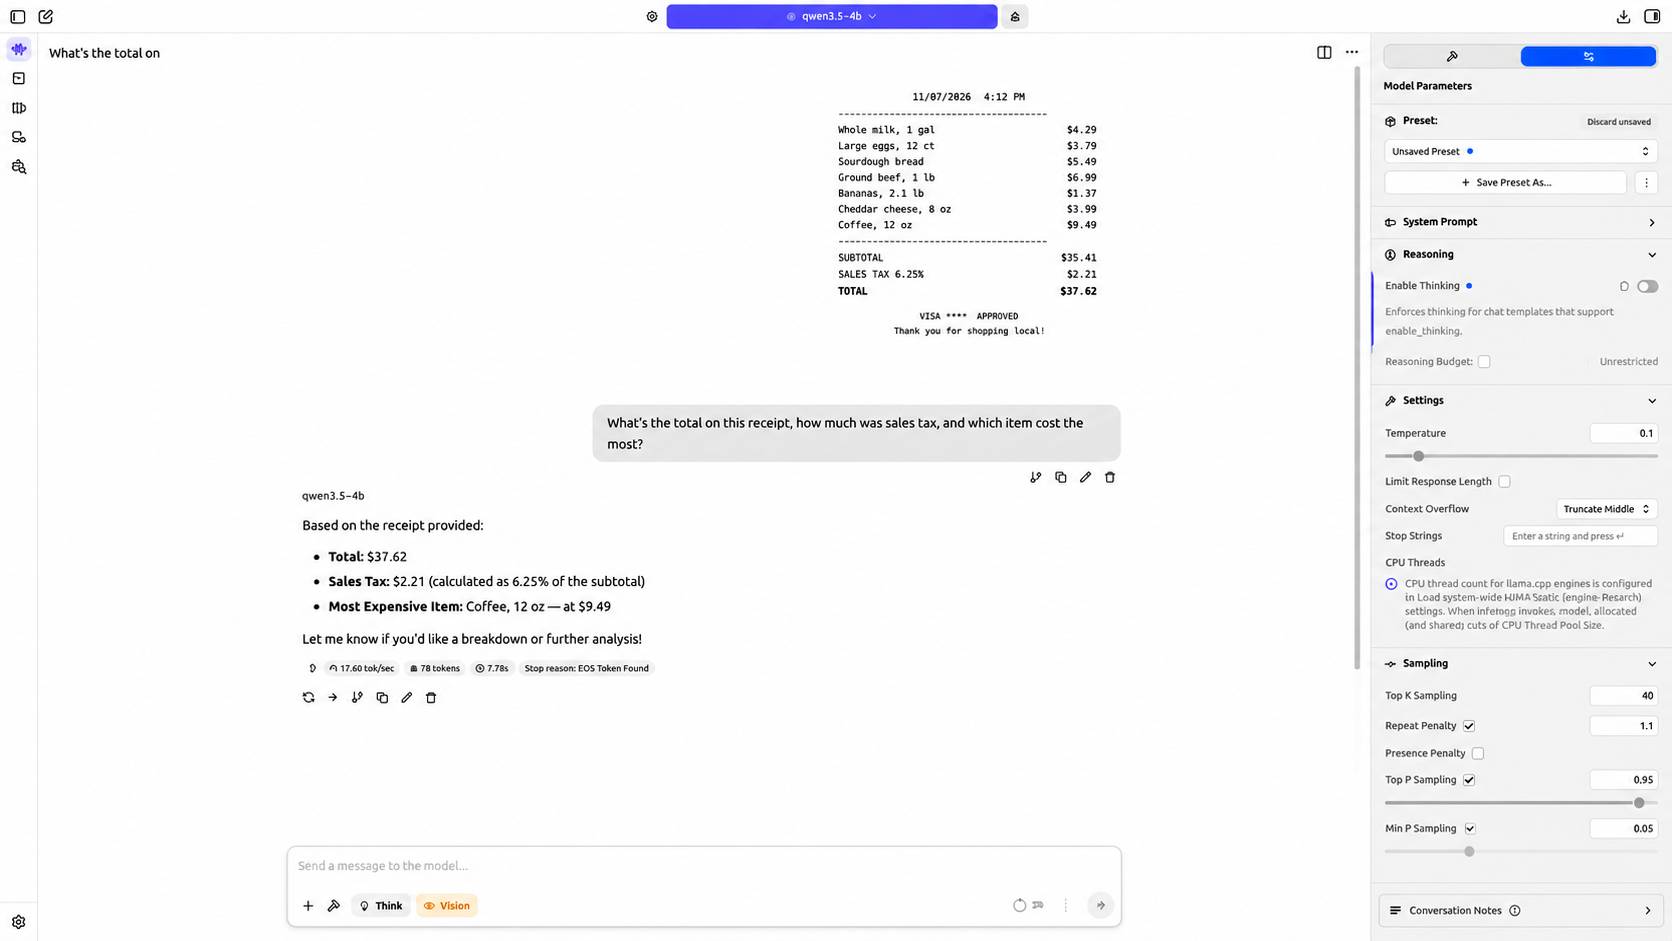
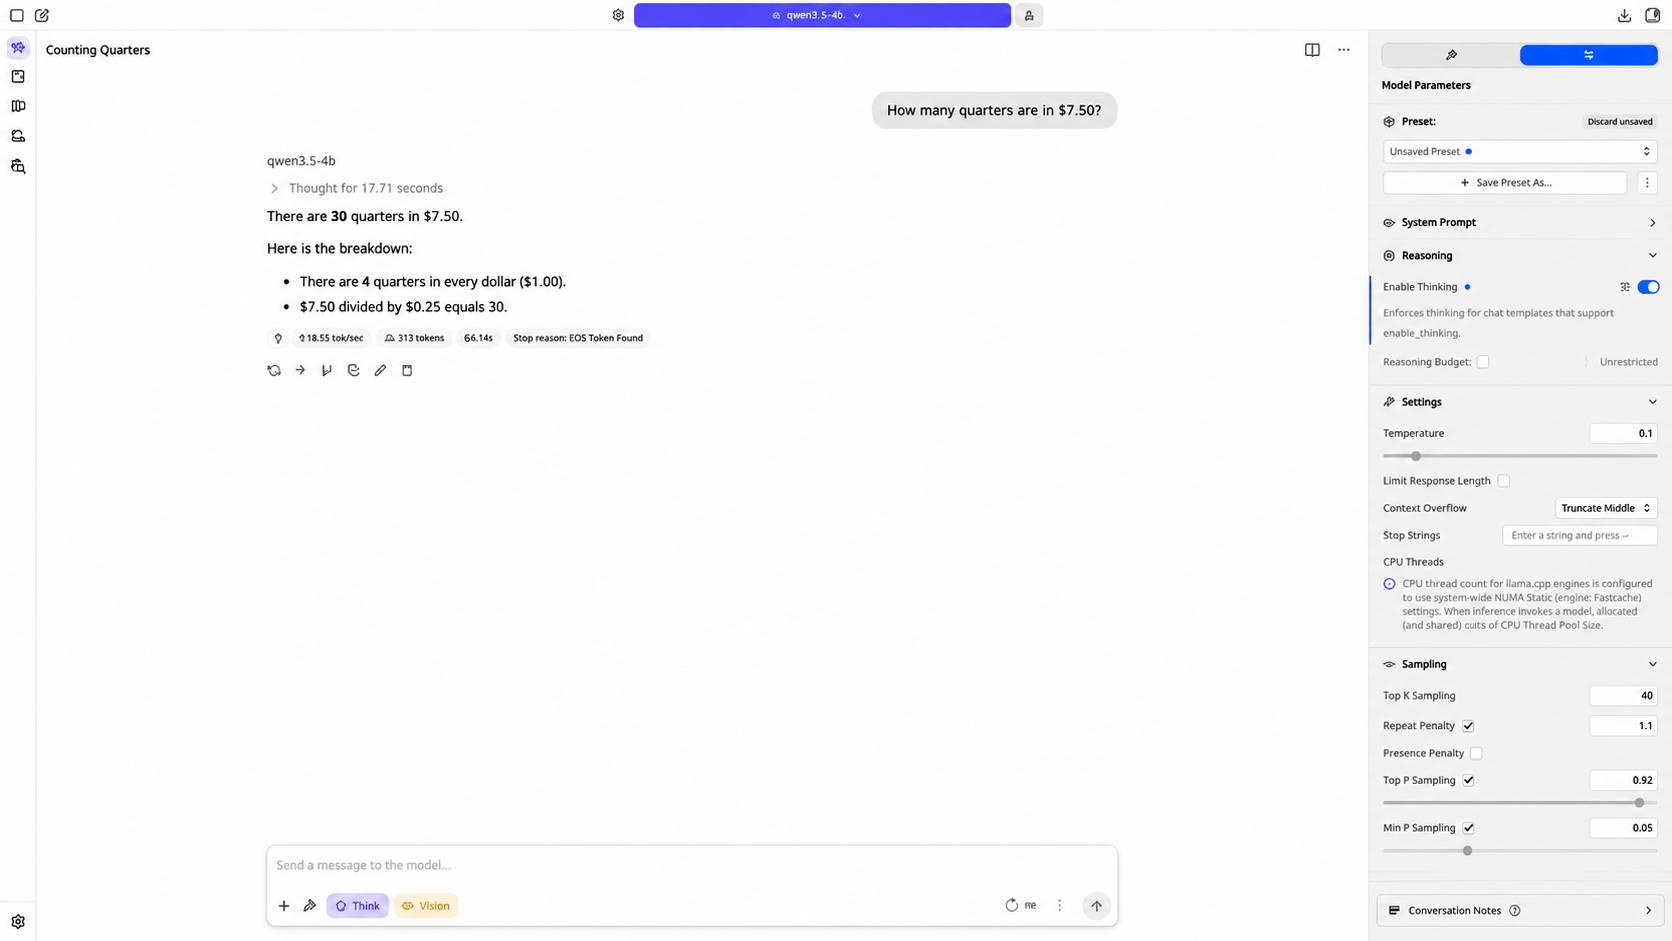
Qwen3.5-4B là một trong những mô hình nhỏ gọn đáng cân nhắc nếu bạn cần cả khả năng xử lý văn bản lẫn hình ảnh. Theo công bố, mô hình này đạt 79,1 điểm trên MMLU-Pro và 76,2 điểm trên GPQA Diamond; tuy nhiên, đừng mặc định rằng bạn sẽ đạt được hiệu suất tương đương khi chạy phiên bản 4-bit trên máy tính cá nhân.
Hãy chọn mô hình này nếu kiến thức sâu rộng hoặc khả năng xử lý hình ảnh quan trọng hơn đối với bạn so với việc tối ưu hóa dung lượng bộ nhớ. Tuy nhiên, cần lưu ý một điểm: Qwen mặc định sử dụng chế độ suy luận, và tài liệu hướng dẫn khuyến nghị nên dành hạn mức token đầu ra lớn cho các bài toán suy luận phức tạp. Nếu bạn cắt giảm ngữ cảnh để ép mô hình chạy trên phần cứng hạn chế, các điều kiện vận hành sẽ khác biệt so với môi trường thử nghiệm tạo nên những kết quả benchmark đó. Vì vậy, ngay cả khi mô hình có thể load vào bộ nhớ máy tính của bạn một cách dễ dàng, điều đó không đồng nghĩa với việc nó vẫn giữ nguyên được toàn bộ năng lực như đã quảng cáo.
Đừng quá bận tâm đến các bảng xếp hạng, hãy tự mình kiểm chứng với khối lượng công việc thực tế!
Sử dụng cùng một prompt, cùng các tiêu chí kiểm tra, và chọn mô hình nhỏ nhất vẫn đảm bảo được kết quả như mong đợi
Cách tốt nhất để đánh giá các mô hình này là biến chính khối lượng công việc của bạn thành thước đo chuẩn. Hãy bắt đầu bằng cách kiểm tra LFM3-1.7B cho các tác vụ có cấu trúc, MiniCPM5-2B cho suy luận giới hạn, Granite cho tư duy linh hoạt, hoặc Qwen khi khả năng rộng hơn đòi hỏi những yêu cầu bổ sung.
Sử dụng cùng một bộ câu hỏi thực tế cho tất cả các ứng viên. Kiểm tra tính chính xác về mặt thực tế, JSON hợp lệ, code hoạt động, thời gian phản hồi và bộ nhớ tối đa - không chỉ xem câu trả lời có vẻ trau chuốt hay không. Mô hình nhỏ nhất bạn có thể sử dụng là mô hình đáp ứng ngưỡng chất lượng một cách nhất quán, với đủ dung lượng phần cứng còn lại để tiếp tục sử dụng máy tính của bạn.



 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

