 AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích
Top 10 mô hình AI audio mã nguồn mở

Mua gói Thành viên QuanTriMang Pro để trải nghiệm website không quảng cáo và sử dụng các tiện ích AI trên QuanTriMang.
Các mô hình audio mã nguồn mở hiện đã bao phủ những lĩnh vực như nhận dạng giọng nói, chuyển đổi văn bản thành giọng nói, hội thoại bằng giọng nói theo thời gian thực và tạo nhạc; trong đó, nhiều mô hình có thể chạy trên một GPU phổ thông. Chẳng hạn, Qwen3-ASR có khả năng chuyển đổi giọng nói thành văn bản cho 30 ngôn ngữ và 22 phương ngữ tiếng Trung; Kokoro tạo giọng nói chỉ với 82 triệu tham số; còn ACE-Step có thể sáng tác trọn vẹn một bài hát với dung lượng bộ nhớ video (VRAM) dưới 4 GB.
Hướng dẫn này đã chọn ra 10 mô hình AI audio mã nguồn mở (hoặc có trọng số mở) tốt nhất dựa trên sự kết hợp của 3 tiêu chí: Số lượt sao trên GitHub, số lượt tải xuống trên Hugging Face và hiệu suất hàng đầu theo các bài kiểm tra benchmark Artificial Analysis. Các mô hình này được chia thành 4 nhóm: Nhận dạng giọng nói, chuyển đổi văn bản thành giọng nói, hội thoại theo thời gian thực và tạo nhạc.
Một lưu ý nhỏ: Đây là danh sách được chọn lọc, không phải bảng xếp hạng dựa trên các tiêu chuẩn đánh giá khắt khe. "Trọng số mở" (open-weight) có nghĩa là bạn có thể tải xuống các trọng số đã qua huấn luyện, nhưng giấy phép sử dụng vẫn có thể đặt ra những hạn chế nhất định. Do đó, bài viết đã ghi chú rõ về giấy phép trong từng phần. Các ví dụ được lấy từ tài liệu chính thức; tuy nhiên, code chưa được trực tiếp kiểm thử, nên quá trình thiết lập của bạn có thể cần thêm các dependency hoặc cấu hình bổ sung.
Mục lục bài viết
Các mô hình nhận dạng giọng nói mã nguồn mở tốt nhất
Các mô hình nhận dạng giọng nói, hay còn gọi là mô hình nhận dạng giọng nói tự động (ASR), có chức năng chuyển đổi âm thanh lời nói thành văn bản. Chúng rất hữu ích trong các tác vụ như ghi chép lại nội dung cuộc họp, tạo phụ đề, xử lý podcast, hỗ trợ những trợ lý ảo và phân tích dữ liệu âm thanh. Các mô hình hiện đại còn có khả năng nhận diện nhiều ngôn ngữ, xử lý các cuộc hội thoại trực tiếp, thậm chí là suy luận về nội dung đang được thảo luận.
1. Voxtral Small
Voxtral Small 24B là một mô hình hiểu giọng nói với trọng số mở từ Mistral AI, được phát hành theo giấy phép Apache 2.0. Mô hình này hỗ trợ 8 ngôn ngữ (tiếng Anh, Tây Ban Nha, Pháp, Bồ Đào Nha, Hindi, Đức, Hà Lan và Ý), có khả năng chuyển đổi âm thanh thành văn bản, tóm tắt hội thoại, trả lời các câu hỏi liên quan đến nội dung âm thanh và thực hiện theo những chỉ dẫn bằng lời nói.
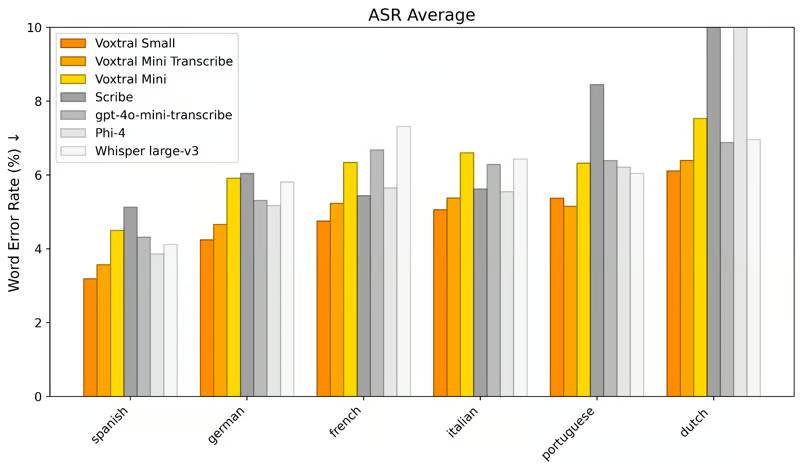
Ưu điểm lớn nhất của mô hình này là khả năng tích hợp cả nhận dạng giọng nói và suy luận ngôn ngữ trong cùng một hệ thống; nhờ đó, bạn không cần phải thiết lập các quy trình riêng biệt cho việc chuyển đổi văn bản và tóm tắt nội dung. Điều này đặc biệt phù hợp cho các tác vụ như phân tích cuộc họp, phỏng vấn và vận hành trợ lý ảo. Tuy nhiên, điểm hạn chế nằm ở kích thước: Với 24 tỷ tham số, mô hình yêu cầu khoảng 55 GB bộ nhớ GPU (ở định dạng BF16 hoặc FP16), đòi hỏi phần cứng có dung lượng bộ nhớ lớn hoặc hệ thống đa GPU.
Nếu bạn chỉ cần chức năng chuyển đổi giọng nói thành văn bản, phiên bản Voxtral Mini 4B Realtime mới hơn từ Mistral sẽ là lựa chọn gọn nhẹ hơn. Được Mistral phát hành vào tháng 2 năm 2026 theo giấy phép Apache 2.0, mô hình này cho phép tùy chỉnh độ trễ khi xử lý trực tiếp (streaming latency) xuống dưới mức 200 ms.
2. Qwen3-ASR
Qwen3-ASR là một dòng mô hình nhận dạng giọng nói mã nguồn mở từ nhóm Qwen của Alibaba, hiện có sẵn các phiên bản với 0,6 tỷ (0.6B) và 1,7 tỷ (1.7B) tham số, được phát hành theo giấy phép Apache 2.0. Hệ thống hỗ trợ 30 ngôn ngữ và 22 phương ngữ tiếng Trung, có khả năng tự động phát hiện ngôn ngữ nói, đồng thời có thể chuyển đổi giọng nói thành văn bản ngay cả khi có nhạc nền (bao gồm cả giọng hát). Công cụ này rất hiệu quả cho các tác vụ như phiên âm đa ngôn ngữ, tạo phụ đề, xử lý podcast và các bài phỏng vấn.
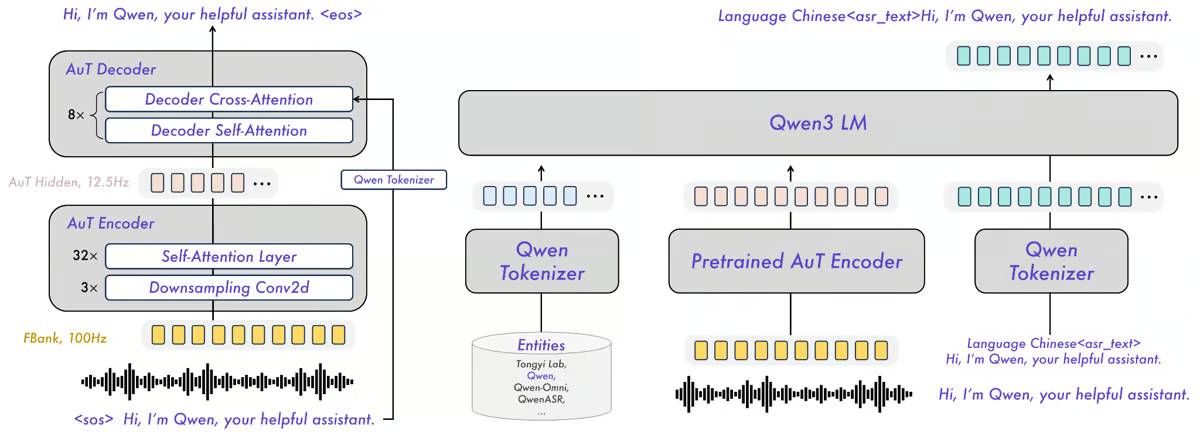
Qwen3-ASR đạt được sự cân bằng giữa độ chính xác, tốc độ và tính linh hoạt. Phiên bản 1.7B đạt tỷ lệ lỗi từ trung bình (WER) là 5,76 trên bảng xếp hạng Open ASR của Hugging Face (so với 6,62 của Voxtral Small; chỉ số càng thấp càng tốt). Phiên bản 0,6B ưu tiên hiệu suất hơn là độ chính xác tuyệt đối.
Cả hai phiên bản đều hỗ trợ suy luận ở chế độ ngoại tuyến (offline) và trực tuyến (streaming); tuy nhiên, chế độ trực tuyến hiện yêu cầu sử dụng backend vLLM (cài đặt qua lệnh: pip install -U qwen-asr[vllm]). Ngoài ra, mô hình Qwen3-ForcedAligner-0,6B (tùy chọn) có thể tạo timestamp theo từng từ, phục vụ cho việc làm phụ đề bằng 11 ngôn ngữ được hỗ trợ.
3. NVIDIA Nemotron 3.5 ASR Streaming
NVIDIA Nemotron 3.5 ASR Streaming 0.6B là mô hình nhận dạng giọng nói gọn nhẹ, được thiết kế để chuyển đổi giọng nói thành văn bản theo thời gian thực. Mô hình này sở hữu 600 triệu tham số và hỗ trợ 40 ngôn ngữ/biến thể ngôn ngữ khác nhau, bao gồm tiếng Anh, tiếng Ả Rập, tiếng Hindi, tiếng Tây Ban Nha và tiếng Nhật. Trong đó, 32 ngôn ngữ có thể sử dụng ngay lập tức, còn 8 ngôn ngữ khác cần được tinh chỉnh trước khi đưa vào vận hành.
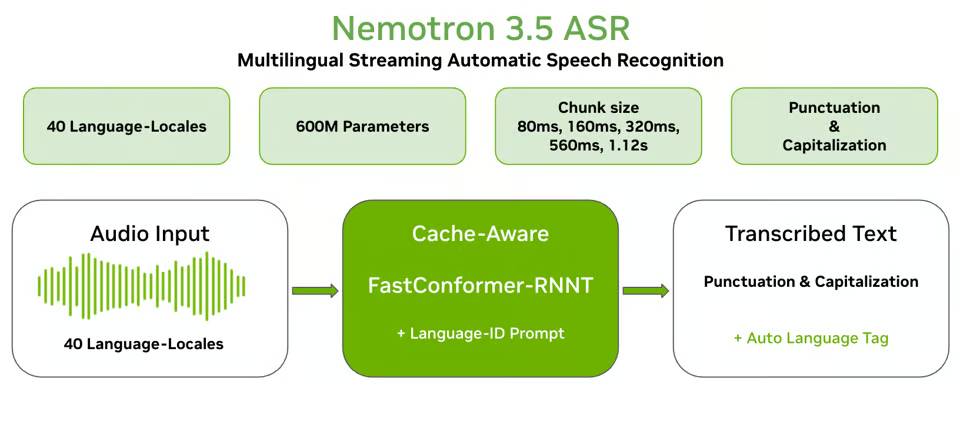
Tốc độ vượt trội của mô hình này đến từ kiến trúc xử lý stream tối ưu hóa cache. Thay vì phải xử lý lại toàn bộ bản ghi âm, hệ thống chỉ xử lý các đoạn âm thanh mới trong khi vẫn tận dụng lại ngữ cảnh từ encoder đã lưu trong cache; kích thước mỗi đoạn âm thanh có thể nhỏ tới 80 mili giây. Theo báo cáo từ NVIDIA, trên một GPU H100 duy nhất, mô hình này có khả năng xử lý số lượng luồng đồng thời cao gấp khoảng 17 lần so với mô hình Parakeet RNNT 1.1B (sử dụng buffer) ở cùng thiết lập 80 mili giây (240 stream so với 14 stream).
Nhờ đó, đây là lựa chọn tối ưu cho các ứng dụng như tạo phụ đề trực tiếp, ghi chép cuộc họp và những trợ lý giọng nói có độ trễ thấp. Các trọng số của mô hình được phát hành theo giấy phép OpenMDW-1.1 – loại giấy phép mà NVIDIA xác nhận là cho phép sử dụng cho mục đích thương mại. Mô hình có thể chạy cục bộ thông qua runtime NeMo-Speech.cpp của NVIDIA.
Các mô hình chuyển văn bản thành giọng nói (TTS) mã nguồn mở tốt nhất
Các mô hình chuyển văn bản thành giọng nói (TTS) giúp biến văn bản viết thành âm thanh nghe tự nhiên. Những mô hình hiện đại có khả năng sao chép giọng nói, thể hiện cảm xúc, tạo các đoạn hội thoại với nhiều nhân vật và hỗ trợ nhiều ngôn ngữ khác nhau. Dưới đây là 3 mô hình mã nguồn mở đáng để khám phá.
4. Fish Audio Drama 3
Fish Audio Drama 3 là một mô hình TTS giàu biểu cảm, được thiết kế cho các phân cảnh có nhiều nhân vật và nội dung dài. Mô hình này sử dụng kiến trúc Mixture-of-experts với 35 tỷ tham số, nhưng chỉ kích hoạt khoảng 3 tỷ tham số cho mỗi token. Nó hỗ trợ sao chép giọng nói, điều khiển bằng ngôn ngữ tự nhiên và các đoạn hội thoại với tối đa 16 nhân vật, rất phù hợp cho audiobook và những nội dung tập trung vào nhân vật.
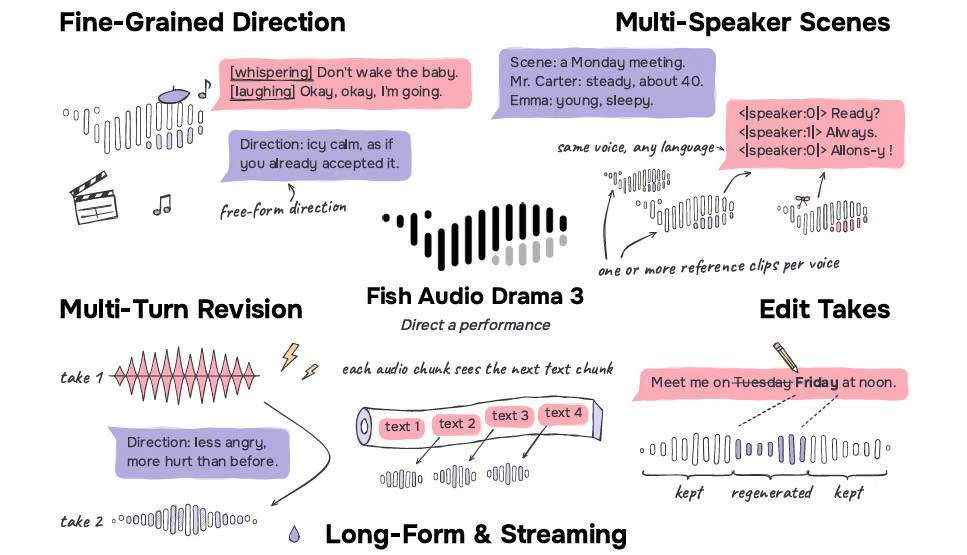
Điểm nổi bật nhất chính là khả năng thể hiện cảm xúc đa dạng. Bạn có thể chèn trực tiếp các tag cảm xúc như [sighs] hay [laughs] vào văn bản, chỉ định tối đa 16 tag nhân vật trong cùng một kịch bản, đồng thời truyền tải các đoạn nội dung dài theo từng phần nhỏ. Theo Fish Audio, thời gian để tạo ra âm thanh đầu tiên là khoảng 89 ms trên GPU H200; mô hình này vận hành thông qua SGLang-Omni và vLLM-Omni.
Tuy nhiên, cần lưu ý về kích thước mô hình và vấn đề bản quyền. Phiên bản checkpoint FP8 yêu cầu 37 GB dung lượng chỉ riêng cho các trọng số, trong khi phiên bản GPTQ 4-bit giảm con số này xuống còn 20,8 GB. Các trọng số này được phát hành theo giấy phép Fish Audio Community License, vì vậy hãy đọc kỹ các điều khoản trước khi sử dụng cho mục đích thương mại.
5. Breeze TTS 2
Breeze TTS 2 là mô hình chuyển văn bản thành giọng nói với 3 tỷ tham số, hỗ trợ cả tiếng Anh và tiếng Trung. Mô hình này cho phép sao chép giọng nói từ bản ghi âm tham chiếu, thiết kế giọng nói dựa trên mô tả bằng ngôn ngữ tự nhiên, cũng như sử dụng các chỉ dẫn bằng ngôn ngữ tự nhiên để điều chỉnh tông giọng, cảm xúc và cách truyền đạt.
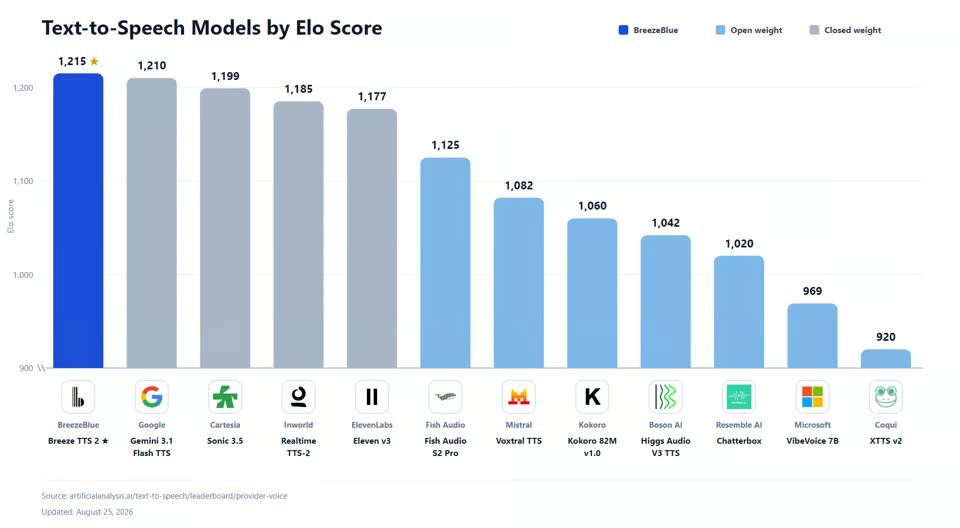
Theo thông tin từ BreezeBlue, mô hình này hiện đứng đầu trong nhóm các mô hình trọng số mở trên bảng xếp hạng TTS của Artificial Analysis. Trên GPU H100, với cơ chế tối ưu hóa tốc độ (fast path), mô hình chỉ mất dưới 40 mili giây để bắt đầu phát âm thanh. Ngoài ra, nó còn hỗ trợ chèn trực tiếp các biểu cảm giọng nói như (laugh), (sigh) và (cough).
Nhờ đó, Breeze TTS 2 rất phù hợp cho các ứng dụng giọng nói tương tác. Tuy nhiên, cần lưu ý rằng các trọng số và kết quả đầu ra của mô hình chỉ được phép sử dụng cho mục đích nghiên cứu và phi thương mại. Chỉ riêng mã nguồn (source code) là được phát hành theo giấy phép Apache 2.0.
6. Kokoro 82M
Kokoro 82M là mô hình chuyển văn bản thành giọng nói gọn nhẹ với chỉ 82 triệu tham số. Phiên bản v1.0 cung cấp 54 giọng đọc bằng 8 ngôn ngữ khác nhau. Đây là một trong những lựa chọn dễ tiếp cận nhất cho các nhà phát triển muốn thử nghiệm tạo giọng nói mà không cần đến GPU cao cấp.
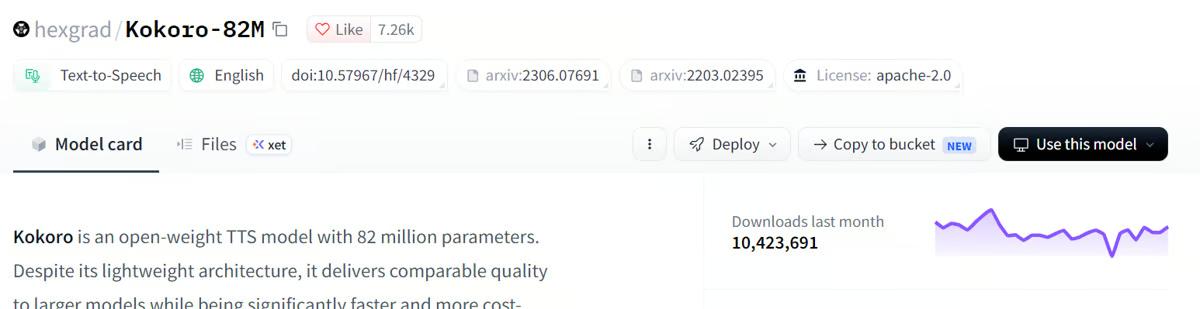
Ưu điểm chính của Kokoro là hiệu suất cao. Mô hình này phù hợp cho các ứng dụng đọc văn bản ngoại tuyến (offline), công cụ hỗ trợ tiếp cận và trợ lý ảo. Nhờ được phát hành dưới giấy phép Apache 2.0, bạn có thể sử dụng mô hình này trong các dự án thương mại.
Các LLM audio thời gian thực mã nguồn mở tốt nhất
Các mô hình ngôn ngữ lớn (LLM)) audio thời gian thực có khả năng lắng nghe những câu hỏi bằng lời nói và tạo ra phản hồi bằng giọng nói tự nhiên. Thay vì kết hợp các hệ thống nhận dạng giọng nói và chuyển đổi văn bản thành giọng nói riêng biệt, những mô hình này xử lý các cuộc hội thoại liên tục, những tình huống ngắt lời, cũng như việc lắng nghe và nói đồng thời trong cùng một mô hình duy nhất.
7. MiniCPM-o 4.5
MiniCPM-o 4.5 là một mô hình đa phương thức với 9 tỷ tham số từ OpenBMB, có khả năng hiểu hình ảnh, video, âm thanh và văn bản, đồng thời phản hồi bằng giọng nói. Mô hình này hỗ trợ các cuộc hội thoại bằng giọng nói theo thời gian thực bằng tiếng Anh và tiếng Trung, tính năng Voice cloning và tương tác song công toàn phần (full-duplex). Tương tác song công toàn phần nghĩa là mô hình có thể lắng nghe, quan sát và nói cùng một lúc thay vì phải chờ đợi từng lượt hội thoại kết thúc.
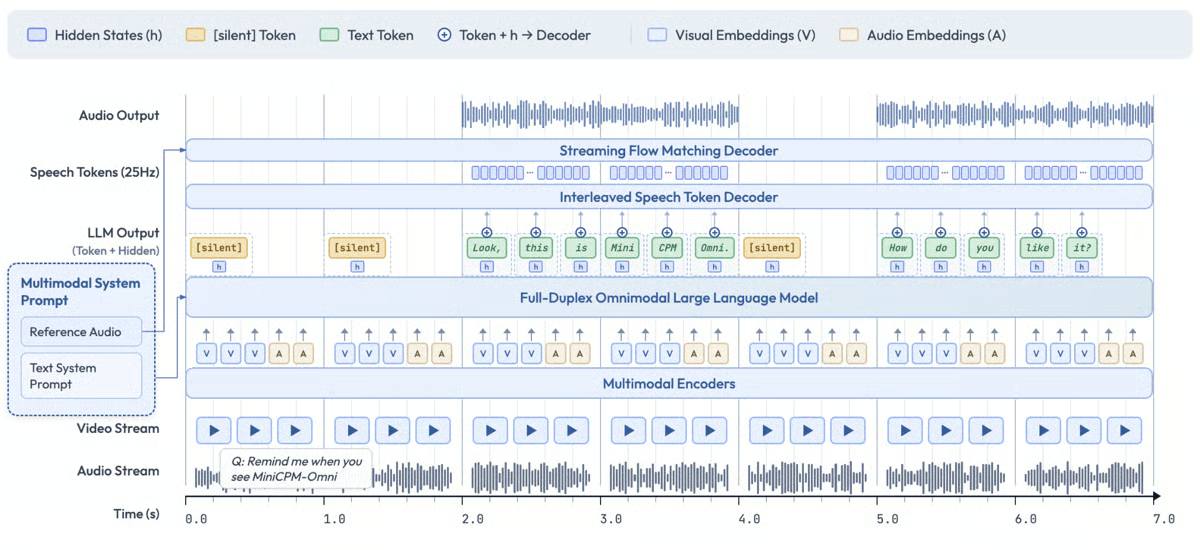
Điểm đặc biệt của mô hình này là sự kết hợp giữa khả năng hiểu hình ảnh và tương tác bằng giọng nói. Bạn có thể xây dựng các trợ lý ảo có khả năng trả lời những câu hỏi bằng lời nói về nội dung từ nguồn cấp dữ liệu camera trực tiếp, mô tả môi trường xung quanh, hoặc phản hồi các cuộc hội thoại trong khi vẫn đang xử lý video. Các trọng số của mô hình được phát hành theo giấy phép Apache 2.0; nhà phát triển cũng cung cấp một bản demo web có thể sử dụng ngay, mặc dù tính năng stream song công toàn phần vẫn đang trong giai đoạn thử nghiệm.
8. NVIDIA PersonaPlex
NVIDIA PersonaPlex là mô hình chuyển đổi giọng nói-sang-giọng nói (speech-to-speech) với 7 tỷ tham số, được thiết kế cho các cuộc hội thoại tự nhiên theo thời gian thực. Được xây dựng dựa trên kiến trúc Moshi, mô hình này hỗ trợ giao tiếp song công toàn phần (full-duplex), cho phép vừa lắng nghe vừa phản hồi cùng một lúc. Hệ thống có khả năng xử lý các tình huống ngắt lời hoặc chồng chéo giọng nói mà không cần đến những hệ thống riêng biệt cho việc chuyển đổi giọng nói thành văn bản (transcription) và tạo giọng nói (speech generation).
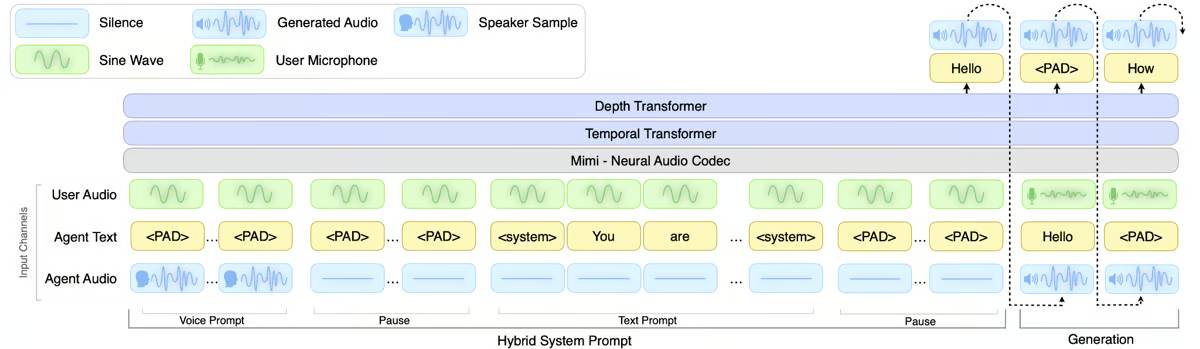
PersonaPlex cho phép bạn kiểm soát giọng nói và tính cách của trợ lý ảo, giúp các nhà phát triển tùy chỉnh vai trò hội thoại và phong cách giao tiếp - phù hợp cho những ứng dụng như trợ lý dịch vụ khách hàng, gia sư ảo hoặc các voice agent khác. Mô hình này tập trung vào hội thoại qua âm thanh và không hỗ trợ đầu vào hình ảnh; vì vậy, hãy chọn MiniCPM-o nếu bạn cần tính năng video. Các trọng số của mô hình được phát hành theo giấy phép NVIDIA Open Model License.
Các mô hình tạo âm thanh và nhạc mã nguồn mở tốt nhất
Các mô hình tạo audio có khả năng tạo ra âm nhạc, nhạc cụ và giai điệu nguyên bản từ những câu lệnh văn bản (text prompt). Một số mô hình còn có thể tạo ra các bài hát hoàn chỉnh kèm giọng hát, chỉnh sửa những bản ghi âm có sẵn, hoặc tạo nhạc dựa trên một giai điệu tham chiếu.
9. ACE-Step 1.5
ACE-Step 1.5 là một mô hình tạo nhạc mã nguồn mở, cho phép tạo ra các bài hát hoàn chỉnh từ mô tả bằng văn bản. Mô hình này hỗ trợ giọng hát, lời bài hát tùy chỉnh, đa dạng phong cách âm nhạc và có thể tạo các bài hát với độ dài lên đến 10 phút. Bạn cũng có thể kiểm soát nhịp độ (tempo), tông nhạc (key) và thời lượng, hoặc sử dụng các bản ghi âm sẵn có để tạo bản cover và chỉnh sửa từng phần của bài hát.
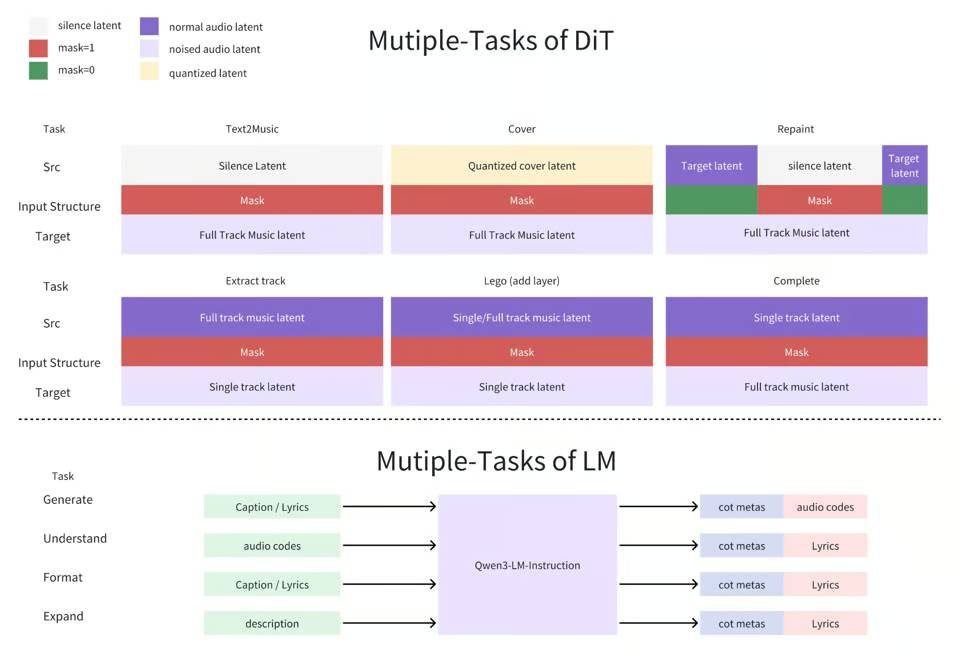
ACE-Step nổi bật nhờ tính dễ tiếp cận so với các mô hình tạo âm nhạc quy mô lớn hơn. Mô hình này có thể chạy trên phần cứng từ NVIDIA, AMD, Intel và Apple Silicon; theo báo cáo kỹ thuật, nó có thể vận hành trên các GPU với dung lượng VRAM dưới 4 GB. Tài liệu README của dự án cho biết thời gian tạo một bài hát hoàn chỉnh là dưới 2 giây trên GPU A100 và dưới 10 giây trên GPU RTX 3090.
Dự án bao gồm giao diện web Gradio và REST API. Các phiên bản XL (sử dụng DiT decoder với 4 tỷ tham số) ưu tiên chất lượng âm thanh hơn là tiết kiệm bộ nhớ, đòi hỏi ít nhất 12 GB VRAM (nếu sử dụng tính năng offload) hoặc 20 GB VRAM (nếu không sử dụng). Dự án được phát hành theo giấy phép MIT.
10. Meta MusicGen Large
MusicGen Large là mô hình chuyển văn bản thành âm nhạc với 3,3 tỷ tham số, được Meta phát triển trong khuôn khổ dự án AudioCraft. Mô hình này tạo ra các bản nhạc không lời dựa trên những mô tả bằng văn bản về thể loại, tâm trạng, nhạc cụ và phong cách âm nhạc. Đây là phiên bản mô hình lớn nhất trong loạt mô hình MusicGen đầu tiên được Meta công bố.
MusicGen Large có khả năng tạo ra các đoạn nhạc nền, nhạc phim và những bản nhạc không lời chi tiết chỉ từ vài từ mô tả. Mô hình này tương thích với thư viện Transformers của Hugging Face và dự án AudioCraft. Đây cũng là mô hình lâu đời nhất trong danh sách này. Meta đã huấn luyện mô hình vào tháng 4 và tháng 5 năm 2023 trên 20.000 giờ âm nhạc có bản quyền; tuy nhiên, mô hình không thể tạo ra giọng hát chân thực.
Khuyến nghị nên sử dụng GPU. Các trọng số được huấn luyện sẵn sử dụng giấy phép CC BY-NC 4.0 (hạn chế mục đích thương mại), trong khi code được phát hành theo giấy phép MIT.
Bạn nên đọc
-

Các mô hình AI mã nguồn mở hay trả phí sẽ giành lợi thế trong tương lai?
-
4 LLM cục bộ nhỏ gọn nhưng mạnh mẽ đáng để trải nghiệm trên máy tính
-
5 trợ lý AI đáng để bạn dành thời gian trải nghiệm
-
Cách chọn mô hình AI phù hợp trong ElevenAgents
-
Các mô hình AI tốt nhất cho Agentic Workflow năm 2026
-
Claude Code vs Codex: AI nào tốt hơn cho công việc văn phòng?
-
8 agent lập trình tốt nhất cho VS Code
-
TOP ứng dụng AI gia sư tiếng Anh tốt nhất năm 2026
-
Cách lựa chọn mô hình AI phù hợp cho việc tạo văn bản



Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:

 AI List
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

