 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

Với việc ra mắt LLM cục bộ nhỏ gọn mới diễn ra với tần suất vài tuần một lần, một số người đã dành nhiều ngày cuối tuần hơn mức mình muốn thừa nhận để thử nghiệm các mô hình, điều chỉnh cài đặt tài nguyên và tìm hiểu xem cái gì thực sự chạy tốt trên 8 GB RTX 3060 đáng tin cậy của họ. Các phiên bản bị loại bỏ, rút gọn và lượng tử hóa mạnh mẽ đã giúp những mô hình có khả năng truy cập dễ dàng hơn trên phần cứng hạn chế, nhưng với rất nhiều mô hình sắp ra mắt, thật khó để tìm được những lựa chọn xứng đáng với thời gian bạn bỏ ra.
Vì vậy, sau khi thử nghiệm vài chục mô hình, phạm vi đã được thu hẹp xuống còn 4 LLM cục bộ nhỏ gọn đáng trải nghiệm. Tất cả đều có sẵn trong LM Studio và Ollama, vì vậy bạn có thể tải chúng xuống một cách thuận tiện vào cuối tuần này mà không cần tìm kiếm qua các thư viện mô hình khác nhau.
Qwen3.8-9B-Distill
Thay thế thông minh hơn cho Qwen3.5-9B
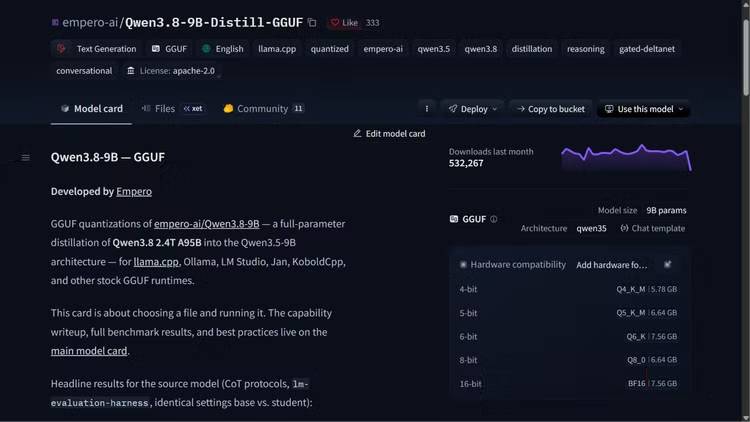
Qwen3.8-9B-Distill của Empero-AI đã trở thành mô hình yêu thích để chạy AI cục bộ trên desktop. Nó có thể không phải là mô hình 9B thú vị nhất hiện có nhưng nó tạo ra sự cân bằng tốt giữa tốc độ, mức sử dụng bộ nhớ và kiến thức chung.
Đây là phiên bản tinh chỉnh của Qwen3.5-9B, được đào tạo bằng cách sử dụng đầu ra từ mô hình Qwen3.8-2.4T A95B lớn hơn nhiều. Mặc dù nó thực sự không thể so sánh với cách Qwen3.8-27B có thể mang lại kết quả ở cấp độ Opus-4.6, nhưng LLM nhỏ hơn nhiều này vẫn mang lại sự cải tiến có ý nghĩa so với mô hình cơ sở của nó.
Như đã nêu trong card mô hình Hugging Face, sự đánh đổi là hiệu suất toán học giảm nhẹ, với độ chính xác của GSM8K giảm khoảng 1,5 điểm phần trăm. Đổi lại, kiến thức tổng quát cải thiện khoảng 20 điểm phần trăm trên MMLU và nó tuân theo các hướng dẫn có cấu trúc đáng tin cậy hơn.
Nó cũng hỗ trợ gọi hàm, lý luận và thậm chí cả tầm nhìn bằng cách tải xuống file mmproj bổ sung, khiến nó đặc biệt hữu ích cho các AI workflow cục bộ như tóm tắt tài liệu, trích xuất thông tin, làm việc với các công cụ và kết nối với tích hợp MCP.
Một số người sử dụng nó trong công cụ phân loại hình ảnh của mình. Đúng là nó chậm hơn đáng kể so với mô hình ONNX ML thông thường, nhưng nó phân loại các hình ảnh phức tạp chính xác hơn vì mô hình có thể suy luận thông qua những chi tiết hình ảnh không rõ ràng, trả về JSON có cấu trúc tốt và thực hiện nhiều lần cho đến khi đưa ra quyết định.
Nhìn chung, Qwen3.8-9B-Distill phù hợp cho những người muốn có một giải pháp thay thế cập nhật và hiệu quả hơn cho Qwen3.5-9B.
Ornith-1.5-9B
Agent lập trình tự cải tiến
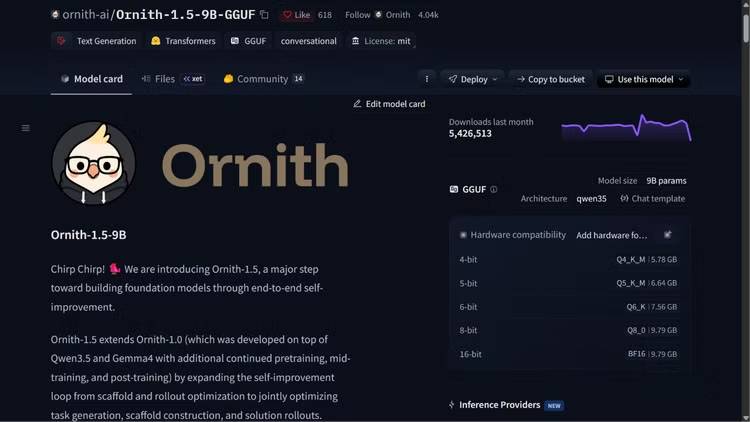
Ornith-1.5-9B của DeepReinforce là một LLM được xây dựng nhằm phục vụ lập trình agentic. Nó sử dụng Qwen-3.5-9B làm mô hình cơ sở và cải tiến trên Ornith-1.0-9B vốn đã phổ biến, một LLM hoạt động tốt so với các mô hình 35B lớn hơn trong một số tác vụ lập trình agentic. Chậm hơn một chút so với người anh em của nó, nhưng thực hiện công việc tốt hơn nhiều.
Điều khiến mô hình này có khả năng lập trình tốt là vòng lặp RL tự cải tiến của nó. Nó xem xét những vấn đề cần giải quyết, một kế hoạch tốt trông như thế nào và liệu vấn đề đó có thực sự được giải quyết hay không. Về cơ bản, mô hình này có có sẵn bộ khung vận hành được tích hợp từ trước riêng!
Sử dụng OpenCode làm công cụ khai thác phát triển bổ sung và vòng lặp RL của nó hoạt động tốt, nhiều người dùng đã xây dựng các trang đích và những công cụ CLI nhỏ với Ornith-1.5-9B chỉ trong một lần. Hạn chế chính là bạn có thể sẽ bị hạn chế trong các dự án nhỏ hơn. Vì quá trình tự cải thiện của nó tạo ra những kế hoạch, thử nghiệm các giải pháp và sửa đổi chúng nên nó có thể sử dụng nhiều token và ngữ cảnh hơn so với mô hình trò chuyện thông thường.
Hiện chưa tìm thấy mô hình 9B nào có khả năng hơn cho lập trình agentic. Nếu lập trình là trường hợp sử dụng chính của bạn và bạn chỉ có thể chạy các mô hình nhỏ hơn thì Ornith-1.5-9B rất đáng để thử vào cuối tuần này.
Qwythos-9B-v2
Lựa chọn tối ưu cho RP không kiểm duyệt và sáng tác văn học
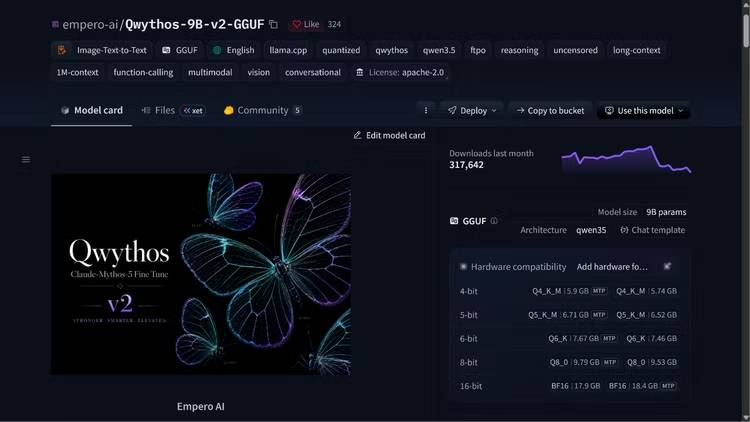
Mặc dù tên gọi của Qwythos-9B-v2 (do Empero AI phát triển) không chứa các từ như “uncensored” (không kiểm duyệt) hay “abliterated” (đã loại bỏ rào cản), nhưng mô hình này vẫn được thiết kế để không bị kiểm duyệt. Được xây dựng dựa trên nền tảng Qwen3.5-9B, phiên bản này là sự cải tiến so với Qwythos nguyên bản, với các tinh chỉnh nhằm giảm thiểu tình trạng lặp từ hoặc lặp lại nội dung.
Một số mô hình không kiểm duyệt khác cũng được thử nghiệm như DareDevil-8B, NeuralDaredevil-8B, Gemma-4-E4B-Uncensored và phiên bản “Heretic” của Qwen3.8-Distill. Trong số các mô hình quy mô nhỏ này, Qwythos-9B-v2 là lựa chọn ưng ý nhất cho các tác vụ sáng tạo. Mọi người đặc biệt ấn tượng với cách nó xử lý các phân cảnh hành động và tương tác giữa các nhân vật; kết quả mang lại sống động hơn hẳn so với những gì họ từng trải nghiệm với các mô hình Gemma đã thử nghiệm trước đó.
Đây là một trong những mô hình có tốc độ xử lý chậm hơn so với các mô hình khác từng được kiểm tra, nhưng nếu thiết lập đúng cách, hiệu suất sẽ cải thiện đáng kể. Trên thiết bị thử nghiệm, tốc độ đạt được gần 30 token mỗi giây với cửa sổ ngữ cảnh khoảng 68.000 token. Trong các bài kiểm tra, phản hồi từ mô hình cũng xuất hiện gần như ngay lập tức. Dù phải giảm độ chính xác của KV cache xuống mức Q5_1 để giải phóng tài nguyên, nhưng chất lượng văn bản trong các cuộc hội thoại vẫn không hề bị suy giảm.
Llama-3.2-3B-Instruct
Lựa chọn tối ưu cho các home server cấu hình thấp (chỉ sử dụng CPU)
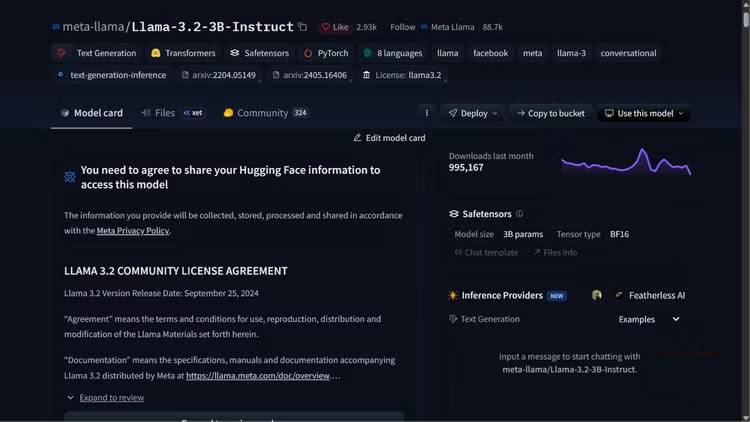
Llama-3.2-3B-Instruct là một lựa chọn đáng tin cậy cho các hệ thống LLM chạy cục bộ trên phần cứng có cấu hình khiêm tốn. Với 3,21 tỷ tham số, mô hình này mang lại sự cân bằng hợp lý giữa tốc độ, mức tiêu thụ bộ nhớ và kiến thức tổng quát, phù hợp cho các tác vụ trợ lý hàng ngày.
Đây là mô hình có thể cài đặt trên một chiếc máy tính cũ hoặc một mini PC home server chỉ sử dụng CPU, vốn cần duy trì hoạt động suốt cả ngày. Nó được tối ưu hóa cho các tác vụ như đối thoại đa ngôn ngữ, tóm tắt văn bản, tuân thủ chỉ dẫn và sử dụng công cụ; nhờ đó, khả năng thực tế của nó vượt xa so với quy mô nhỏ gọn của chính nó. Mô hình này đặc biệt phù hợp với những ai muốn sử dụng RAG (Retrieval-Augmented Generation) cho các hệ thống LLM chạy cục bộ, nhưng lại bị giới hạn về phần cứng và chỉ có thể vận hành những mô hình quy mô nhỏ.
Một số người đang sử dụng nó trên một home server có cấu hình thấp, chạy Project NOMAD, để truy vấn dữ liệu từ kho kiến thức cục bộ gồm nội dung từ Kiwix và các lưu trữ diễn đàn đã tải xuống. Mặc dù khả năng suy luận và kiến thức tổng quát của nó không bằng các mô hình 9B lớn hơn hay thậm chí là các mô hình 4B mới hơn, nhưng điều đó không quá quan trọng nếu mục tiêu của bạn chỉ là một AI có thể truy vấn kho dữ liệu cá nhân, tóm tắt kết quả và đưa ra câu trả lời dễ hiểu. Qua trải nghiệm thực tế trong nhiều tháng, các mô hình phiên bản "Instruct" (được tinh chỉnh để tuân theo chỉ dẫn) với quy mô 3B là ngưỡng tối thiểu; nếu nhỏ hơn mức này, mô hình dễ gặp tình trạng "ảo giác" và trở nên thiếu mạch lạc khi thực hiện các yêu cầu.
Điểm quan trọng hơn là mô hình này khởi chạy nhanh, tiêu tốn ít tài nguyên và đủ ổn định để duy trì hoạt động suốt cả ngày. Điều này đặc biệt hữu ích khi thiết bị chạy bằng pin hoặc trong các môi trường hạn chế về năng lượng.
Nếu bạn cần một trợ lý cục bộ đáng tin cậy trên phần cứng khiêm tốn và luôn trong trạng thái sẵn sàng hoạt động, thì Llama-3.2-3B Instruct là mô hình rất đáng để bạn thử nghiệm vào cuối tuần này.
Cách vận hành các mô hình này trên phần cứng của bạn
LLM chạy cục bộ tốt nhất không nhất thiết phải là mô hình lớn nhất hay mới nhất. Thông thường, để một mô hình vận hành hiệu quả, chìa khóa nằm ở việc chọn phiên bản (build) phù hợp với phần cứng và tinh chỉnh một vài thiết lập.
Bạn nên chọn phiên bản Q4_K_M nếu có sẵn. Nếu cần thêm không gian cho ngữ cảnh, hãy thử dùng Q8_0 cho cả K và V cache để giảm mức tiêu thụ bộ nhớ. Trong trường hợp mô hình và môi trường thực thi hỗ trợ giải mã MTP (Multi-Token Prediction), hãy thử thiết lập 3 "draft token" (token dự đoán nháp) và so sánh tốc độ với khi tắt MTP, thay vì mặc định rằng nó sẽ luôn nhanh hơn.
Bạn không nhất thiết phải thiết lập mọi thứ hoàn hảo ngay từ lần đầu tiên. Hãy bắt đầu với một mô hình, quan sát cách nó vận hành trên phần cứng của bạn, rồi điều chỉnh dần dần. Hãy nhớ rằng, việc tối ưu hóa các thiết lập cho phù hợp với phần cứng chính là lý do tại sao cùng một mô hình có thể chạy rất tốt trên máy của người này nhưng lại hoạt động kém trên máy của người khác.



 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

