 AI
 Hướng dẫn AI
 Claude
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích
So sánh GPT-6 Sol, Luna và Astra: Nên chọn mô hình nào của OpenAI?

Mua gói Thành viên QuanTriMang Pro để trải nghiệm website không quảng cáo và sử dụng các tiện ích AI trên QuanTriMang.
Mục lục bài viết
- GPT-6 Sol và GPT-6 Luna là gì?
- Bảng so sánh GPT-6 Sol, Luna và Astra
- Nên bắt đầu từ đâu?
- Cách truy cập GPT-6 Sol và Luna
- "Reasoning effort" (mức độ suy luận) thay đổi điều gì?
- Bài thực hành: kiểm tra một báo cáo chiến dịch hằng tuần
- Kiểm tra khả năng bám sát dữ liệu
- Ước tính chi phí cho từng mô hình
- Cách chọn mô hình cho một công việc lặp lại của riêng bạn
- Câu hỏi thường gặp
- Kết luận
OpenAI vừa mở rộng dòng GPT-6 với hai mô hình mới: GPT-6 Sol và GPT-6 Luna, bổ sung cho GPT-6 Astra ra mắt trước đó ít lâu. Ba mô hình này tạo thành một dải lựa chọn theo mức chi phí và độ "nặng" của bài toán, từ việc lặp lại đơn giản đến các dự án cần suy luận sâu, nhiều ràng buộc.
Bài viết này giúp bạn hiểu sự khác biệt giữa ba mô hình, cách chọn đúng cho từng loại việc, và một bài kiểm tra thực hành để tự đánh giá chất lượng trước khi giao việc quan trọng.
GPT-6 Sol và GPT-6 Luna là gì?
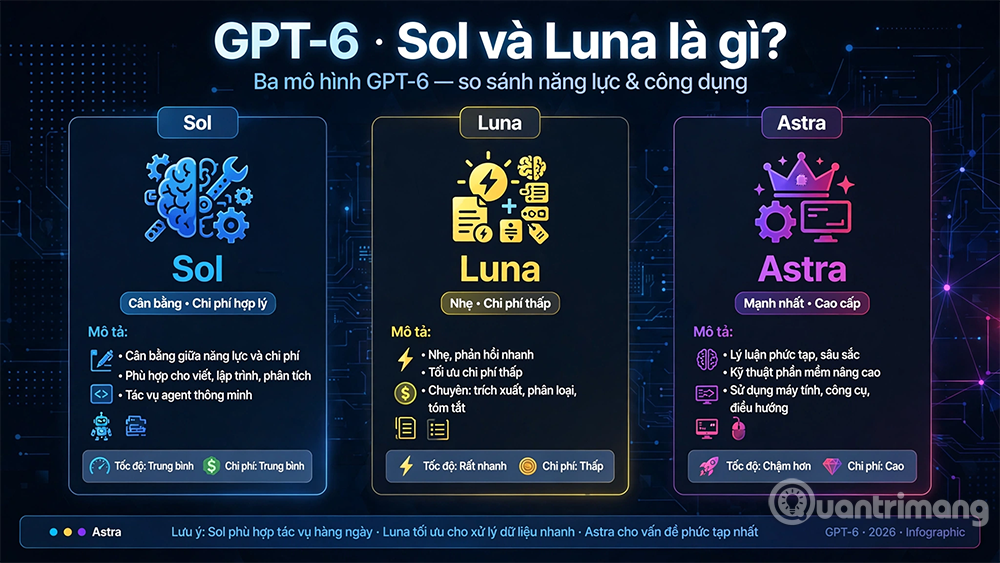
GPT-6 Sol là lựa chọn cân bằng giữa khả năng và chi phí, phù hợp với công việc viết, lập trình và phân tích cần đến khả năng phán đoán. Đây là mô hình được định vị cho các tác vụ lập trình dạng agent, dùng nhiều công cụ hoặc nhiều bước, và các dự án phát triển phần mềm cần kiểm tra cẩn thận qua nhiều bước.
GPT-6 Luna là mô hình nhẹ, chi phí thấp nhất trong dòng GPT-6, tối ưu cho phản hồi nhanh và khối lượng lớn. Luna phù hợp với việc trích xuất dữ kiện, phân loại văn bản, và tạo bản tóm tắt theo khuôn mẫu cố định.
GPT-6 Astra vẫn là mô hình mạnh nhất trong dòng, dành cho công việc đòi hỏi suy luận phức tạp, kỹ thuật phần mềm nâng cao và các thao tác trên máy tính (computer use) ở mức khó nhất.
Cả Sol và Luna đều được huấn luyện theo phương pháp tương tự Astra, mang một phần cải tiến của Astra về độ chính xác thông tin, chất lượng lập trình, khả năng thao tác máy tính và mức độ an toàn xuống các mô hình rẻ hơn.
Bảng so sánh GPT-6 Sol, Luna và Astra
|
Tiêu chí |
GPT-6 Sol |
GPT-6 Luna |
GPT-6 Astra |
|
Dùng cho |
Viết, lập trình và phân tích cần phán đoán |
Công việc lặp lại, tập trung một mục tiêu rõ |
Bài toán khó, dự án phức tạp nhiều ràng buộc |
|
Giá đầu vào API |
2 USD / triệu token |
0,10 USD / triệu token |
10 USD / triệu token |
|
Giá đầu ra API |
10 USD / triệu token |
0,50 USD / triệu token |
50 USD / triệu token |
|
Cửa sổ ngữ cảnh |
1.050.000 token |
1.050.000 token |
1.050.000 token |
|
Mã mô hình (API) |
gpt-6-sol |
gpt-6-luna |
gpt-6-astra |
Mức giá trên áp dụng cho xử lý văn bản tiêu chuẩn qua API, với yêu cầu tối đa 272.000 token đầu vào. Prompt dài hơn sẽ tính giá cao hơn. Gói ChatGPT và tín dụng sử dụng có điều khoản tính phí riêng, khác với giá API.
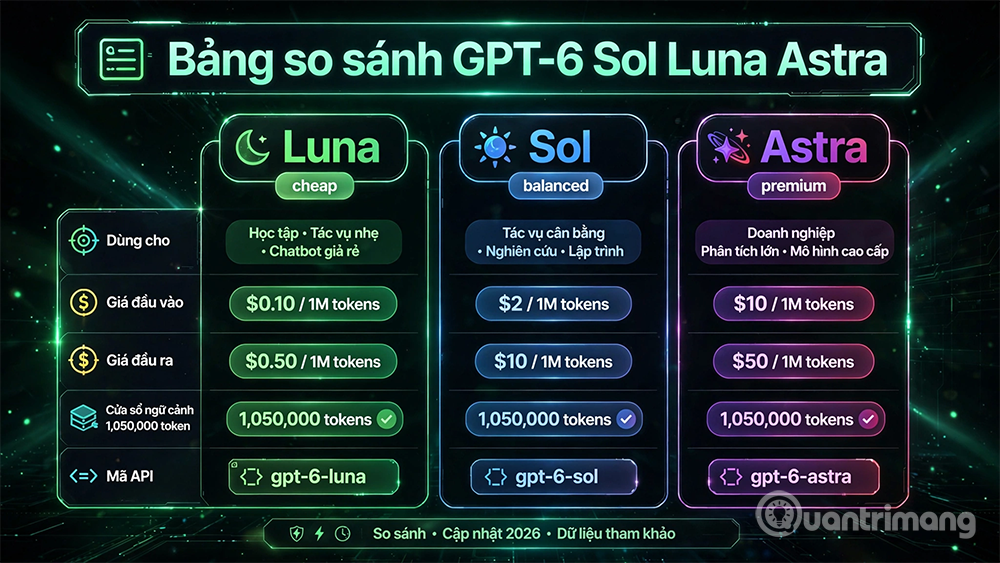
So với thế hệ GPT-5.6 trước đó, OpenAI đã giảm giá cho Sol và Luna khoảng một nửa. Cụ thể, GPT-6 Sol giảm từ 4/20 USD xuống còn 2/10 USD mỗi triệu token đầu vào/đầu ra. GPT-6 Luna giảm từ 0,20/1,20 USD xuống 0,10/0,50 USD. Mức giá mới của Sol và Luna cũng được ghi nhận là mức giá mặc định, không còn là giá khuyến mãi tạm thời như thế hệ trước.
Nên bắt đầu từ đâu?
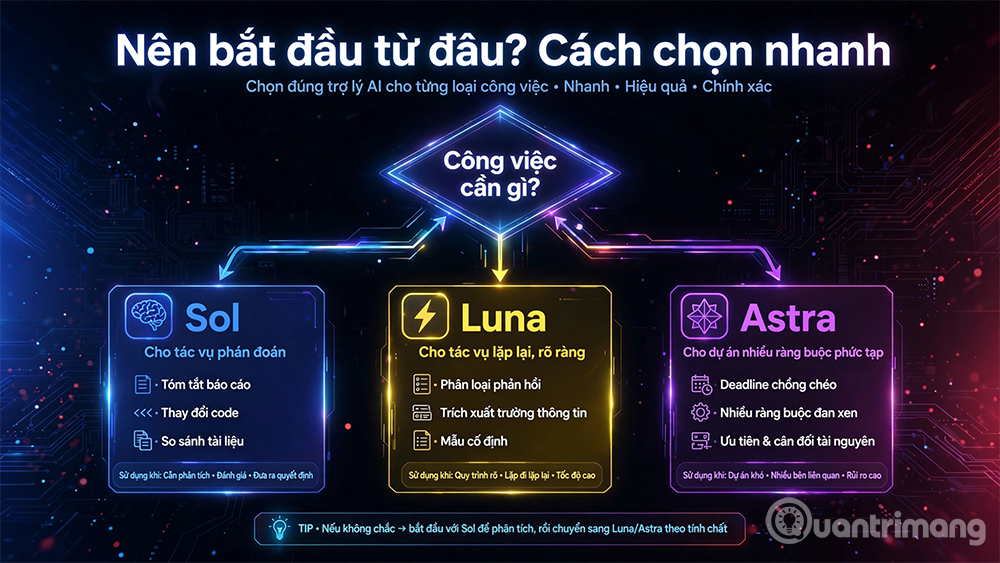
Cách chọn nhanh, theo hướng dẫn lựa chọn mô hình của OpenAI:
- Chọn Sol khi công việc cần phán đoán: một bản tóm tắt báo cáo, một bản tin chiến dịch, một thay đổi mã nguồn, hay so sánh hai tài liệu.
- Chọn Luna khi công việc rõ ràng và lặp lại nhiều lần: phân loại phản hồi khách hàng, trích xuất trường dữ liệu, hoặc chuyển ghi chú thành mẫu tóm tắt cố định.
- Chọn Astra khi bài toán khó, có nhiều ràng buộc xung đột: kế hoạch dự án với hạn chót chồng chéo, nhân sự hạn chế và nhiều yêu cầu cùng lúc.
Nguyên tắc chung: bắt đầu với Sol cho việc cần phán đoán, Luna cho việc lặp đi lặp lại, và chỉ chuyển sang Astra khi bài toán thực sự khó. Sau khi chọn, hãy thử nghiệm trên chính công việc bạn có thể tự kiểm tra kết quả, thay vì tin tưởng ngay từ lần chạy đầu.
Cách truy cập GPT-6 Sol và Luna
GPT-6 Sol và Luna hiện có trong ChatGPT Work và Codex cho phần lớn tài khoản trả phí (Plus, Pro, Business, Enterprise, Edu), cũng như trong API ChatGPT. Luna cũng được cung cấp trên ứng dụng desktop cho người dùng gói Free và Go. Việc triển khai diễn ra dần trong ngày ra mắt, và quản trị viên tài khoản Enterprise cần tự bật mô hình mới cho tổ chức của mình. Vì vậy, khả năng truy cập thực tế phụ thuộc vào loại tài khoản, không gian làm việc, ứng dụng bạn dùng và tiến độ triển khai.
Trong giao diện Work hoặc Codex, bạn mở phần chọn mô hình hoặc mục điều khiển hiệu năng ngay bên dưới ô nhập prompt. Với người dùng API, bạn chọn trực tiếp bằng mã mô hình trong bảng ở trên. Trước khi so sánh các mô hình, hãy ghi lại chính xác tên mô hình bạn đang dùng, vì tên hiển thị trên giao diện đôi khi khác với mã API.
"Reasoning effort" (mức độ suy luận) thay đổi điều gì?
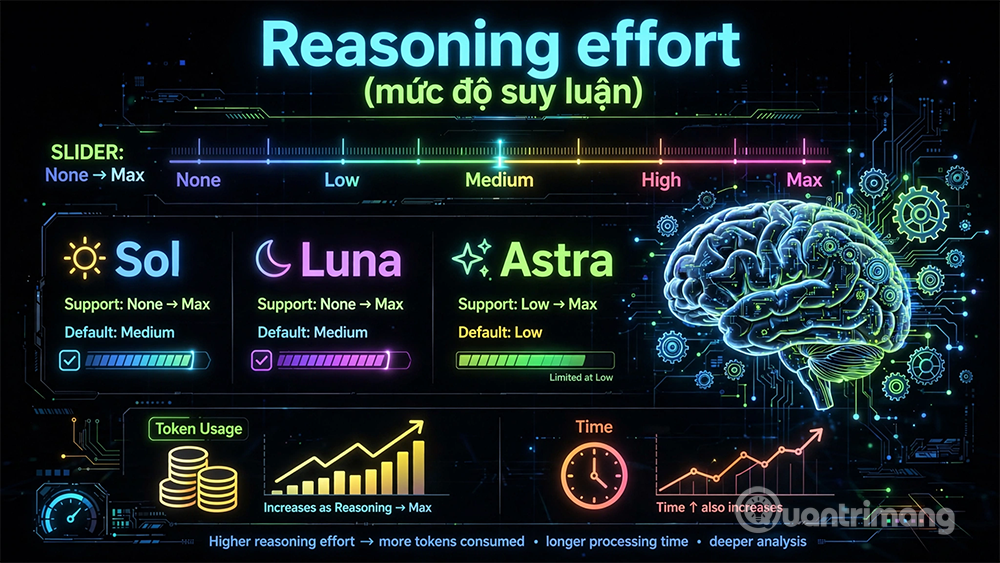
Mức độ suy luận (reasoning effort) quyết định mô hình có bao nhiêu "không gian" để xử lý một bài toán. Đặt mức cao hơn có thể khiến mô hình mất nhiều thời gian hơn và dùng nhiều token hơn. Nên bắt đầu bằng mức mặc định của mô hình rồi điều chỉnh theo yêu cầu công việc cụ thể.
Trong API, Sol và Luna mặc định ở mức trung bình (medium), và hỗ trợ dải mức từ none đến max. Astra hỗ trợ từ mức low đến max. Mức mặc định trên sản phẩm (ChatGPT) có thể khác với mặc định trên API, nên nếu so sánh giữa các mô hình, hãy kiểm tra và ghi lại đúng mức bạn đang dùng cho từng mô hình.
Khi thử nghiệm so sánh, hãy giữ nguyên mức suy luận, cùng một prompt và cùng bộ công cụ cho tất cả các mô hình. Cách này giúp phép so sánh công bằng hơn, dù mỗi mô hình vẫn có thể mất thời gian và tài nguyên tính toán khác nhau.
Bài thực hành: kiểm tra một báo cáo chiến dịch hằng tuần
Cách tốt nhất để chọn đúng mô hình không phải nhìn bảng thông số, mà là chạy thử trên chính loại việc bạn hay làm. Dưới đây là hai bài tập bạn có thể áp dụng ngay, với dữ liệu tự tạo để dễ tự kiểm tra kết quả.
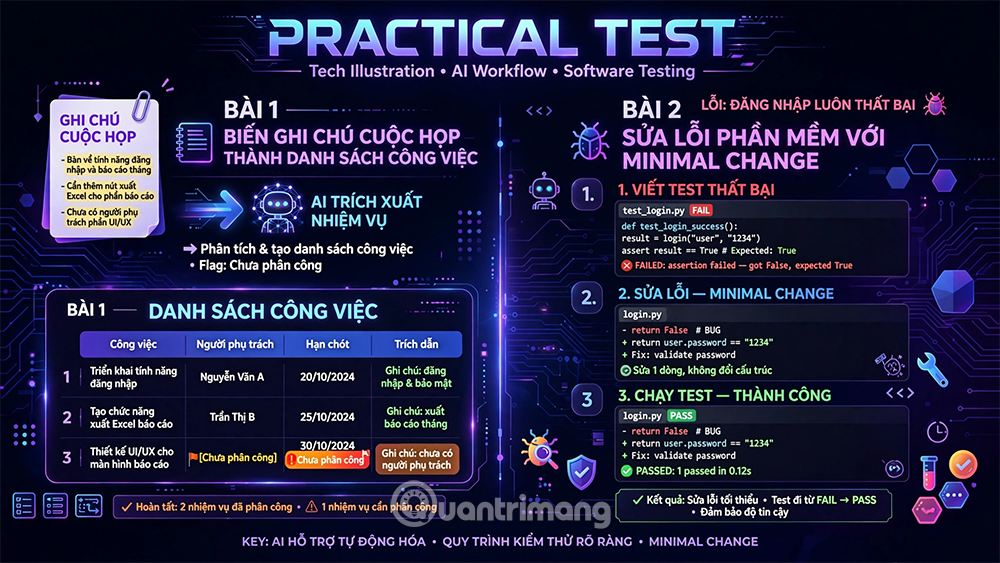
Bài 1: Biến ghi chú cuộc họp thành danh sách công việc
Dán ghi chú cuộc họp (có thể là ghi chú thật hoặc tự soạn) sau prompt mẫu, yêu cầu mô hình:
- Trích xuất các công việc đã được thống nhất, trình bày dưới dạng bảng gồm: Công việc, Người phụ trách, Hạn chót, Trích dẫn hỗ trợ.
- Sao chép nguyên văn phần trích dẫn hỗ trợ từ ghi chú gốc.
- Điền "Chưa phân công" nếu thiếu người phụ trách, và "Chưa có hạn chót" nếu thiếu ngày.
- Tách riêng các ý tưởng chưa được thống nhất rõ ràng vào mục "Cần quyết định thêm", đồng thời gắn cờ những chỗ mâu thuẫn giữa các phát biểu.
Khi xem kết quả, hãy kiểm tra kỹ hai điều: mỗi công việc có thực sự được ghi chú gốc hỗ trợ không, và mô hình có tự thêm người phụ trách hay ngày hạn nào không có trong ghi chú không. Đây là lỗi phổ biến khi mô hình "suy diễn" thay vì chỉ trích xuất.
Bài 2: Sửa lỗi phần mềm bằng thay đổi nhỏ, có thể kiểm thử
Trong một dự án thử nghiệm hoặc nhánh mã riêng, yêu cầu mô hình:
- Tìm nguyên nhân lỗi dựa trên các bước tái hiện đã cung cấp.
- Thực hiện thay đổi nhỏ nhất có thể để sửa lỗi.
- Viết một bài kiểm thử thất bại trước khi sửa và thành công sau khi sửa.
- Giữ nguyên hành vi các phần không liên quan đến lỗi.
- Hỏi trước khi thêm bất kỳ thư viện phụ thuộc nào.
- Báo cáo rõ các tệp đã thay đổi, các bài kiểm thử đã chạy, kết quả và rủi ro còn lại.
- Chờ được phê duyệt trước khi hợp nhất hoặc triển khai.
Sau khi mô hình hoàn thành, bạn nên tự kiểm tra bản vá và kết quả kiểm thử, ghi lại những chỉnh sửa không liên quan đến lỗi gốc, các trường hợp bị bỏ sót, và thời gian bạn phải bỏ ra để rà soát.
Kiểm tra khả năng bám sát dữ liệu
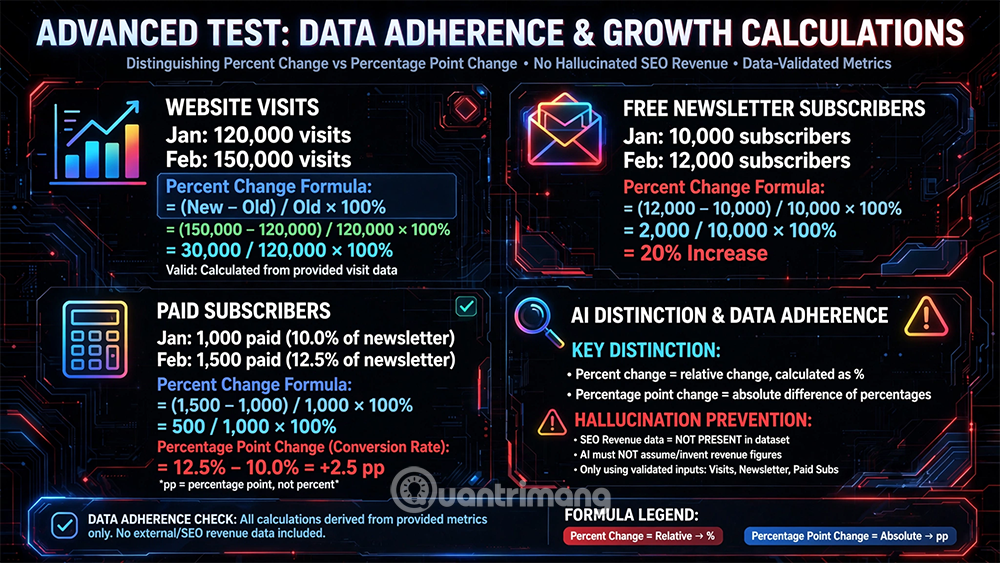
Ngoài hai bài trên, một cách kiểm tra hữu ích khác là đưa mô hình một báo cáo có số liệu rõ ràng, kèm theo một nhận định có thể đúng hoặc sai, rồi xem mô hình có "bắt lỗi" nhận định đó không.
Ví dụ, bạn đưa cho mô hình số liệu về lượt truy cập website, số người đăng ký nhận bản tin miễn phí và số người đăng ký gói trả phí trong hai tuần liên tiếp, không kèm dữ liệu về chi phí quảng cáo hay tỷ lệ giữ chân người dùng. Sau đó đưa ra một nhận định kiểu: "Tỷ lệ chuyển đổi trả phí tăng 25%, và kênh SEO đã mang lại một khoản doanh thu cụ thể, nên cần tăng gấp đôi ngân sách SEO."
Yêu cầu mô hình:
- Chỉ dùng đúng số liệu đã cung cấp, tính tốc độ tăng trưởng lượt truy cập và tăng trưởng đăng ký trả phí, kèm công thức tính rõ ràng cho từng bước.
- Soi từng phần trong nhận định trên: số liệu nào ủng hộ, số liệu nào mâu thuẫn, và phần nào cần thêm bằng chứng mới kết luận được.
- Phân biệt rõ giữa "phần trăm thay đổi" và "điểm phần trăm thay đổi", vì đây là hai khái niệm rất dễ nhầm.
- Viết một bản cập nhật ngắn cho đội nhóm, không quá 150 từ, bằng ngôn ngữ dễ hiểu, nêu rõ điều gì đã thay đổi, điều gì còn cần tìm hiểu thêm, và một việc nên kiểm tra tiếp theo. Tách riêng phần suy đoán nguyên nhân với phần sự kiện đã quan sát được.
Bài kiểm tra này rất hữu ích vì nó lộ ra một điểm yếu thường gặp: mô hình có xu hướng "bịa" ra mối liên hệ nhân quả (ví dụ gán doanh thu cho một kênh cụ thể) dù dữ liệu không hề nhắc đến kênh đó. Mô hình tốt sẽ chỉ ra rằng thiếu dữ liệu theo từng kênh nên không thể khẳng định điều này.
Hãy chạy cùng một bài kiểm tra này trên cả ba mô hình, giữ nguyên prompt và mức suy luận, rồi so sánh: mô hình nào tính đúng số học, mô hình nào bắt được nhận định thiếu căn cứ, và mô hình nào vô tình khẳng định điều dữ liệu không hỗ trợ.
Ước tính chi phí cho từng mô hình
Với một yêu cầu giả định gồm 20.000 token đầu vào chưa qua bộ nhớ đệm và 5.000 token đầu ra được tính phí, chi phí xử lý văn bản chuẩn qua API sẽ là:
|
Mô hình |
Chi phí đầu vào |
Chi phí đầu ra |
Tổng |
|
GPT-6 Luna |
0,002 USD |
0,0025 USD |
0,0045 USD |
|
GPT-6 Sol |
0,04 USD |
0,05 USD |
0,09 USD |
|
GPT-6 Astra |
0,20 USD |
0,25 USD |
0,45 USD |
Con số trên chỉ mang tính minh họa, dựa trên mức giá công bố và giữ số lượng token bằng nhau giữa các mô hình; chưa tính đến việc dùng bộ nhớ đệm, phí công cụ hay các điều chỉnh theo khu vực/mức xử lý. Báo cáo thực tế của bạn sẽ có số lượng token khác.
Một điểm cần lưu ý: phần token đầu ra được tính phí có thể bao gồm cả phần suy luận nội bộ không hiển thị ra câu trả lời cuối cùng. Vì vậy, khi so sánh chi phí giữa các mô hình, nên kiểm tra trực tiếp bản ghi sử dụng API thay vì chỉ ước lượng theo độ dài câu trả lời nhìn thấy. Mức suy luận cao hơn, số lần thử lại nhiều hơn hay câu trả lời dài hơn đều có thể làm tăng chi phí thực tế.
Cũng cần chú ý về độ dài đầu vào: các prompt vượt quá 272.000 token sẽ bị tính giá đầu vào và bộ nhớ đệm gấp đôi, còn giá đầu ra tăng thêm 50% cho toàn bộ yêu cầu đó.
Với công việc lặp lại thường xuyên, nên so sánh tổng chi phí trên cả một lô công việc, tính luôn cả thời gian bạn bỏ ra để sửa lỗi kết quả sai, thay vì chỉ nhìn giá mỗi token. Một phép thử nhỏ ban đầu sẽ giúp bạn quyết định mô hình nào đáng để thử nghiệm ở quy mô lớn hơn.
Cách chọn mô hình cho một công việc lặp lại của riêng bạn
Bạn có thể áp dụng quy trình bốn bước sau để tự đánh giá:
- Chọn một việc bạn làm mỗi tuần — ví dụ đọc báo cáo, phân loại phản hồi khách hàng, hoặc rà soát mã nguồn.
- Chuẩn bị vài ví dụ mẫu kèm kết quả đúng mà bạn tự xác định trước.
- Chạy cùng một prompt trên cả ba mô hình , giữ nguyên mức suy luận và công cụ hỗ trợ.
- Lưu lại prompt, cài đặt và câu trả lời đầu tiên của mỗi mô hình. Đây sẽ là tài liệu tham khảo hữu ích khi có mô hình mới ra mắt hoặc khi tính chất công việc của bạn thay đổi.
Câu hỏi thường gặp
GPT-6 Sol có thay thế được Astra không?
- Không hoàn toàn. Sol là lựa chọn cân bằng chi phí - hiệu năng cho phần lớn công việc viết và lập trình hằng ngày, nhưng với bài toán khó, nhiều ràng buộc xung đột, Astra vẫn là mô hình mạnh nhất trong dòng.
Luna có phù hợp để viết nội dung sáng tạo không?
- Luna được tối ưu cho việc trích xuất, phân loại và tóm tắt theo khuôn mẫu cố định hơn là nội dung cần nhiều phán đoán hay sáng tạo. Với nội dung cần cân nhắc kỹ, Sol là lựa chọn phù hợp hơn.
Tại sao giá của GPT-6 Sol và Luna lại giảm so với thế hệ trước?
- OpenAI cho biết cải tiến trong bộ nhớ đệm và suy luận giúp phục vụ các mô hình này với chi phí thấp hơn, và mức giá mới cũng được xác nhận là giá mặc định lâu dài, không chỉ là ưu đãi tạm thời.
Bạn có thể dùng cùng một prompt cho cả ba mô hình không?
- Có, và đây là cách kiểm tra công bằng nhất. Hãy giữ nguyên prompt, mức suy luận và công cụ hỗ trợ, chỉ đổi mô hình, để so sánh đúng bản chất khác biệt giữa chúng.
Kết luận
GPT-6 Sol và Luna không phải phiên bản "rút gọn" đơn thuần của Astra, mà là hai điểm dừng khác nhau trên cùng một đường cong chi phí - năng lực: Luna cho khối lượng lớn với chi phí cực thấp, Sol cho công việc hằng ngày cần phán đoán, và Astra dành riêng cho bài toán khó nhất. Cách chọn đáng tin cậy nhất không phải nhìn thông số trên giấy, mà là chạy thử trên chính công việc bạn có thể tự kiểm tra kết quả, đo cả độ chính xác lẫn chi phí thực tế trước khi quyết định dùng mô hình nào cho quy mô lớn.
Bạn nên đọc

Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 ChatGPT
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

