Từ Bài 2 đến Bài 4, bạn đã bắt gặp 4 chỉ số: Xác suất của một khẳng định (predicate), xác suất và độ tin cậy của một lựa chọn, cùng với giá trị trung bình có trọng số của một điểm số. Tất cả những con số này đều là các ước tính do mô hình đưa ra, chứ không phải là độ chính xác thực tế đã được đo lường. Con số "0,92" không có nghĩa là "đúng 92% số lần". Nó chỉ có nghĩa là ước tính nội bộ của mô hình là 0,92; còn việc con số đó có khớp với thực tế trên dữ liệu của bạn hay không là điều bạn cần phải tự kiểm chứng.
Hướng dẫn của OpenAI tóm gọn điều này trong một câu: "Hãy sử dụng các ví dụ đã được gán nhãn từ ứng dụng của bạn để thiết lập ngưỡng (threshold) cho việc định tuyến, lọc hoặc xem xét dữ liệu. Hãy chọn các ngưỡng này dựa trên chi phí phát sinh từ các trường hợp dương tính giả (false positive) và âm tính giả (false negative)". Bài học này chính là sự giải thích chi tiết cho câu nói đó.
Ngưỡng giúp chuyển đổi một con số thành hành động
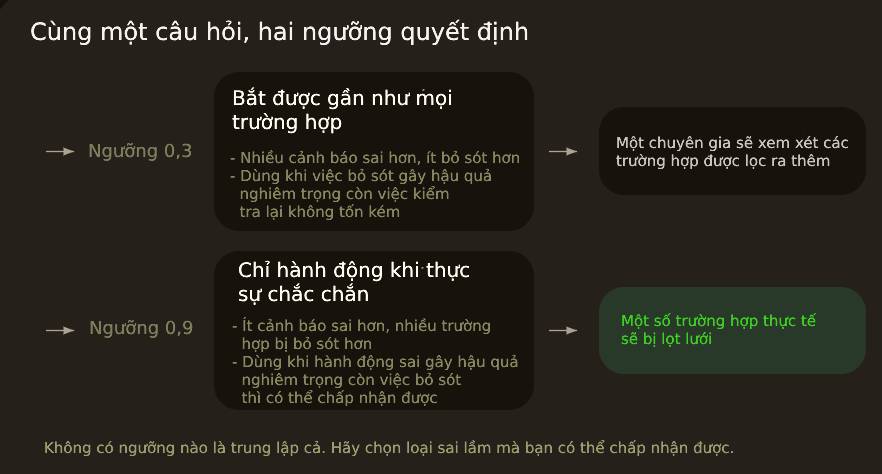
Ngưỡng là một mốc giới hạn do bạn chọn: Nếu vượt quá ngưỡng, hãy thực hiện hành động X; nếu thấp hơn ngưỡng, hãy thực hiện hành động Y. Mỗi ngưỡng đều có thể dẫn đến hai loại sai sót:
Dương tính giả (False positive): Mô hình dự đoán là "có", nhưng thực tế là "không". (Ví dụ, một bức ảnh chụp vật phẩm còn nguyên vẹn lại bị gắn nhãn là "đã hư hỏng").
Âm tính giả (False negative): Mô hình dự đoán là "không", nhưng thực tế là "có". (Ví dụ, một vật phẩm thực sự bị hư hỏng lại được mô hình bỏ qua/cho qua).
Việc thay đổi ngưỡng sẽ tạo ra sự đánh đổi giữa hai loại sai sót này. Đó chính là bản chất của vấn đề.
Ví dụ thực tế: Biên lai trùng lặp
Một nhóm phụ trách chi phí áp dụng tiêu chí kiểm tra: "Báo cáo này có chứa biên lai nào trùng lặp với một biên lai khác trong cùng báo cáo đó không?"
Các con số liên quan:
Báo động giả (dương tính giả): Kiểm toán viên mất năm phút để kiểm tra. Chi phí thấp.
Bỏ sót (âm tính giả): Công ty thanh toán nhầm cho một biên lai trùng lặp, với số tiền trung bình là 340 USD. Chi phí cao.
Tỷ lệ cơ sở: Khoảng 2% số báo cáo.
Vì việc bỏ sót gây tốn kém hơn nhiều so với việc kiểm tra, họ thử nghiệm các ngưỡng xem xét thấp hơn và chấp nhận tốn thêm thời gian của kiểm toán viên, miễn là những ví dụ được gắn nhãn cho thấy số lượng các trường hợp bỏ sót gây tốn kém giảm đi. Chỉ riêng chi phí và tỷ lệ cơ sở 2% là chưa đủ để xác định một ngưỡng cắt cụ thể; cần đo lường cách các trường hợp phân bổ theo điểm số của mô hình, sau đó đánh giá khối lượng công việc kiểm tra và những sai sót trên tập dữ liệu dành riêng cho việc kiểm định. Một nhóm mà ở đó hành động đưa ra có thể gây hậu quả nghiêm trọng (ví dụ: khóa tài khoản) sẽ đòi hỏi bằng chứng xác thực hơn trước khi hành động, đồng thời chuyển các trường hợp không chắc chắn sang quy trình xem xét thủ công.
Kiểm tra nhanh: Tiêu chí của bạn kích hoạt một email tự động gửi đến khách hàng. Nếu gửi nhầm email, công ty sẽ rơi vào tình huống khó xử; nếu bỏ sót không gửi, thì chỉ cần chờ con người xử lý sau. Vậy nên đặt ngưỡng cao hay thấp?
Đáp án: Cao. Ở đây, việc gửi nhầm - tức dương tính giả - chính là sai lầm gây tốn kém.
Tại sao con số "0,9" chỉ là một thiết lập, không phải là một lời cam kết?
Đây là phần mà hầu hết các nhóm thường bỏ qua. Giả sử bạn đặt ngưỡng là 0,9 và tự động thực hiện hành động khi điểm số vượt quá mức này. Liệu điều đó có nghĩa là 90% các hành động tự động của bạn đều chính xác? Điều này chỉ đúng nếu mô hình được hiệu chuẩn dựa trên dữ liệu của bạn - nghĩa là khi mô hình đưa ra con số 0,9, thì xác suất đúng thực tế là 90%.
Điều này không mặc nhiên đúng. Năm 2017, Guo cùng các cộng sự đã chỉ ra rằng các mạng nơ-ron nhân tạo hiện đại thường bị hiệu chuẩn sai: Mức độ tự tin mà mô hình đưa ra thường cao hơn độ chính xác thực tế quan sát được. OpenAI không công bố dữ liệu hiệu chuẩn cho mô hình gpt-6-luna trên endpoint dành cho các quyết định. Trong tuần đầu tiên thử nghiệm phiên bản beta, các nhà phát triển trên diễn đàn của OpenAI đã báo cáo (thông tin từ cộng đồng, chưa được nhà cung cấp xác thực) rằng xác suất cho những câu hỏi lựa chọn có vẻ cực đoan hơn so với xác suất thực tế trong một bài kiểm tra đơn giản. Một người thử nghiệm thậm chí ghi nhận số lượng "câu trả lời sai nhưng đầy tự tin" từ mô hình này cao gấp khoảng 3 lần so với một mô hình đối thủ khi thực hiện các đánh giá đòi hỏi sự tinh tế. Vì vậy, phát biểu trung thực nhất là: Ngưỡng 0,9 chỉ là một thiết lập mang tính thử nghiệm cho đến khi bạn thực sự đo lường được kết quả của nó.
Kiểm tra với 50 ví dụ
Bạn có thể bắt đầu khám phá bằng một bảng tính. Tuy nhiên, cách kiểm tra quy mô nhỏ này là chưa đủ để xác thực một chính sách ra quyết định tự động.
Hãy thu thập 50 dữ liệu đầu vào thực tế từ quy trình làm việc của bạn. Bao gồm các trường hợp thông thường, một vài trường hợp mơ hồ và bất kỳ trường hợp nào từng gây rắc rối trước đây.
Tự mình gán nhãn cho chúng (hoặc nhờ người trực tiếp thực hiện công việc đó gán nhãn). Đây sẽ là cột "truth".
Chạy câu hỏi trên cả 50 ví dụ này và ghi lại con số mà API trả về.
Sắp xếp theo những con số đó và chia thành các nhóm (dải giá trị): 0,0–0,2; 0,2–0,4; 0,4–0,6; 0,6–0,8; 0,8–1,0.
Trong mỗi nhóm, hãy đếm số lượng kết quả dương tính và tổng số ví dụ. So sánh tỷ lệ dương tính quan sát được với xác suất dự đoán; lưu ý rằng các nhóm có quá ít ví dụ sẽ không mang lại kết luận đáng tin cậy. Với tỷ lệ cơ sở (base rate) là 2%, 50 báo cáo đại diện có thể chỉ chứa một trường hợp dương tính thực tế, vì vậy việc chia thành 5 nhóm nhỏ sẽ không đủ để xác định độ hiệu chuẩn hay làm cơ sở cho các hành động tự động. Việc lấy mẫu quá mức (oversampling) các trường hợp dương tính đã biết có thể giúp chẩn đoán hành vi của hệ thống, nhưng nó làm thay đổi tỷ lệ cơ sở và không thể dùng để ước tính hiệu suất trong môi trường thực tế (production).
Hãy đếm số lượng các câu trả lời sai nhưng có độ tự tin cao tại ngưỡng mà bạn dự định áp dụng. Chính con số này – chứ không phải độ chính xác tổng thể – mới là yếu tố dẫn đến các khiếu nại từ người dùng.
Trước khi triển khai bất kỳ hành động tự động nào:
Hãy thu thập một tập dữ liệu đại diện lớn hơn và tách biệt (tập dữ liệu kiểm chứng). Chọn một ngưỡng tạm thời dựa trên các ví dụ trong giai đoạn phát triển, cố định ngưỡng đó lại, rồi đo lường những trường hợp bỏ sót (misses), báo động giả (false alarms), khối lượng công việc cần xem xét lại (review volume) và mức độ không chắc chắn trên các dữ liệu độc lập. 50 ví dụ chỉ là điểm khởi đầu mang tính khám phá, đặc biệt là đối với các sự kiện hiếm gặp.
Đối với những sai sót hiếm gặp nhưng gây hậu quả nghiêm trọng, hãy thiết lập một cơ chế kiểm soát riêng. Nếu một loại sai sót có thể dẫn đến hậu quả thảm khốc, hãy bổ sung một quy tắc thứ hai dành riêng cho nó (kỹ thuật "xem xét xác suất theo từng cấp độ" được đề cập trong Bài học 4 là một ví dụ).
Kiểm tra nhanh: Bạn có 50 ví dụ đã được gán nhãn và muốn chọn một ngưỡng. Tại sao không chọn ngưỡng mang lại kết quả tốt nhất trên cả 50 ví dụ đó rồi báo cáo con số đó?
Trả lời: Vì bạn đã tinh chỉnh mô hình dựa trên chính những ví dụ đó; con số này mang tính lạc quan quá mức. Hãy giữ lại một phần dữ liệu để làm căn cứ đánh giá.
Thử ngay: Xây dựng kế hoạch thiết lập ngưỡng của bạn
Cách thực hiện: Mở ChatGPT, Claude hoặc Gemini trong một cuộc trò chuyện mới.
Cách sao chép: Nhấn Cmd+A rồi Cmd+C (trên Mac) hoặc Ctrl+A rồi Ctrl+C (trên Windows) bên trong khung văn bản.
Tôi đang thiết lập ngưỡng cho một quyết định dựa trên Decisions API của OpenAI. API này trả về một xác suất ước tính, chứ không phải độ chính xác đã được đo lường. OpenAI khuyến nghị nên xác định các ngưỡng dựa trên các ví dụ đã được gán nhãn, cân nhắc đến chi phí của các trường hợp dương tính giả (false positives) và âm tính giả (false negatives).
Quyết định cần đưa ra: [mô tả mệnh đề, lựa chọn hoặc câu hỏi cần đánh giá]
Chi phí của một trường hợp dương tính giả (mô hình dự đoán "có", nhưng thực tế là "không"): [mô tả chi tiết, kèm theo ước tính về chi phí bằng tiền hoặc thời gian]
Chi phí của một trường hợp âm tính giả (mô hình dự đoán "không", nhưng thực tế là "có"): [mô tả chi tiết, tương tự như trên]
Tần suất xảy ra trường hợp "có" trong thực tế: [tỷ lệ phần trăm ước tính]
Cách xử lý các trường hợp nằm ở giữa (không rõ ràng): [ví dụ: con người sẽ xem xét lại]
Hãy cung cấp cho tôi:
1. Loại lỗi nào cần được ưu tiên xử lý, và những ngưỡng hoặc phạm vi xem xét nào nên được so sánh dựa trên các ví dụ đã gán nhãn. Lưu ý: Không tự ý suy ra một con số ngưỡng cụ thể chỉ dựa trên chi phí và tỷ lệ cơ sở.
2. Kế hoạch gán nhãn cho 50 ví dụ: bao gồm sự kết hợp giữa các trường hợp thông thường, trường hợp mơ hồ và các trường hợp từng gây khó khăn trước đây; kèm theo bố cục bảng tính gồm các cột: dữ liệu đầu vào, nhãn do tôi xác định, giá trị xác suất từ API, và phạm vi tương ứng.
3. Một chỉ số duy nhất để báo cáo với cấp trên (số lượng trường hợp mô hình tự tin nhưng sai lệch tại ngưỡng quyết định) cùng một câu giải thích bằng ngôn ngữ đơn giản, làm rõ lý do tại sao chỉ số này phản ánh trung thực hơn so với độ chính xác tổng thể.
Nội dung nhận được: Các ngưỡng cần thử nghiệm, kế hoạch gán nhãn và một chỉ số báo cáo.
Cách sử dụng kết quả: Bổ sung các ngưỡng dự kiến và kế hoạch gán nhãn vào "Bảng đặc tả quyết định" (Decision Spec Sheet) của bạn. Hãy tiếp tục để con người xem xét lại các quyết định cho đến khi bạn xây dựng được một quy trình đã qua kiểm chứng độc lập.
Nếu kết quả có vẻ không hợp lý (ví dụ: nếu hệ thống cho rằng một xác suất nhất định "tương đương với độ chính xác 90%"), hãy hiểu rằng: "Xác suất đó chỉ là một ước tính và cần được kiểm chứng lại trên tập dữ liệu đã gán nhãn của chính bạn".
Những điểm chính cần lưu ý:
Ngưỡng quyết định giúp chuyển đổi một ước tính thành hành động cụ thể; mọi ngưỡng đều tạo ra sự đánh đổi giữa dương tính giả và âm tính giả. Hãy lựa chọn dựa trên việc loại lỗi nào gây ra chi phí lớn hơn.
Xác suất không phải là sự đảm bảo. OpenAI không công bố dữ liệu hiệu chuẩn cho endpoint này. 50 ví dụ được dán nhãn có thể chỉ ra vấn đề nhưng không thể xác thực ngưỡng tự động, đặc biệt là đối với các kết quả hiếm gặp.
Báo cáo các câu trả lời sai nhưng chắc chắn ở ngưỡng hành động của bạn, chứ không phải độ chính xác tổng thể.
Điều chỉnh trên một bộ dữ liệu, đo lường trên bộ dữ liệu khác.
Câu 1:
Phương pháp nào bảo vệ tốt nhất khỏi việc tự đánh lừa bản thân khi chọn ngưỡng?
GIẢI THÍCH:
Việc điều chỉnh và kiểm thử trên cùng một tập dữ liệu sẽ làm thổi phồng hiệu suất thực tế. Sử dụng một tập dữ liệu riêng biệt (tập dữ liệu kiểm thử độc lập) là giải pháp tiêu chuẩn; hướng dẫn kỹ thuật của Wavect cũng khuyến nghị phương pháp này cho các hệ thống ra quyết định. OpenAI không khẳng định rằng "độ tin cậy" (confidence) đã được hiệu chuẩn, và độ chính xác tổng thể thường che giấu bản chất của các loại lỗi đang xảy ra.
Câu 2:
Với 50 ví dụ đã được gán nhãn, thuật toán đưa ra kết quả từ 0,85 đến 0,95 cho 20 mục, nhưng chỉ có 11 trong số 20 mục đó thực sự là trùng lặp. Bạn nên rút ra kết luận gì?
GIẢI THÍCH:
Việc chỉ có 11 trường hợp dương tính trong số 20 mục có xác suất cao là một dấu hiệu cảnh báo, chứ chưa phải bằng chứng xác thực về sự sai lệch trong hiệu chuẩn, vì đây chỉ là một tập mẫu nhỏ. Hãy kiểm tra lại các nhãn và cách chọn mẫu, thu thập thêm các trường hợp mang tính đại diện hơn, đồng thời đánh giá bất kỳ ngưỡng mới nào trên tập dữ liệu độc lập. Việc chỉ đơn thuần nâng ngưỡng lên không giúp cải thiện độ hiệu chuẩn. Từ chối đưa ra dự đoán là một loại phản hồi khác biệt.
Câu 3:
Tình huống: Một thuật toán predicate gắn cờ các báo cáo chi phí có khả năng chứa biên lai trùng lặp. Một cảnh báo sai khiến kiểm toán viên mất 5 phút xử lý; nếu bỏ sót một trường hợp trùng lặp, công ty sẽ chịu tổn thất toàn bộ số tiền đó (trung bình là 340 USD). Tình trạng bỏ sót này xảy ra ở khoảng 2% số báo cáo. Chính sách ngưỡng (threshold policy) nào là điểm khởi đầu phù hợp nhất?
GIẢI THÍCH:
Hướng dẫn từ OpenAI khuyến nghị chọn ngưỡng "dựa trên chi phí của các trường hợp dương tính giả (false positives) và âm tính giả (false negatives)". Trong trường hợp này, một kết quả âm tính giả gây tổn thất cao gấp khoảng 70 lần so với một kết quả dương tính giả, vì vậy bạn nên chấp nhận nhiều cảnh báo sai hơn. Con số 0,9 không phải là khẳng định về độ chính xác, 0,5 chỉ là một con số tùy ý, còn việc tự động từ chối sẽ thay thế một loại lỗi này bằng một loại lỗi khác tồi tệ hơn.
Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học