Ở Bài 2, bạn đã viết một câu hỏi xác định trạng thái (predicate) gồm một điều kiện và một xác suất. Cách này phù hợp cho các trường hợp kiểu như "đánh dấu" hoặc "không đánh dấu". Tuy nhiên, nó không còn hiệu quả khi câu hỏi thực tế là "mục này thuộc về nhóm nào trong 5 nhóm cho trước?". Nếu sử dụng 5 câu hỏi xác định trạng thái riêng biệt, kết quả có thể trả về "có" cho cả 3 nhóm – đó chính là lúc bạn cần đến "câu hỏi lựa chọn".
Một câu hỏi lựa chọn sẽ trả về chính xác một giá trị trong số các tùy chọn mà bạn cung cấp, kèm theo xác suất cho mỗi tùy chọn và một chỉ số độ tin cậy riêng biệt. Theo quy tắc từ OpenAI, loại câu hỏi này nên được dùng cho các danh mục không có thứ tự cụ thể, chẳng hạn như những phòng ban hoặc loại hình nội dung. (Đối với các danh mục có thứ tự – ví dụ như mức độ nghiêm trọng – chúng ta sẽ tìm hiểu ở Bài 4).
Cấu trúc của một câu hỏi lựa chọn
Dưới đây là ví dụ từ chính OpenAI về việc phân loại khiếu nại của khách hàng. Hãy quan sát kỹ danh sách các lựa chọn: mỗi tùy chọn đều bao gồm một giá trị và một phần mô tả.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'
Và câu trả lời mang tính minh họa từ người hướng dẫn:
Các lựa chọn chính là những giá trị mà bạn thiết lập. Mô hình không thể tự ý tạo thêm một danh mục thứ năm.
Xác suất là sự phân bổ trên các lựa chọn của bạn; tổng các xác suất này xấp xỉ bằng 1.
Độ tin cậy (confidence) là một thông số riêng biệt. Trong ví dụ của nhà cung cấp, giá trị này là 0,93, trong khi xác suất cao nhất là 0,95. Đây là hai con số khác nhau và tài liệu hướng dẫn của OpenAI không định nghĩa thông số này dựa trên thông số kia. Bài 5 sẽ đi sâu hơn vào vấn đề này; trước mắt, hãy coi cả hai đều là các giá trị ước tính.
Quy tắc thiết kế 1: Các lựa chọn phải khác biệt, mỗi lựa chọn đều cần có mô tả
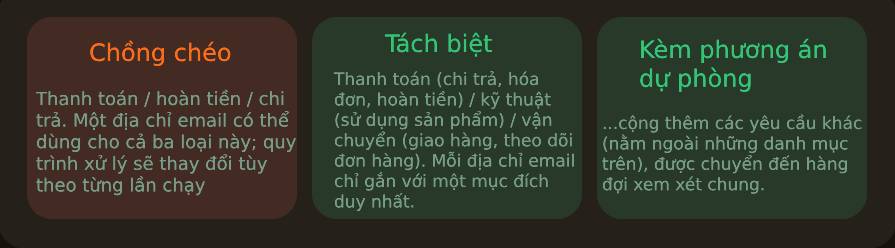
Hướng dẫn từ OpenAI: "Hãy sử dụng các giá trị và mô tả riêng biệt để giải thích trường hợp áp dụng cho từng lựa chọn", đồng thời "đảm bảo mỗi lựa chọn mang một ý nghĩa khác biệt". Sự chồng chéo chính là điều cần tránh. Nếu cả "thanh toán" (billing) và "hoàn tiền" (refunds) đều là các lựa chọn, thì mỗi email yêu cầu hoàn tiền sẽ trở thành một tình huống khó phân định, giống như việc tung đồng xu để quyết định vậy.
Kiểm tra nhanh: Tại sao việc thêm mục "hoàn tiền" (refunds) bên cạnh mục "thanh toán" (billing) - vốn đã có mô tả bao gồm cả "các khoản thanh toán, hóa đơn và hoàn tiền" - lại là một lựa chọn không tốt?
Trả lời: Hai mục này bị chồng chéo, dẫn đến việc cùng một dữ liệu đầu vào có thể khớp với cả hai, khiến quy trình điều hướng trở nên thiếu ổn định.
Quy tắc thiết kế 2: Luôn bao gồm phương án dự phòng
OpenAI khuyến nghị rõ ràng: "Hãy thêm một phương án dự phòng, chẳng hạn như 'khác' (other), cho những trường hợp dữ liệu đầu vào không nằm trong các danh mục đã định nghĩa. Ứng dụng của bạn có thể chuyển các kết quả này vào hàng đợi để con người xem xét".
Nếu thiếu phương án dự phòng, mô hình sẽ buộc phải xếp các dữ liệu bất ngờ - như đơn xin việc, thư rác (spam), hoặc tin nhắn bằng ngôn ngữ khác - vào một danh mục không phù hợp. Phương án dự phòng cũng chính là điểm khởi đầu cho quy trình kiểm duyệt thủ công (Bài 6).
Quy tắc thiết kế 3: Lưu ý rằng một danh mục hợp lệ vẫn có thể là danh mục sai
API đảm bảo rằng kết quả trả về sẽ nằm trong danh sách các giá trị bạn đã thiết lập, nhưng không đảm bảo đó là giá trị chính xác. Dưới đây là hai lưu ý rút ra từ tuần đầu tiên triển khai bản beta (do cộng đồng người dùng phát hiện thay vì được nhà cung cấp tài liệu hóa chính thức), vì vậy hãy coi đây là những điểm cần kiểm thử thay vì các sự thật hiển nhiên:
Một nhà phát triển trên diễn đàn OpenAI đã thực hiện thử nghiệm với một mô hình tương tự như "tung đồng xu bị lệch". Kết quả cho thấy trong khi phiên bản dự đoán (predicate) đạt tỷ lệ 70% như kỳ vọng, thì phiên bản lựa chọn lại cho kết quả "mặt ngửa" tới 98% số lần. Điều này cho thấy xác suất của các lựa chọn có thể chênh lệch cực đoan hơn so với xác suất thực tế.
Cũng nhà phát triển này phát hiện ra rằng việc thay đổi thứ tự các tùy chọn sẽ làm thay đổi xác suất kết quả.
Cách xử lý: Đối với bất kỳ câu hỏi lựa chọn nào quan trọng, hãy xây dựng một tập dữ liệu nhỏ đã được gán nhãn (Bài 5), thống kê tần suất mô hình đưa ra câu trả lời tự tin nhưng lại sai, đồng thời cân nhắc kiểm thử với các thứ tự tùy chọn khác nhau. Một tài liệu hướng dẫn kỹ thuật từ Wavect đã tóm tắt rất hay: "Một danh mục hợp lệ vẫn có thể là danh mục sai".
Kiểm tra nhanh: API trả về kết quả "choice": "shipping" với xác suất 0,88 cho một email phản hồi về sản phẩm bị hỏng cần được hoàn tiền. Câu trả lời này có hợp lệ không? Nó có chính xác không?
Trả lời: Hợp lệ, đúng, đó là một trong các lựa chọn của bạn. Đúng vậy, có lẽ không phải lúc nào cũng chính xác. Tính hợp lệ được đảm bảo; còn độ chính xác thì cần phải được đo lường.
Thử ngay: Thiết kế câu hỏi phân loại của bạn
Cách thực hiện: Mở ChatGPT, Claude hoặc Gemini trong một cuộc trò chuyện mới.
Cách sao chép: Nhấn Cmd+A rồi Cmd+C (trên Mac) hoặc Ctrl+A rồi Ctrl+C (trên Windows) bên trong khung văn bản.
Hãy giúp tôi thiết kế một câu hỏi dạng lựa chọn cho Decisions API của OpenAI. API này
trả về chính xác một trong các giá trị mà tôi cung cấp, kèm theo xác suất cho mỗi lựa chọn
và một chỉ số độ tin cậy riêng biệt. Theo quy định của OpenAI: hãy sử dụng các giá trị riêng biệt
cùng với phần mô tả giải thích trường hợp áp dụng cho từng giá trị; đồng thời, cần bao gồm một lựa chọn dự phòng
như "khác" (other) để chuyển các trường hợp đó vào hàng đợi xem xét.
Nội dung cần phân loại: [ví dụ: email gửi đến một công ty logistics gồm 12 nhân viên]
Các đích đến (hàng đợi hoặc bộ phận): [liệt kê các hàng đợi hoặc bộ phận thực tế của bạn]
Các trường hợp không khớp với bất kỳ hàng đợi nào: [ví dụ: đơn xin việc, thư rác (spam), chào hàng từ nhà cung cấp]
Hãy cung cấp cho tôi:
1. Danh sách các lựa chọn ở định dạng JSON: mỗi lựa chọn gồm một "value" (giá trị) viết theo kiểu snake_case
và một "description" (mô tả) ngắn gọn giải thích trường hợp áp dụng. Nếu mô tả của hai lựa chọn nào bị chồng chéo,
hãy đánh dấu lại để gộp chúng hoặc điều chỉnh cho rõ ràng hơn.
2. Một lựa chọn dự phòng và hàng đợi xem xét tương ứng.
3. 5 email thử nghiệm (2 email rõ ràng, 2 email khó phân loại/nằm ở ranh giới, và một email thuộc nhóm "khác")
cùng với kết quả lựa chọn dự kiến cho từng email.
Kết quả bạn nhận được: Một danh sách các lựa chọn (JSON) kèm mô tả, một lựa chọn dự phòng và 5 trường hợp thử nghiệm.
Cách sử dụng kết quả: Dán danh sách các lựa chọn vào "Bảng thông số quyết định" (Decision Spec Sheet) của bạn, trong một mục "choice" mới. Hãy lưu lại 5 email thử nghiệm đó; chúng chính là điểm khởi đầu cho tập dữ liệu được gán nhãn của bạn.
Nếu kết quả chưa như ý: Nếu vẫn còn hai lựa chọn bị chồng chéo, hãy phản hồi: "Hãy gộp các lựa chọn có thể cùng áp dụng cho một email lại với nhau".
Những điểm chính cần lưu ý
Câu hỏi dạng "lựa chọn" sẽ trả về một trong các giá trị bạn đã thiết lập, phân phối xác suất cho từng lựa chọn và một chỉ số độ tin cậy riêng biệt. Sử dụng cho các danh mục không có thứ tự.
Viết mô tả cho từng tùy chọn và đảm bảo các tùy chọn khác biệt với nhau.
Luôn thêm một phương án dự phòng (ví dụ: "khác") và gửi đi để đánh giá.
Hợp lệ không có nghĩa là đúng. Hãy thống kê các trường hợp hệ thống tự tin đưa ra câu trả lời sai trên một tập dữ liệu đã được gán nhãn; thứ tự những tùy chọn có thể gây ảnh hưởng đến kết quả.
Câu 1:
Đâu KHÔNG PHẢI là lý do hợp lý để viết mô tả cho mỗi giá trị lựa chọn?
GIẢI THÍCH:
Mô hình không bao giờ tự tạo ra giá trị mới; nó chỉ trả về một trong các giá trị mà bạn đã cung cấp. Hướng dẫn từ OpenAI là sử dụng "các giá trị riêng biệt cùng với phần mô tả giải thích thời điểm áp dụng cho từng tùy chọn". Sự chồng chéo giữa các tùy chọn thường là nguyên nhân dẫn đến tình trạng định tuyến không ổn định.
Câu 2:
Kết quả trả về cho một câu hỏi dạng lựa chọn như sau: tùy chọn "billing" (thanh toán); xác suất: thanh toán 0,95 / kỹ thuật 0,02 / vận chuyển 0,01 / khác 0,02; độ tin cậy (confidence) là 0,93. Phát biểu nào sau đây là chính xác?
GIẢI THÍCH:
Theo hướng dẫn của OpenAI, các câu hỏi dạng lựa chọn sẽ trả về một phân bổ xác suất cùng với một trường dữ liệu riêng biệt gọi là "độ tin cậy" (confidence). Bạn nên thiết lập các ngưỡng (threshold) dựa trên những ví dụ đã được gán nhãn trước đó. Cả hai giá trị này đều là các ước tính. Trong ví dụ từ nhà cung cấp, hai con số này khác nhau (0,95 và 0,93); OpenAI mô tả chúng là các trường dữ liệu riêng biệt nhưng không nêu rõ công thức liên kết giữa chúng.
Câu 3:
Tình huống: Một công ty logistics gồm 12 nhân viên sử dụng câu hỏi dạng lựa chọn để phân loại email gửi đến, với các tùy chọn gồm: Thanh toán (billing), kỹ thuật (technical) và vận chuyển (shipping). Một khách hàng gửi email hỏi về cơ hội việc làm. Kết quả nào dễ xảy ra nhất và cách khắc phục là gì?
GIẢI THÍCH:
Câu hỏi dạng lựa chọn chỉ cho phép chọn một trong các giá trị mà bạn cung cấp. Hướng dẫn từ OpenAI khuyến nghị nên thêm một tùy chọn dự phòng (ví dụ: "other" (khác)) để xử lý các trường hợp không nằm trong những danh mục đã định sẵn, đồng thời chuyển các kết quả đó đến một hàng đợi xử lý chung.
Theo Nghị định 147/2024/ND-CP, bạn cần xác thực tài khoản trước khi sử dụng tính năng này. Chúng tôi sẽ gửi mã xác thực qua SMS hoặc Zalo tới số điện thoại mà bạn nhập dưới đây:
 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học