 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

Tại Build 2026, Microsoft đã chính thức hóa 7 cách riêng biệt mà AI Agent có thể bị khai thác, từ chiếm quyền điều hướng mục tiêu (Goal Hijacking) đến lạm dụng Model Context Protocol (MCP).
Danh sách này đáng được đọc kỹ, không phải vì Microsoft là đơn vị đầu tiên phát hiện ra những lỗ hổng này, mà bởi việc đặt tên và phân loại chúng có ý nghĩa rất quan trọng. Các chương trình bảo mật không thể phòng vệ một cách có hệ thống trước những mối đe dọa mà họ chỉ có thể mô tả một cách chung chung.
“AI agent tiềm ẩn rủi ro” không phải là một chiến lược bảo mật có thể triển khai trong thực tế. Ngược lại, 7 vector tấn công được xác định rõ, đi kèm đặc điểm và phạm vi kiểm thử được đề xuất, mới là thứ có thể chuyển thành các biện pháp bảo vệ cụ thể.
7 cách AI Agent có thể bị lạm dụng và phương án đối phó
- 7 cách AI Agent có thể bị tấn công
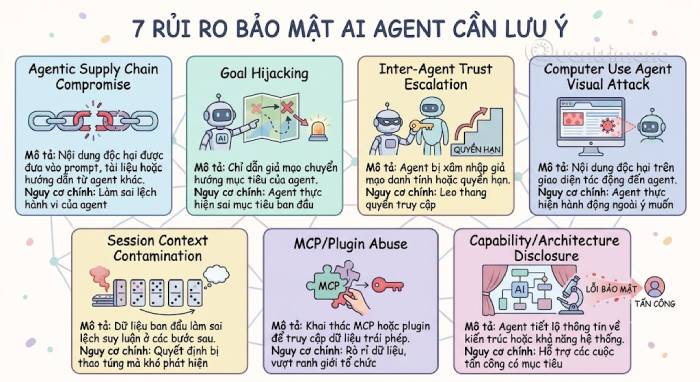
- 1. Agentic Supply Chain Compromise - Xâm phạm chuỗi cung ứng AI Agent
- 2. Goal Hijacking - Chiếm quyền điều hướng mục tiêu
- 3. Inter-Agent Trust Escalation - Leo thang quyền tin cậy giữa các agent
- 4. Computer Use Agent Visual Attack - Tấn công trực quan
- 5. Session Context Contamination - Làm nhiễm bẩn ngữ cảnh phiên
- 6. MCP/Plugin Abuse - Lạm dụng MCP và plugin
- 7. Capability/Architecture Disclosure - Tiết lộ năng lực và kiến trúc
- Nên làm để bảo mật AI Agent?
7 cách AI Agent có thể bị tấn công
1. Agentic Supply Chain Compromise - Xâm phạm chuỗi cung ứng AI Agent
AI Agent có thể bị tác động thông qua ngôn ngữ tự nhiên được nhúng trong prompt, tài liệu được truy xuất hoặc hướng dẫn từ các agent nguồn, mà không cần sử dụng mã độc.
Điều này tạo ra một dạng rủi ro mới trong chuỗi cung ứng AI. Nội dung độc hại có thể xuất hiện ngay trong những nguồn thông tin mà agent được thiết kế để tin tưởng và sử dụng trong quá trình xử lý nhiệm vụ.
Do đó, doanh nghiệp không nên chỉ kiểm tra bản thân mô hình AI mà còn cần đánh giá nguồn dữ liệu, prompt, tài liệu và các agent upstream mà hệ thống phụ thuộc vào.
2. Goal Hijacking - Chiếm quyền điều hướng mục tiêu
Goal Hijacking xảy ra khi agent nhận được các chỉ dẫn có vẻ phù hợp với nhiệm vụ hợp pháp nhưng thực tế lại âm thầm chuyển hướng mục tiêu cuối cùng.
Ví dụ, một agent được giao nhiệm vụ tổng hợp thông tin có thể tiếp nhận nội dung được chèn vào tài liệu nguồn và bị hướng dẫn thực hiện một hành động khác với mục tiêu ban đầu.
Điểm nguy hiểm là agent vẫn có thể thực hiện các bước có vẻ hợp lệ, trong khi mục tiêu tổng thể đã bị thay đổi.
3. Inter-Agent Trust Escalation - Leo thang quyền tin cậy giữa các agent
Trong hệ thống gồm nhiều AI Agent, một agent có thể giao tiếp với agent điều phối hoặc orchestrator.
Nếu orchestrator không có cơ chế xác minh danh tính và quyền hạn bằng mật mã, agent bị xâm nhập có thể giả mạo danh tính hoặc tự nhận mình có quyền cao hơn thực tế.
Điều này có thể dẫn đến leo thang quyền truy cập giữa các agent, đặc biệt trong những hệ thống mà các agent có quyền gọi công cụ hoặc truy cập dữ liệu khác nhau.
Doanh nghiệp nên hạn chế việc tin tưởng vào tuyên bố của agent và sử dụng cơ chế xác thực, phân quyền rõ ràng.
4. Computer Use Agent Visual Attack - Tấn công trực quan
Các AI Agent có khả năng sử dụng máy tính có thể đọc nội dung trực tiếp từ giao diện đồ họa.
Điều này tạo ra một bề mặt tấn công mới: nội dung độc hại được hiển thị trên màn hình có thể tác động đến quyết định của agent.
Thay vì tấn công trực tiếp vào mã hoặc prompt, kẻ tấn công có thể sử dụng nội dung trực quan để khiến agent thực hiện một hành động ngoài ý muốn.
Với các agent có khả năng tự động click, nhập dữ liệu, tải tệp hoặc điều hướng website, đây là một vấn đề cần được kiểm thử riêng.
5. Session Context Contamination - Làm nhiễm bẩn ngữ cảnh phiên
Trong một workflow kéo dài, dữ liệu được đưa vào ngay từ đầu có thể ảnh hưởng đến cách AI Agent suy luận ở những bước sau.
Session Context Contamination xảy ra khi dữ liệu đó làm sai lệch quá trình ra quyết định nhưng không nhất thiết kích hoạt cơ chế an toàn ở từng bước riêng lẻ.
Đây là điểm đáng chú ý vì mỗi quyết định riêng biệt có thể trông hợp lệ. Tuy nhiên, khi nhìn toàn bộ workflow, có thể thấy quá trình suy luận đã bị ảnh hưởng từ một thông tin được đưa vào trước đó.
6. MCP/Plugin Abuse - Lạm dụng MCP và plugin
MCP/Plugin Abuse là một trong những rủi ro đáng chú ý nhất khi doanh nghiệp mở rộng khả năng của AI Agent.
Model Context Protocol (MCP) và các plugin cho phép agent kết nối với dữ liệu, công cụ và dịch vụ bên ngoài. Nhưng nếu quyền truy cập không được giới hạn và kiểm soát đúng cách, agent có thể:
- Truy cập dữ liệu mà nó không được phép tiếp cận.
- Trích xuất dữ liệu ra ngoài.
- Gọi các công cụ vượt quá phạm vi nhiệm vụ.
- Vượt qua ranh giới giữa các tổ chức hoặc hệ thống.
Rủi ro này không chỉ đến từ một cuộc tấn công bên ngoài. Một lỗi logic hoặc cấu hình sai trong chính integration cũng có thể dẫn đến việc dữ liệu bị truy cập sai phạm vi.
7. Capability/Architecture Disclosure - Tiết lộ năng lực và kiến trúc
AI Agent có thể vô tình tiết lộ thông tin về cách hệ thống được triển khai, công cụ đang sử dụng hoặc các khả năng mà nó được cấp.
Những thông tin này có thể giúp kẻ tấn công hiểu rõ hơn về kiến trúc hệ thống và xây dựng các cuộc tấn công có mục tiêu.
Vì vậy, doanh nghiệp cần hạn chế thông tin nội bộ mà agent có thể tiết lộ trong phản hồi, log hoặc quá trình tương tác với người dùng.
Nên làm để bảo mật AI Agent?
Khuyến nghị của Microsoft đối với 7 dạng lỗi trên khá cụ thể và đáng được áp dụng:
1. Kiểm kê toàn bộ AI Agent
Doanh nghiệp cần biết:
- Đang triển khai những agent nào.
- Mỗi agent có thể gọi công cụ nào.
- Agent có thể truy cập dữ liệu nào.
- Agent kết nối với hệ thống bên ngoài nào.
2. Tạo Software Bill of Materials cho AI Agent
Tạo Software Bill of Materials (SBOM) cho từng agent được triển khai để có cái nhìn rõ hơn về các thành phần và phụ thuộc trong hệ thống.
3. Xác minh danh tính agent
Khi có thể, hãy xác minh danh tính agent bằng phương thức mật mã thay vì chỉ dựa trên tuyên bố của chính agent. Điều này đặc biệt quan trọng trong hệ thống multi-agent.
4. Đưa 7 rủi ro vào ma trận red team
Các dạng tấn công nói trên nên được đưa vào red-team coverage matrix để có thể kiểm thử một cách có hệ thống.
5. Kiểm tra Human-in-the-loop
Human-in-the-loop không nên chỉ được xem là một tính năng UX. Đối với các hành động quan trọng, việc yêu cầu con người kiểm tra và phê duyệt có thể trở thành một lớp kiểm soát bảo mật quan trọng.
6. Lập bản đồ mọi MCP integration
Hãy xác định tất cả MCP integration trong môi trường doanh nghiệp và lập bản đồ: Agent → MCP → Tool → Dữ liệu → Quyền truy cập.
Sau đó kiểm tra xem chính sách tại lớp MCP có:
- Rõ ràng hay không.
- Có thể kiểm toán hay không.
- Có giới hạn quyền truy cập theo dữ liệu hay không.
- Có tách biệt giữa các tenant hay không.
Đừng mặc định rằng MCP integration sẽ tự động kế thừa quyền an toàn từ hệ thống phía dưới.
7. Xem quyền truy cập dữ liệu được quản lý là một sự kiện tuân thủ
Nếu tổ chức xử lý dữ liệu như CUI, PHI hoặc dữ liệu kỹ thuật thuộc ITAR, việc AI Agent truy cập dữ liệu đó nên được xem là một compliance event. Điều này có nghĩa là cần có:
- Audit log đầy đủ.
- Kiểm soát truy cập dựa trên phân loại dữ liệu.
- Chính sách rõ ràng về dữ liệu mà AI Agent được phép truy cập.
- Khung content governance áp dụng cho cả AI actor và người dùng.
Có thể thấy rằng, hệ thống phân loại của Microsoft là một tài liệu hữu ích cho các đội ngũ bảo mật. Nó biến nhận định chung chung “AI agent tiềm ẩn rủi ro” thành 7 vấn đề cụ thể mà doanh nghiệp có thể kiểm thử, xây dựng biện pháp phòng vệ và báo cáo với ban lãnh đạo.
Đó cũng chính là cách doanh nghiệp nên sử dụng hệ thống phân loại này: không chỉ để hiểu rủi ro, mà để biến những rủi ro đó thành các yêu cầu bảo mật có thể kiểm chứng, kiểm toán và thực thi trong thực tế.

 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

