AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

OpenAI đã ra mắt GPT-6.1 Sol tại sự kiện DevDay ngày 29/9, mang đến bản nâng cấp cho model tầm trung của hãng. Theo OpenAI, model này đạt hiệu suất gần với flagship GPT-6 Astra nhưng chi phí token chỉ bằng một phần năm. Trước đó một tuần, Anthropic giới thiệu Claude Opus 5.5, với định vị mang lại hiệu suất ngang Claude Fable 5.1 nhưng giảm 40% chi phí.
Cả hai model đều hướng đến mục tiêu tối ưu hiệu suất và chi phí. Trong bài công bố của mình, OpenAI trực tiếp nhắc đến Opus 5.5 và tuyên bố GPT-6.1 Sol có kết quả tốt hơn trong các tác vụ nghiệp vụ và xử lý tài liệu, đồng thời giảm đáng kể chi phí cho mỗi tác vụ. Tuy nhiên, các biểu đồ do chính OpenAI công bố cho thấy bức tranh phức tạp hơn: model nào tốt hơn còn phụ thuộc vào mức độ suy luận (effort setting) được sử dụng.
Bài viết này tập trung so sánh chi tiết GPT-6.1 Sol và Claude Opus 5.5 vì OpenAI đã trực tiếp đặt hai model lên bàn cân trong thông báo ra mắt.
GPT-6.1 Sol là gì?
GPT-6.1 Sol là model suy luận tầm trung thuộc dòng GPT-6 của OpenAI, được phát hành ngày 29/9/2026 nhằm nâng cấp GPT-6 Sol.
Điểm nổi bật của model này là khả năng đạt kết quả gần với GPT-6 Astra trong các tác vụ lập trình, điều khiển máy tính và công việc chuyên môn, nhưng có mức giá thấp hơn đáng kể. Chi phí đọc input đã lưu trong bộ nhớ đệm (cached input) cũng được tối ưu, phù hợp với các AI agent thường xuyên sử dụng lại ngữ cảnh giữa nhiều yêu cầu.
Claude Opus 5.5 là gì?
Claude Opus 5.5 là model flagship thuộc dòng Opus của Anthropic, đồng thời là model đầu tiên trong gia đình Claude 5.5.
Anthropic định hướng Opus 5.5 cho các tác vụ lập trình bằng AI agent kéo dài và công việc tri thức chuyên sâu. Hãng cho biết model có thể đạt hiệu suất ngang Claude Fable 5.1 trong phần lớn tác vụ với chi phí thấp hơn, đồng thời luôn bật cơ chế suy luận thích ứng (adaptive thinking).
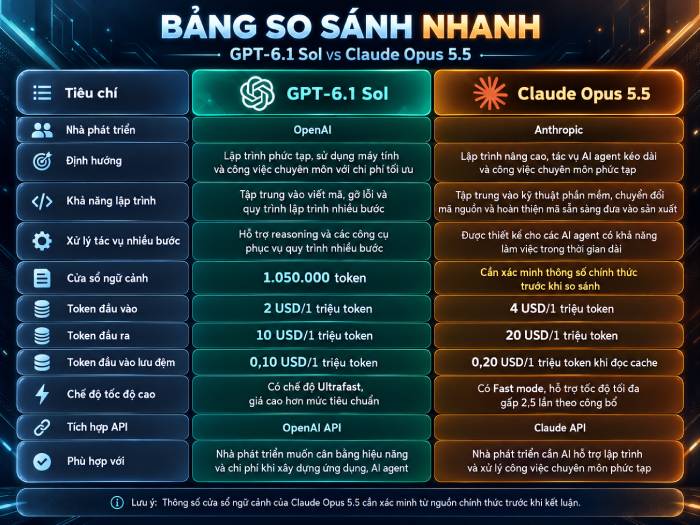
GPT-6.1 Sol vs Claude Opus 5.5: So sánh chi tiết
GPT-6.1 Sol và Opus 5.5 chỉ có ba benchmark được công bố chung, tất cả đều xuất hiện trong biểu đồ ra mắt của OpenAI. Opus 5.5 đạt điểm cao nhất ở hai trong ba bài kiểm tra này, trong khi GPT-6.1 Sol hoàn thành cả ba với chi phí cho mỗi tác vụ thấp hơn từ 2 đến 5 lần.
| Tiêu chí | GPT-6.1 Sol | Claude Opus 5.5 |
| AutomationBench (điểm cao nhất, chi phí/tác vụ) | 36,1% ở mức Max, 0,30 USD | 42,5% ở mức Max, 1,44 USD |
| GDP.pdf (điểm cao nhất, chi phí/tác vụ) | 32,0% ở mức High, 0,35 USD | 28,8% ở mức High, 0,83 USD |
| Terminal-Bench Science 0.1 (mức Max) | 57,0%, 5,47 USD | 63,3%, 23,21 USD |
| DeepSWE v1.1 | 75,2% ở mức High | Chưa công bố |
| Terminal-Bench 4.0 | Chưa công bố | 66,4% ở mức Max |
| Điều khiển máy tính | 71,4% trên OSWorld 2.0 offline (Max) | 81,8% trên OSWorld 2.1 |
| Cửa sổ ngữ cảnh / đầu ra tối đa | 1,05 triệu / 128K token | 1 triệu / 128K token |
| Các mức effort | Low, Medium (mặc định), High, XHigh, Max | Low, Medium (mặc định), High, XHigh, Max |
Ba hàng benchmark đầu tiên lấy từ biểu đồ của OpenAI, trong đó kết quả của Claude được ghi chú là “Opus 5.5 w/ fallbacks” (Opus 5.5 có cơ chế chuyển sang model khác khi cần). Các thông tin còn lại do mỗi nhà cung cấp tự công bố về model của mình.
Khả năng xử lý quy trình nghiệp vụ và tài liệu
Đây là lĩnh vực OpenAI chọn để so sánh trực tiếp hai model, và cũng là nơi mức độ suy luận quyết định model nào có lợi thế.
Theo thông tin nổi bật trong bài công bố của OpenAI, GPT-6.1 Sol đạt điểm cao hơn Opus 5.5 khoảng 2,2 điểm phần trăm trên AutomationBench. Đây là bài kiểm tra của Zapier, đánh giá khả năng AI agent hoàn thành các quy trình nhiều bước trên hàng chục công cụ phục vụ công việc.
Nhận định này đúng khi cả hai model được đặt ở mức effort Medium. GPT-6.1 Sol đạt 31,7%, với chi phí 0,19 USD mỗi tác vụ, trong khi Opus 5.5 đạt 29,5%, với chi phí 0,65 USD.
Tuy nhiên, khi tăng mức suy luận lên Max, thứ hạng đảo ngược. Opus 5.5 đạt 42,5%, vượt cả GPT-6 Astra, còn GPT-6.1 Sol đạt tối đa 36,1%.
Đổi lại, Opus 5.5 có chi phí mỗi tác vụ gần gấp 5 lần. Vì vậy, câu hỏi quan trọng là liệu mức tăng khoảng 6 điểm phần trăm về tỷ lệ hoàn thành quy trình có đáng với khoản chi phí bổ sung hay không.
- Với chatbot hỗ trợ khách hàng xử lý hàng nghìn yêu cầu, chi phí thấp hơn có thể quan trọng hơn một vài điểm phần trăm hiệu suất.
- Với quy trình tài chính mà một lần chạy thất bại sẽ buộc nhân viên phải làm lại từ đầu, mức độ chính xác cao hơn có thể đáng để đầu tư.
Kết luận: GPT-6.1 Sol có lợi thế về chi phí khi xử lý tài liệu và tự động hóa các công việc thường ngày. Opus 5.5 phù hợp hơn khi bạn cần tối đa hóa tỷ lệ thành công ở những quy trình phức tạp nhất.
Khả năng lập trình và xử lý tác vụ khoa học
Hiện chưa có benchmark lập trình chung để so sánh trực tiếp hai model, vì vậy các kết quả do mỗi nhà cung cấp công bố cần được xem xét riêng biệt.
OpenAI cho biết GPT-6.1 Sol đạt hiệu suất ngang GPT-6 Astra trên DeepSWE v1.1, bài kiểm tra khả năng giải quyết các tác vụ kỹ thuật kéo dài trên những codebase thực tế. Trong khi đó, Anthropic báo cáo Opus 5.5 dẫn trước GPT-6 Astra trên Terminal-Bench 4.0 và FrontierCode.
Trong một thử nghiệm thực tế trước đó, GPT-6 Sol - phiên bản tiền nhiệm - vượt Opus 5.5 khi xây dựng một trò chơi Tetris, với chi phí mỗi lần chạy chưa bằng một phần ba. Dựa trên kết quả này, có cơ sở để kỳ vọng GPT-6.1 Sol tiếp tục thể hiện tốt, nhưng vẫn cần các thử nghiệm đối đầu trực tiếp để xác nhận. Bạn có thể xem thêm bài so sánh GPT-6 Sol và Claude Opus 5.5 để biết chi tiết.
Khả năng điều khiển máy tính
Hiện chưa thể so sánh công bằng hai model trong lĩnh vực này.
OpenAI công bố kết quả GPT-6.1 Sol trên bộ dữ liệu offline của OSWorld 2.0, cho thấy model chỉ kém GPT-6 Astra 2,1 điểm. Trong khi đó, Anthropic công bố kết quả Opus 5.5 trên OSWorld 2.1 - phiên bản mới hơn với các tác vụ khác biệt.
Không nhà cung cấp nào công bố kết quả của model mình trên cùng phiên bản benchmark với đối thủ. Vì vậy, những con số trong bảng trên không thể hiện một phép so sánh trực tiếp.
Tạm thời, nên xem khả năng điều khiển máy tính là tiêu chí chưa có kết luận rõ ràng cho đến khi cả hai model được kiểm tra trên cùng một bộ dữ liệu.
Cơ chế bảo vệ và giới hạn API
Trên thực tế, Opus 5.5 có nhiều hạn chế hơn trong một số lĩnh vực. Anthropic chuyển phần lớn tác vụ an ninh mạng sang Opus 4.8, trừ khi người dùng tham gia Cyber Verification Program. Các tác vụ liên quan đến sinh học cũng có cơ chế chuyển hướng tương tự.
Đây cũng là lý do các biểu đồ của OpenAI ghi chú kết quả Claude là “with fallbacks”, tức kết quả có sử dụng cơ chế chuyển sang model khác khi cần.
Với GPT-6.1 Sol, những hạn chế đáng chú ý chủ yếu nằm ở API. Model không có mức effort None hoặc Minimal, đồng thời chỉ hỗ trợ gọi công cụ thông qua Responses API chứ không phải Chat Completions.
Trong khi đó, Opus 5.5 luôn bật adaptive thinking và không chấp nhận yêu cầu ép buộc sử dụng công cụ (forced tool use).
Vì vậy, sự khác biệt quan trọng nhất tùy thuộc vào nhu cầu:
- Với đội ngũ an ninh: Cơ chế chuyển hướng tác vụ của Opus 5.5 có thể ảnh hưởng trực tiếp đến quy trình làm việc.
- Với nhà phát triển đang chuyển đổi mã nguồn: Những thay đổi về API của GPT-6.1 Sol là yếu tố cần kiểm tra trước khi triển khai.
GPT-6.1 Sol và Claude Opus 5.5: Chi phí
Ở mức giá tiêu chuẩn, GPT-6.1 Sol có giá bằng đúng một nửa Opus 5.5 trên mỗi loại token, cho đến khi prompt vượt ngưỡng 272K token đầu vào.
So sánh giá token
| Loại chi phí | GPT-6.1 Sol | Claude Opus 5.5 |
| Input, mỗi 1 triệu token | 2 USD | 4 USD |
| Output, mỗi 1 triệu token | 10 USD | 20 USD |
| Đọc input từ cache, mỗi 1 triệu token | 0,10 USD | 0,20 USD |
| Ghi cache, mỗi 1 triệu token | 2,50 USD | 5 USD (5 phút), 8 USD (1 giờ) |
| Phụ phí ngữ cảnh dài | Với input vượt 272K token: input và cache tính gấp 2 lần, output gấp 1,5 lần cho toàn bộ yêu cầu | Không có |
| Giảm giá Batch API | 50% | 50% |
| Chế độ Fast | Gấp 2 lần giá tiêu chuẩn | 8 USD / 40 USD cho mỗi 1 triệu token |
Mức giá của GPT-6.1 Sol bằng 50% Opus 5.5 trên input, output và token đọc từ cache. Do đó, với các prompt có kích thước thông thường, phép so sánh khá đơn giản: GPT-6.1 Sol có giá bằng một nửa.
Cả hai model đều tính token dùng cho suy luận vào lượng output. Điều này đặc biệt đáng lưu ý với Opus 5.5 vì cơ chế suy luận của model không thể tắt hoàn toàn.
Chi phí cho các khối lượng công việc thực tế
| Khối lượng công việc | GPT-6.1 Sol | Claude Opus 5.5 | Chênh lệch |
| Trợ lý cân bằng: 1 triệu input / 250K output | 4,50 USD | 9 USD | Tiết kiệm 4,50 USD (50%) |
| Truy xuất dữ liệu, mỗi yêu cầu dưới 272K: 10 triệu input / 1 triệu output | 30 USD | 60 USD | Tiết kiệm 30 USD (50%) |
| Truy xuất dữ liệu, mỗi yêu cầu vượt 272K: 10 triệu input / 1 triệu output | 55 USD | 60 USD | Tiết kiệm 5 USD (khoảng 8%) |
Các tổng chi phí trên được tính bằng cách lấy lượng token chia cho một triệu rồi nhân với đơn giá tương ứng, sau đó cộng chi phí input và output ở mức giá tiêu chuẩn.
- Trợ lý AI với khối lượng cân bằng: Đây là trường hợp thể hiện rõ lợi thế giá bằng một nửa của GPT-6.1 Sol, phù hợp với nhiều ứng dụng chatbot và AI agent.
- Truy xuất dữ liệu dưới ngưỡng: Chi phí vẫn chỉ bằng một nửa. Những hệ thống RAG giữ từng prompt ở kích thước nhỏ có thể tận dụng đầy đủ mức tiết kiệm này.
- Truy xuất dữ liệu vượt ngưỡng: Phụ phí khiến giá input của GPT-6.1 Sol tăng gấp đôi, ngang với mức giá tiêu chuẩn của Opus 5.5. Khoảng cách chi phí vì thế thu hẹp đáng kể. Nếu prompt của bạn thường chứa toàn bộ codebase hoặc lượng dữ liệu rất lớn, hãy lập ngân sách với giả định chi phí của hai model gần tương đương.
Lưu ý rằng hai nhà cung cấp sử dụng bộ tokenizer khác nhau và chưa công bố số lượng token cho cùng một khối lượng công việc. Vì vậy, các con số trên nên được xem là phép so sánh dựa trên đơn giá, không phải hóa đơn thực tế cho một tác vụ cụ thể.
Nên chọn GPT-6.1 Sol hay Claude Opus 5.5?
Với phần lớn đội ngũ, yếu tố quyết định là chi phí trên mỗi tác vụ. Theo các kết quả do OpenAI công bố, GPT-6.1 Sol có thể đạt một số kết quả benchmark với chi phí chỉ bằng khoảng một phần năm đến một nửa Opus 5.5.
Tuy nhiên, có ba trường hợp cần cân nhắc kỹ: prompt rất dài, những tác vụ khó đòi hỏi tỷ lệ thành công cao nhất và môi trường triển khai.
Nên chọn GPT-6.1 Sol nếu:
- Bạn vận hành AI agent với số lượng lớn. Trong bài kiểm tra tự động hóa quy trình nghiệp vụ, GPT-6.1 Sol vượt Opus 5.5 ở mức effort Medium với chi phí mỗi tác vụ chỉ bằng khoảng một phần ba. Khoản tiết kiệm sẽ tích lũy đáng kể khi hệ thống chạy hàng nghìn lần.
- Bạn thường xử lý tài liệu dày đặc thông tin. GPT-6.1 Sol dẫn trước Opus 5.5 trên benchmark PDF do OpenAI công bố ở mọi mức effort, đồng thời có chi phí thấp hơn một nửa.
- Đội ngũ của bạn đã sử dụng ChatGPT Work hoặc Codex. Đây là model OpenAI đề xuất cho các tác vụ lập trình phức tạp và công việc dựa trên AI agent trong những môi trường này.
- Bạn thường xuyên sử dụng lại prompt hệ thống hoặc ngữ cảnh dài. Giá đọc input từ cache chỉ 0,10 USD cho mỗi triệu token giúp giảm chi phí đáng kể trong các vòng lặp agent sử dụng lại dữ liệu, miễn là mỗi prompt không vượt quá 272K token.
Nên chọn Claude Opus 5.5 nếu:
- Prompt của bạn thường vượt 272K token. Phụ phí ngữ cảnh dài của GPT-6.1 Sol làm giảm phần lớn lợi thế về giá, trong khi Opus 5.5 không áp dụng phụ phí này.
- Một lần chạy thất bại gây tốn kém hơn chi phí token. Ở mức effort Max, Opus 5.5 đạt điểm AutomationBench cao nhất trong biểu đồ của OpenAI, vượt cả GPT-6 Astra.
- Bạn triển khai thông qua Cursor, Amazon Bedrock hoặc Google Vertex AI. Opus 5.5 được liệt kê trên cả ba nền tảng, trong khi GPT-6.1 Sol chưa xuất hiện trong tài liệu của Cursor hoặc Vertex AI tại thời điểm bài viết được đề cập.
- Bạn muốn cơ chế bảo vệ thận trọng của Anthropic cho các agent chạy tự động. Các biện pháp bảo vệ của Anthropic chuyển những tác vụ có rủi ro cao liên quan đến an ninh mạng và sinh học sang model khác, thay vì cố thực hiện chúng bằng Opus 5.5.
 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học