 AI
 Hướng dẫn AI
 Claude
 ChatGPT
 Gemini
 Prompt
 AI Tools
 Workflow
 Công nghệ
 Học IT
 Tiện ích

Triển khai mô hình ngôn ngữ lớn (LLM) không chỉ đơn giản là tải một mô hình AI về và chạy thử. Để đưa mô hình vào sử dụng thực tế, bạn cần lựa chọn hạ tầng GPU phù hợp, cài đặt công cụ phục vụ mô hình (serving engine), thiết lập API và xây dựng cơ chế mở rộng khi lượng người dùng tăng lên.
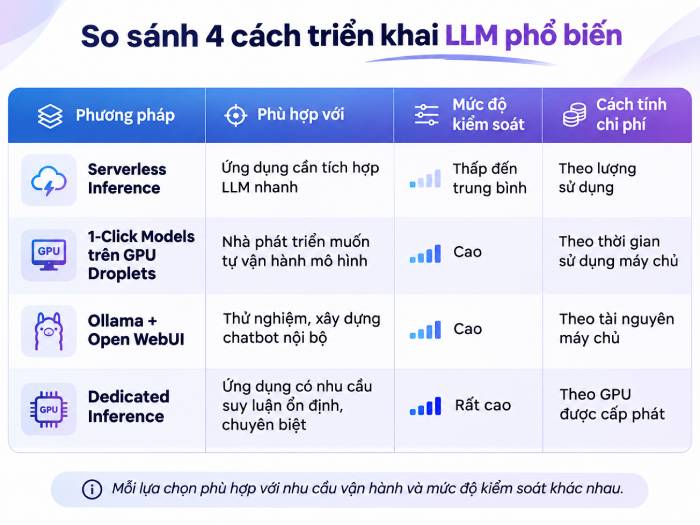
Hiện nay, có nhiều cách triển khai LLM, từ sử dụng API được quản lý sẵn đến tự lưu trữ mô hình trên máy chủ GPU hoặc xây dựng endpoint suy luận chuyên dụng. Mỗi phương pháp có ưu điểm riêng về chi phí, khả năng kiểm soát, hiệu suất và mức độ phức tạp khi vận hành.
Trong bài viết này, hãy cùng tìm hiểu 4 cách triển khai LLM phổ biến trong năm 2027, cùng ưu điểm, hạn chế và thời điểm nên sử dụng từng phương pháp. Các ví dụ tập trung vào những giải pháp của DigitalOcean, giúp bạn hình dung rõ hơn cách lựa chọn mô hình triển khai phù hợp với nhu cầu thực tế.
4 cách triển khai LLM đơn giản
- Triển khai LLM là gì?
- Serverless Inference: Triển khai LLM thông qua API được quản lý
- 1-Click Models trên GPU Droplets: Tự triển khai LLM trên máy chủ GPU
- Ollama + Open WebUI: Tự xây dựng chatbot LLM riêng
- Dedicated Inference: Triển khai LLM trên hạ tầng GPU chuyên dụng
- Nên chọn phương pháp triển khai LLM nào?
- Nên chọn mô hình LLM nào để bắt đầu?
- Khi nào nên chuyển sang phương pháp triển khai LLM phức tạp hơn?
- Nên triển khai LLM trên nền tảng nào?
Triển khai LLM là gì?
Triển khai LLM (LLM deployment) là quá trình đưa một mô hình ngôn ngữ lớn vào môi trường vận hành để ứng dụng hoặc người dùng có thể gửi yêu cầu và nhận kết quả từ mô hình.
Một hệ thống triển khai LLM thường bao gồm bốn thành phần chính:
- Trọng số mô hình (Model weights): Các tham số đã được huấn luyện, quyết định khả năng xử lý và tạo phản hồi của mô hình.
- Công cụ phục vụ mô hình (Inference engine): Phần mềm thực hiện quá trình suy luận, chẳng hạn như vLLM hoặc Ollama.
- Lớp API: Cung cấp giao diện để ứng dụng, website hoặc dịch vụ khác gửi yêu cầu đến mô hình.
- Hạ tầng GPU/CPU: Tài nguyên tính toán cần thiết để chạy mô hình và xử lý yêu cầu của người dùng.
Ngoài ra, môi trường triển khai còn cần các thành phần hỗ trợ như driver GPU, phần mềm tương thích và quy tắc mở rộng tài nguyên. Chẳng hạn, GPU NVIDIA thường sử dụng CUDA, trong khi GPU AMD có thể sử dụng ROCm.
Việc lựa chọn đúng phương pháp triển khai giúp cân bằng giữa hiệu suất, chi phí và khả năng kiểm soát hệ thống.
Serverless Inference: Triển khai LLM thông qua API được quản lý
Serverless Inference là lựa chọn phù hợp nếu bạn muốn tích hợp khả năng xử lý của LLM vào ứng dụng mà không phải tự thiết lập và quản lý máy chủ GPU.
Thay vì triển khai mô hình trên hạ tầng riêng, bạn gửi yêu cầu đến API do nhà cung cấp quản lý. Nhà cung cấp chịu trách nhiệm vận hành hạ tầng và xử lý quá trình suy luận.
DigitalOcean Serverless Inference cung cấp quyền truy cập đến nhiều mô hình AI thông qua API, bao gồm các dòng mô hình như GPT, Claude, Llama, DeepSeek, Qwen và Kimi. Nhờ đó, nhà phát triển có thể thử nghiệm nhiều mô hình mà không cần tự cài đặt từng mô hình trên máy chủ.
Ưu điểm của Serverless Inference
- Triển khai nhanh: Không cần tự cấu hình GPU, driver hoặc inference engine.
- Dễ tích hợp: Ứng dụng có thể gửi yêu cầu và nhận phản hồi thông qua API.
- Linh hoạt khi lựa chọn mô hình: Có thể thử nghiệm nhiều mô hình khác nhau tùy theo yêu cầu của dự án.
- Thanh toán theo mức sử dụng: Chi phí được tính dựa trên lượng token xử lý thông qua số dư trả trước, thay vì phải duy trì một máy chủ GPU riêng.
- Tối ưu chi phí: Tính năng lưu bộ nhớ đệm prompt (prompt caching) có thể giúp giảm chi phí xử lý đối với những phần nội dung được sử dụng lặp lại. Theo tài liệu của DigitalOcean, mức tiết kiệm có thể lên đến 90% trong những trường hợp đủ điều kiện.
DigitalOcean cũng giới thiệu Inference Router ở trạng thái public preview, hỗ trợ định tuyến yêu cầu suy luận. Ngoài ra, tính năng BYOM (Bring Your Own Model) cho phép đưa mô hình của riêng bạn vào sử dụng thông qua các nguồn như Hugging Face hoặc DigitalOcean Spaces với định dạng Safetensors.
Khi nào nên sử dụng Serverless Inference?
Phương pháp này phù hợp nếu bạn:
- Muốn tích hợp LLM vào ứng dụng mà không phải quản lý hạ tầng.
- Đang phát triển chatbot, trợ lý AI hoặc công cụ xử lý văn bản.
- Cần thử nghiệm nhiều mô hình trước khi quyết định lựa chọn.
- Có lượng yêu cầu thay đổi theo thời điểm và không muốn duy trì GPU hoạt động liên tục.
Hạn chế cần lưu ý: Bạn có ít quyền kiểm soát hơn đối với hạ tầng và cách vận hành mô hình so với phương pháp tự lưu trữ. Ngoài ra, chi phí theo mức sử dụng cần được theo dõi khi ứng dụng phát sinh lượng yêu cầu lớn.
1-Click Models trên GPU Droplets: Tự triển khai LLM trên máy chủ GPU
Nếu muốn kiểm soát nhiều hơn đối với mô hình và môi trường vận hành, bạn có thể triển khai LLM trên GPU Droplets.
DigitalOcean cung cấp các GPU Droplets với tùy chọn 1-Click Models. Thay vì phải cài đặt từng thành phần từ đầu, bạn có thể bắt đầu với môi trường đã được chuẩn bị sẵn, bao gồm Docker và vLLM.
Quy trình triển khai này giúp rút ngắn thời gian thiết lập ban đầu, đồng thời cho phép bạn chủ động lựa chọn mô hình từ Hugging Face.
Cách hoạt động
Hệ thống Inference Ready, được cấu hình sẵn các thành phần cần thiết để chạy mô hình. Sau khi khởi tạo GPU Droplet, bạn có thể tải mô hình tương thích và sử dụng vLLM để phục vụ các yêu cầu suy luận.
Một số công nghệ tối ưu hiệu suất có thể được sử dụng trong môi trường này gồm:
- Speculative decoding: Kỹ thuật hỗ trợ tăng tốc quá trình sinh token.
- FP8 quantization: Phương pháp lượng tử hóa giúp giảm yêu cầu bộ nhớ và tối ưu hiệu suất trong những trường hợp tương thích.
- vLLM: Công cụ phục vụ LLM, hỗ trợ xử lý yêu cầu suy luận hiệu quả.
Ưu điểm của GPU Droplets
- Chủ động lựa chọn mô hình: Có thể tải và chạy các mô hình phù hợp từ Hugging Face.
- Kiểm soát môi trường: Bạn có thể điều chỉnh cấu hình và cách vận hành mô hình.
- Tối ưu hiệu suất: Có thể sử dụng các kỹ thuật như speculative decoding và FP8 quantization nếu mô hình, phần cứng hỗ trợ.
- Tính phí theo thời gian: Chi phí GPU Droplet được tính theo thời gian sử dụng máy chủ.
Hạn chế cần lưu ý
Phương pháp này đòi hỏi bạn phải chủ động quản lý nhiều thành phần hơn. Bạn cần theo dõi tình trạng máy chủ, cập nhật phần mềm, xử lý lỗi và thiết lập cơ chế mở rộng khi nhu cầu tăng lên.
Ngoài ra, theo mô hình triển khai được mô tả, mỗi Droplet chạy một mô hình. Nếu cần vận hành nhiều mô hình, bạn có thể phải tạo thêm tài nguyên tương ứng.
Khi nào nên sử dụng GPU Droplets?
Đây là lựa chọn phù hợp nếu bạn:
- Muốn tự lưu trữ và kiểm soát mô hình LLM.
- Cần sử dụng mô hình mã nguồn mở hoặc mô hình tùy chỉnh.
- Muốn điều chỉnh cấu hình suy luận theo yêu cầu ứng dụng.
- Có đội ngũ kỹ thuật đủ khả năng quản lý máy chủ và phần mềm.
Ollama + Open WebUI: Tự xây dựng chatbot LLM riêng
Nếu mục tiêu của bạn là thử nghiệm LLM hoặc xây dựng giao diện chatbot nội bộ, kết hợp Ollama và Open WebUI là một phương pháp tương đối đơn giản.
Ollama giúp tải và chạy các mô hình ngôn ngữ lớn, trong khi Open WebUI cung cấp giao diện trò chuyện tương tự ChatGPT. Khi kết hợp hai công cụ này trên một máy chủ, bạn có thể tạo môi trường sử dụng LLM riêng mà không cần phát triển giao diện chatbot từ đầu.
Cách triển khai Ollama và Open WebUI
DigitalOcean cung cấp tùy chọn 1-Click App cho Ollama và Open WebUI trên Droplet. Quy trình cơ bản gồm:
- Tạo Droplet và chọn ứng dụng Ollama + Open WebUI.
- Khởi chạy máy chủ với cấu hình tài nguyên phù hợp.
- Truy cập giao diện Open WebUI.
- Thiết lập tài khoản quản trị.
- Tải mô hình cần sử dụng thông qua Ollama.
- Bắt đầu trò chuyện và thử nghiệm mô hình.
Với những mô hình nhỏ, bạn có thể sử dụng CPU Droplet để thử nghiệm. Tuy nhiên, nếu muốn chạy mô hình lớn hơn hoặc cần tốc độ phản hồi tốt hơn, GPU Droplet sẽ là lựa chọn phù hợp hơn.
Ưu điểm của Ollama + Open WebUI
- Dễ bắt đầu: Không cần tự xây dựng giao diện chatbot.
- Tự lưu trữ: Mô hình và giao diện được vận hành trên hạ tầng do bạn quản lý.
- Phù hợp để thử nghiệm: Có thể nhanh chóng kiểm tra khả năng của nhiều mô hình khác nhau.
- Có thể sử dụng trong nội bộ: Phù hợp để xây dựng chatbot phục vụ nhóm hoặc doanh nghiệp.
Hạn chế cần lưu ý
Hiệu suất phụ thuộc đáng kể vào cấu hình máy chủ và kích thước mô hình. Nếu sử dụng CPU với mô hình lớn, tốc độ phản hồi có thể chậm.
Bạn cũng cần tự quản lý máy chủ, cập nhật phần mềm và thiết lập bảo mật. Đặc biệt, nên cấu hình HTTPS và kiểm soát quyền truy cập trước khi đưa chatbot vào sử dụng thực tế.
Khi nào nên sử dụng Ollama + Open WebUI?
Phương pháp này phù hợp nếu bạn:
- Muốn tạo chatbot AI riêng để sử dụng nội bộ.
- Cần thử nghiệm mô hình mã nguồn mở.
- Muốn xây dựng nguyên mẫu (prototype) trước khi phát triển sản phẩm hoàn chỉnh.
- Muốn tìm hiểu cách tự lưu trữ và vận hành LLM.
Dedicated Inference: Triển khai LLM trên hạ tầng GPU chuyên dụng
Khi ứng dụng đã có lượng truy cập ổn định hoặc yêu cầu hiệu suất suy luận cụ thể, bạn có thể cân nhắc Dedicated Inference.
Khác với Serverless Inference, phương pháp này cấp phát GPU chuyên dụng cho nhu cầu triển khai của bạn. Bạn có thể lựa chọn mô hình, loại GPU, khu vực triển khai và số lượng tài nguyên cần sử dụng.
DigitalOcean Dedicated Inference hỗ trợ triển khai endpoint suy luận riêng, có thể ở chế độ riêng tư hoặc công khai. Endpoint tương thích với định dạng API của OpenAI, giúp việc tích hợp vào ứng dụng hiện có thuận tiện hơn.
Cách hoạt động
Dedicated Inference sử dụng GPU được dành riêng cho hệ thống của bạn. Nền tảng hỗ trợ vLLM và llm-d trên Kubernetes để phục vụ mô hình và quản lý quá trình triển khai.
Bạn có thể cấu hình:
- Mô hình cần triển khai.
- Loại GPU sử dụng.
- Khu vực đặt hạ tầng.
- Số lượng GPU được cấp phát.
- Endpoint riêng tư hoặc công khai.
Theo thông tin trong tài liệu DigitalOcean được sử dụng cho bài viết, Dedicated Inference có các khu vực triển khai như ATL1, NYC2 và TOR1.
Ưu điểm của Dedicated Inference
- Tài nguyên GPU chuyên dụng: Không phải chia sẻ tài nguyên GPU được cấp phát với các workload khác theo mô hình dịch vụ này.
- Khả năng kiểm soát cao: Chủ động lựa chọn mô hình, GPU và cấu hình triển khai.
- Endpoint riêng: Có thể thiết lập endpoint công khai hoặc riêng tư tùy theo nhu cầu.
- Phù hợp với tải ổn định: Có thể đáp ứng các ứng dụng cần năng lực suy luận được duy trì thường xuyên.
Hạn chế cần lưu ý
Dedicated Inference có thể phát sinh chi phí ngay cả khi không có yêu cầu suy luận, bởi bạn thanh toán theo GPU-hour cho tài nguyên được cấp phát.
Vì vậy, phương pháp này không phải lúc nào cũng tiết kiệm đối với ứng dụng có lượng truy cập thấp hoặc thay đổi thất thường. Bạn cũng cần có kiến thức kỹ thuật để quản lý mô hình, endpoint và môi trường triển khai.
Khi nào nên sử dụng Dedicated Inference?
Đây là lựa chọn đáng cân nhắc nếu bạn:
- Đang vận hành ứng dụng AI có lượng yêu cầu ổn định.
- Cần kiểm soát tài nguyên GPU và hiệu suất suy luận.
- Muốn triển khai endpoint riêng cho sản phẩm hoặc dịch vụ.
- Có yêu cầu cụ thể về khu vực triển khai và cấu hình hạ tầng.
Nên chọn phương pháp triển khai LLM nào?
Không có một phương pháp triển khai LLM phù hợp với mọi dự án. Lựa chọn tốt nhất phụ thuộc vào lưu lượng truy cập, ngân sách, yêu cầu hiệu suất và khả năng quản lý hạ tầng của đội ngũ. Bạn có thể tham khảo các tình huống sau:
| Nhu cầu | Phương pháp nên cân nhắc | Lý do |
| Muốn tích hợp LLM nhanh vào ứng dụng | Serverless Inference | Không cần tự quản lý máy chủ GPU |
| Muốn tự chạy mô hình mã nguồn mở | GPU Droplets | Chủ động lựa chọn mô hình và cấu hình |
| Muốn tạo chatbot nội bộ hoặc nguyên mẫu | Ollama + Open WebUI | Có sẵn công cụ chạy mô hình và giao diện trò chuyện |
| Có lượng yêu cầu ổn định, cần GPU chuyên dụng | Dedicated Inference | Có tài nguyên GPU được cấp phát riêng |
Ngoài ra, bạn nên cân nhắc ba yếu tố quan trọng trước khi quyết định.
1. Lưu lượng truy cập
Nếu ứng dụng chỉ phát sinh yêu cầu không thường xuyên, dịch vụ tính phí theo mức sử dụng có thể giúp tránh chi phí duy trì GPU liên tục.
Ngược lại, nếu hệ thống xử lý yêu cầu thường xuyên và có lưu lượng tương đối ổn định, việc cấp phát GPU chuyên dụng có thể giúp bạn chủ động hơn về tài nguyên.
2. Chi phí vận hành
Đừng chỉ so sánh giá GPU hoặc giá mỗi token. Hãy tính cả chi phí lưu trữ, thời gian máy chủ hoạt động, bảo trì, giám sát và nhân lực kỹ thuật.
Ví dụ, Serverless Inference giảm gánh nặng quản lý hạ tầng nhưng chi phí có thể tăng theo lượng yêu cầu. Trong khi đó, Dedicated Inference có chi phí GPU-hour ngay cả khi tài nguyên không được sử dụng hết.
3. Mức độ kiểm soát
Nếu cần tự lựa chọn mô hình, điều chỉnh cấu hình và kiểm soát môi trường chạy, các phương pháp tự lưu trữ sẽ phù hợp hơn.
Nếu ưu tiên tốc độ triển khai và muốn giảm công việc vận hành, API được quản lý sẵn là lựa chọn đơn giản hơn.
Nên chọn mô hình LLM nào để bắt đầu?
Sau khi chọn phương pháp triển khai, bước tiếp theo là lựa chọn mô hình phù hợp.
Một sai lầm phổ biến là bắt đầu ngay với mô hình lớn nhất. Trên thực tế, bạn nên thử nghiệm bằng mô hình nhỏ trước để đánh giá chất lượng phản hồi, tốc độ suy luận và mức tiêu thụ tài nguyên.
Một số mô hình được đề cập trong bài viết nguồn gồm:
- Ministral 3 14B: Mô hình có 14 tỷ tham số, có thể được cân nhắc cho những tác vụ cần năng lực xử lý cao hơn các mô hình nhỏ.
- Nemotron Nano 12B v2 VL: Mô hình đa phương thức, hỗ trợ xử lý cả nội dung hình ảnh và văn bản.
- gpt-oss-120b: Mô hình có quy mô lớn, phù hợp để đánh giá trong những kịch bản cần năng lực xử lý mạnh hơn.
Nếu muốn tự lưu trữ, bạn có thể bắt đầu với các mô hình mã nguồn mở có quy mô dưới 10 tỷ tham số. Những mô hình nhỏ thường có yêu cầu phần cứng thấp hơn, giúp quá trình thử nghiệm dễ tiếp cận hơn.
Khi lựa chọn, hãy đánh giá mô hình dựa trên các tiêu chí:
- Chất lượng đầu ra đối với tác vụ thực tế.
- Kích thước mô hình và dung lượng bộ nhớ cần thiết.
- Tốc độ phản hồi và thông lượng xử lý.
- Khả năng tương thích với GPU và inference engine.
- Giấy phép sử dụng và điều kiện triển khai thương mại.
Khi nào nên chuyển sang phương pháp triển khai LLM phức tạp hơn?
Bạn không nhất thiết phải bắt đầu với Kubernetes, nhiều GPU hoặc hệ thống suy luận chuyên dụng. Một giải pháp đơn giản có thể đáp ứng tốt nhu cầu trong giai đoạn thử nghiệm và phát triển sản phẩm ban đầu.
Tuy nhiên, khi ứng dụng phát triển, bạn có thể cần chuyển sang kiến trúc triển khai phức tạp hơn. Một số dấu hiệu cho thấy đã đến lúc nâng cấp gồm:
- Chi phí API tăng cao và khó dự đoán: Khi lượng yêu cầu tăng, bạn nên đánh giá lại giữa việc tiếp tục sử dụng API được quản lý và tự lưu trữ mô hình.
- Yêu cầu nghiêm ngặt về độ trễ và thông lượng: Nếu ứng dụng cần phản hồi nhanh hoặc xử lý nhiều yêu cầu đồng thời, bạn có thể cần tối ưu inference engine và GPU.
- Cần vận hành nhiều mô hình hoặc bản sao: Khi một máy chủ không còn đáp ứng được nhu cầu, việc triển khai nhiều bản sao (replicas) hoặc nhiều mô hình có thể trở nên cần thiết.
- Cần giám sát LLM chuyên sâu: Khi đưa AI vào sản phẩm thực tế, bạn nên theo dõi độ trễ, thông lượng, lỗi, mức sử dụng token và chất lượng đầu ra.
Việc nâng cấp nên dựa trên dữ liệu vận hành thực tế, thay vì lựa chọn kiến trúc phức tạp ngay từ đầu.
Nên triển khai LLM trên nền tảng nào?
Ngoài DigitalOcean, bạn có thể cân nhắc các nhóm nền tảng khác nhau tùy theo nhu cầu:
Nhà cung cấp dịch vụ đám mây quy mô lớn: AWS và các nền tảng hyperscaler khác cung cấp hệ sinh thái hạ tầng đa dạng, phù hợp với doanh nghiệp đã sử dụng dịch vụ đám mây tương ứng.
Nhà cung cấp GPU chuyên biệt: RunPod là một ví dụ về nền tảng tập trung vào tài nguyên GPU, phù hợp với những dự án cần thuê GPU để chạy mô hình.
Nền tảng đám mây như DigitalOcean: Cung cấp nhiều lựa chọn từ API được quản lý đến GPU Droplets và hạ tầng suy luận chuyên dụng.
Khi so sánh, hãy xem xét không chỉ giá thuê GPU mà còn khả năng triển khai, khu vực máy chủ, công cụ quản lý, tài liệu kỹ thuật và mức độ phù hợp với hệ thống hiện tại.


 AI
 Copilot
 Grok
 Thư viện Prompt
 Hướng dẫn AI
 Công nghệ
 Ứng dụng
 Hệ thống
 Game - Trò chơi
 iPhone
 Android
 Làng Công nghệ
 Học CNTT
 Hàm Excel
 Học Python
 Download
 Video
 Cuộc sống
 Khoa học

